# ZeroXin Blog - Full Text
> ZeroXin Blog 是一个面向人类与 AI 阅读器的静态技术文档库,内容涵盖前端开发、AI、DevOps、Linux、网络技术与开源项目。全站以语义化 HTML、Markdown、llms.txt、Atom 和 Sitemap 提供可检索正文。
Canonical site: https://www.zeroxin.xin/
Articles: 41
This file is generated from the source Markdown during the Hexo build.
---
# AI Disk Cleaner - AI 驱动的智能磁盘清理助手
- Canonical: https://www.zeroxin.xin/2026/07/31/ai-disk-cleaner-introduction/
- Markdown: https://www.zeroxin.xin/2026/07/31/ai-disk-cleaner-introduction.md
- Published: 2026-07-31T00:00:00+08:00
- Updated: 2026-07-31T18:24:34+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: AI, 开源项目, 磁盘清理, Windows, LLM
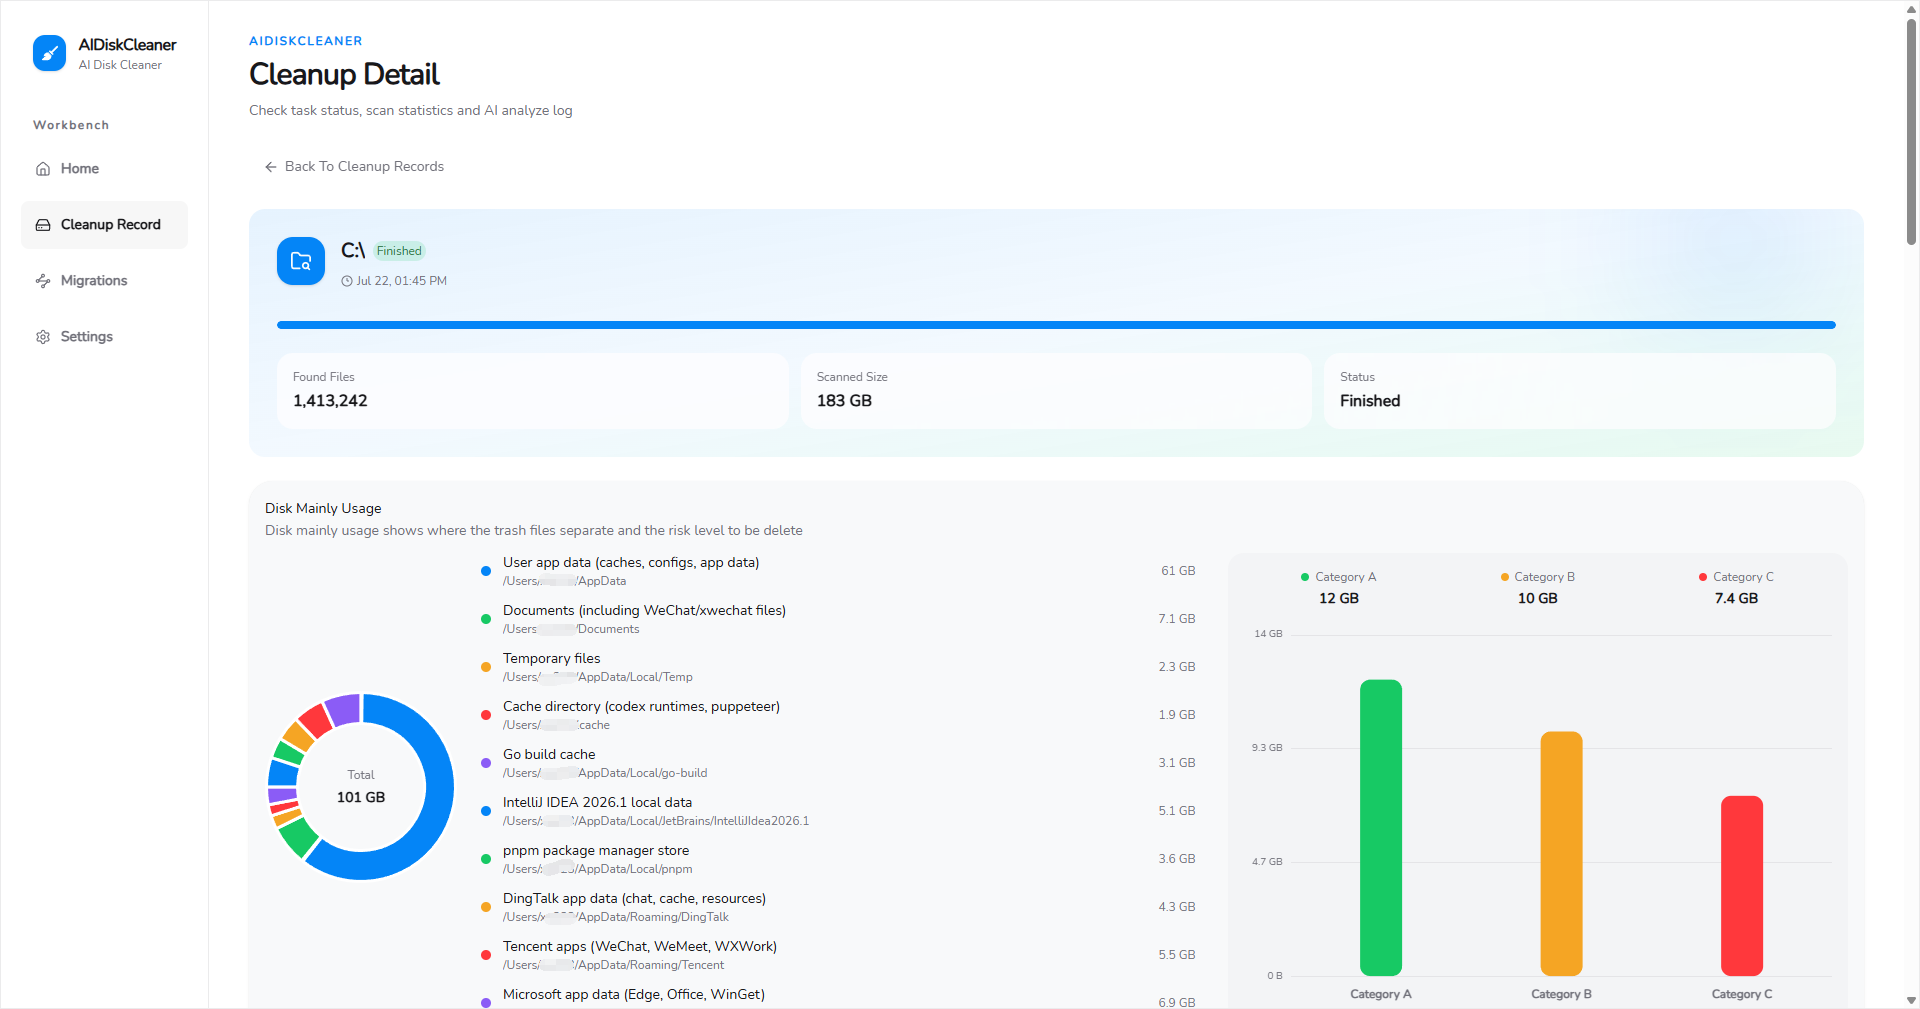
AI Disk Cleaner 是一款 AI 驱动的智能磁盘清理助手,利用大语言模型分析磁盘占用情况,自动识别可删除的垃圾文件,并提供迁移管理功能,帮助用户高效释放磁盘空间。
在日常使用电脑的过程中,磁盘空间不足是一个常见的问题。传统的磁盘清理工具往往只能删除已知类型的临时文件或缓存,无法智能地识别哪些文件是真正可以安全删除的。**AI Disk Cleaner** 正是为了解决这个问题而诞生的 — 一款利用大语言模型(LLM)进行智能磁盘分析的开源工具。
## 项目简介
[AI Disk Cleaner](https://github.com/vudsen/ai-disk-cleaner) 是一款 AI 驱动的智能磁盘清理助手,通过 LLM 对磁盘文件树进行智能分析,自动识别可删除的垃圾文件,并以清晰的方式呈现分析结果。项目使用 Go 语言开发,基于 Wails 框架构建跨平台桌面应用。
## 核心功能
### 🤖 LLM 智能分析
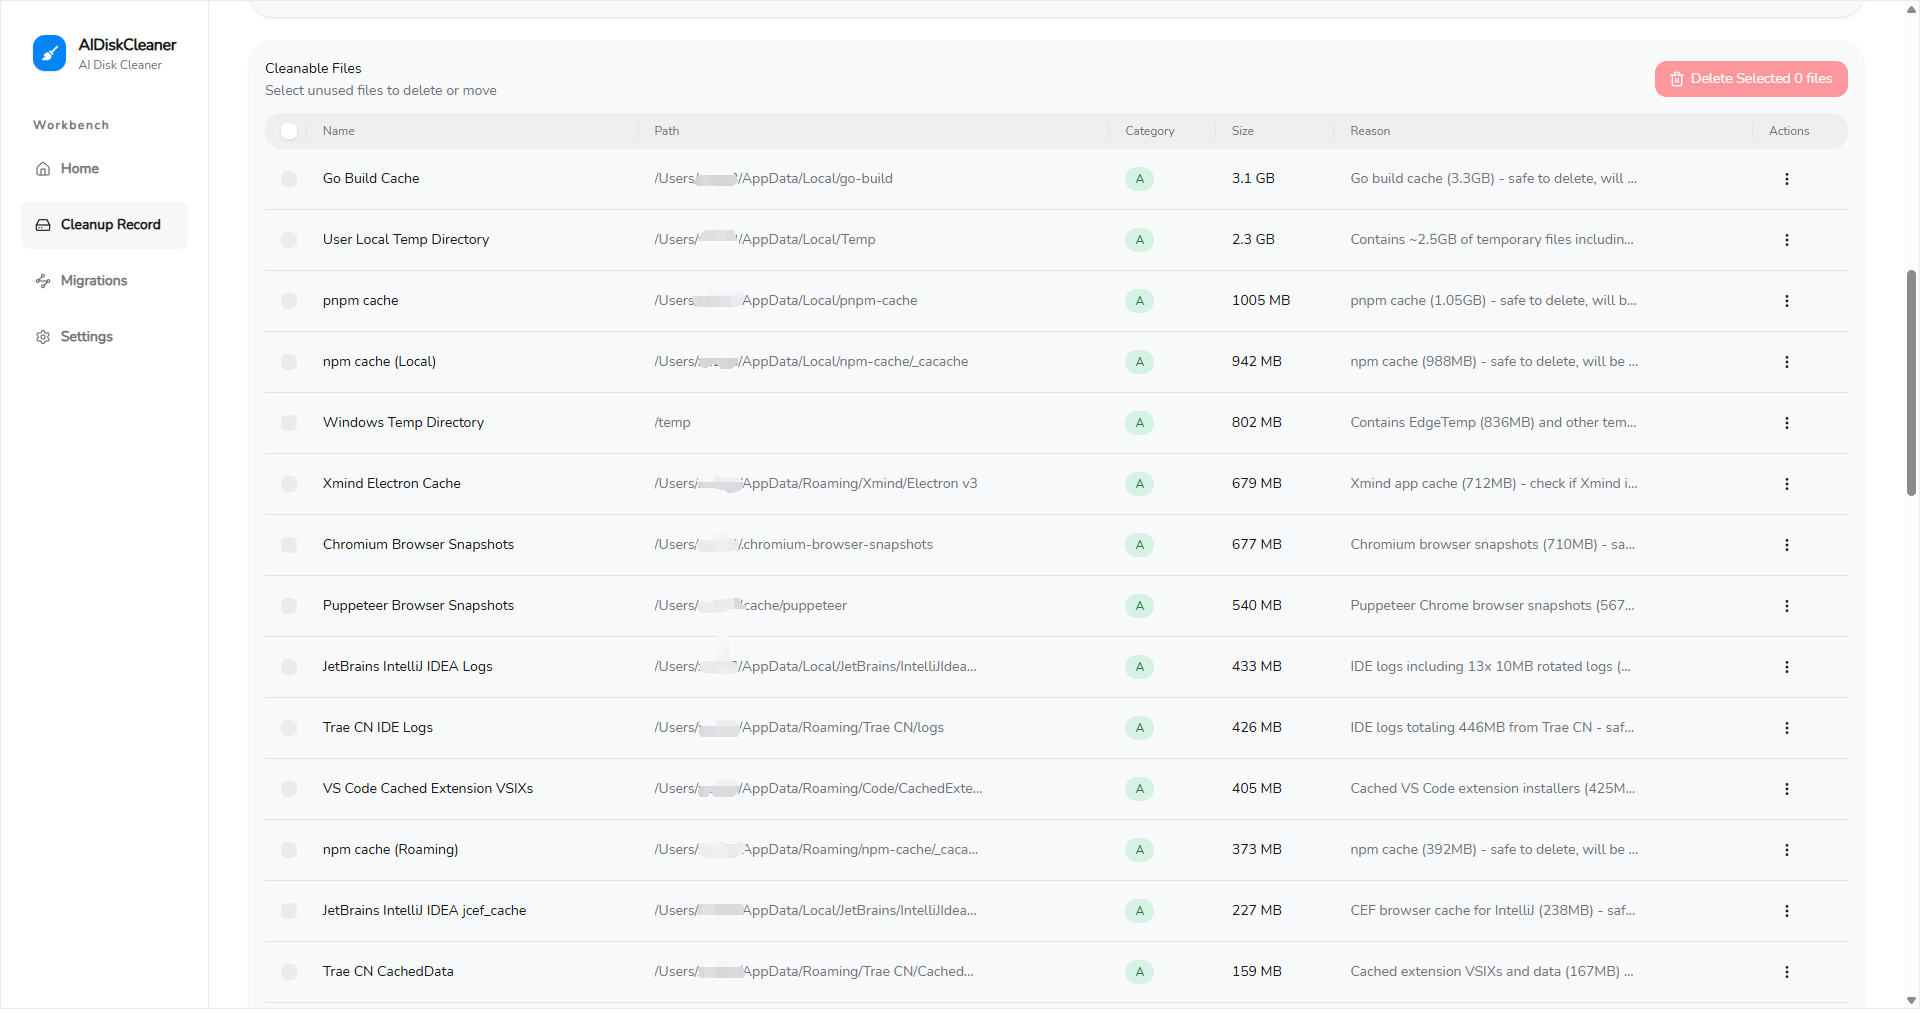
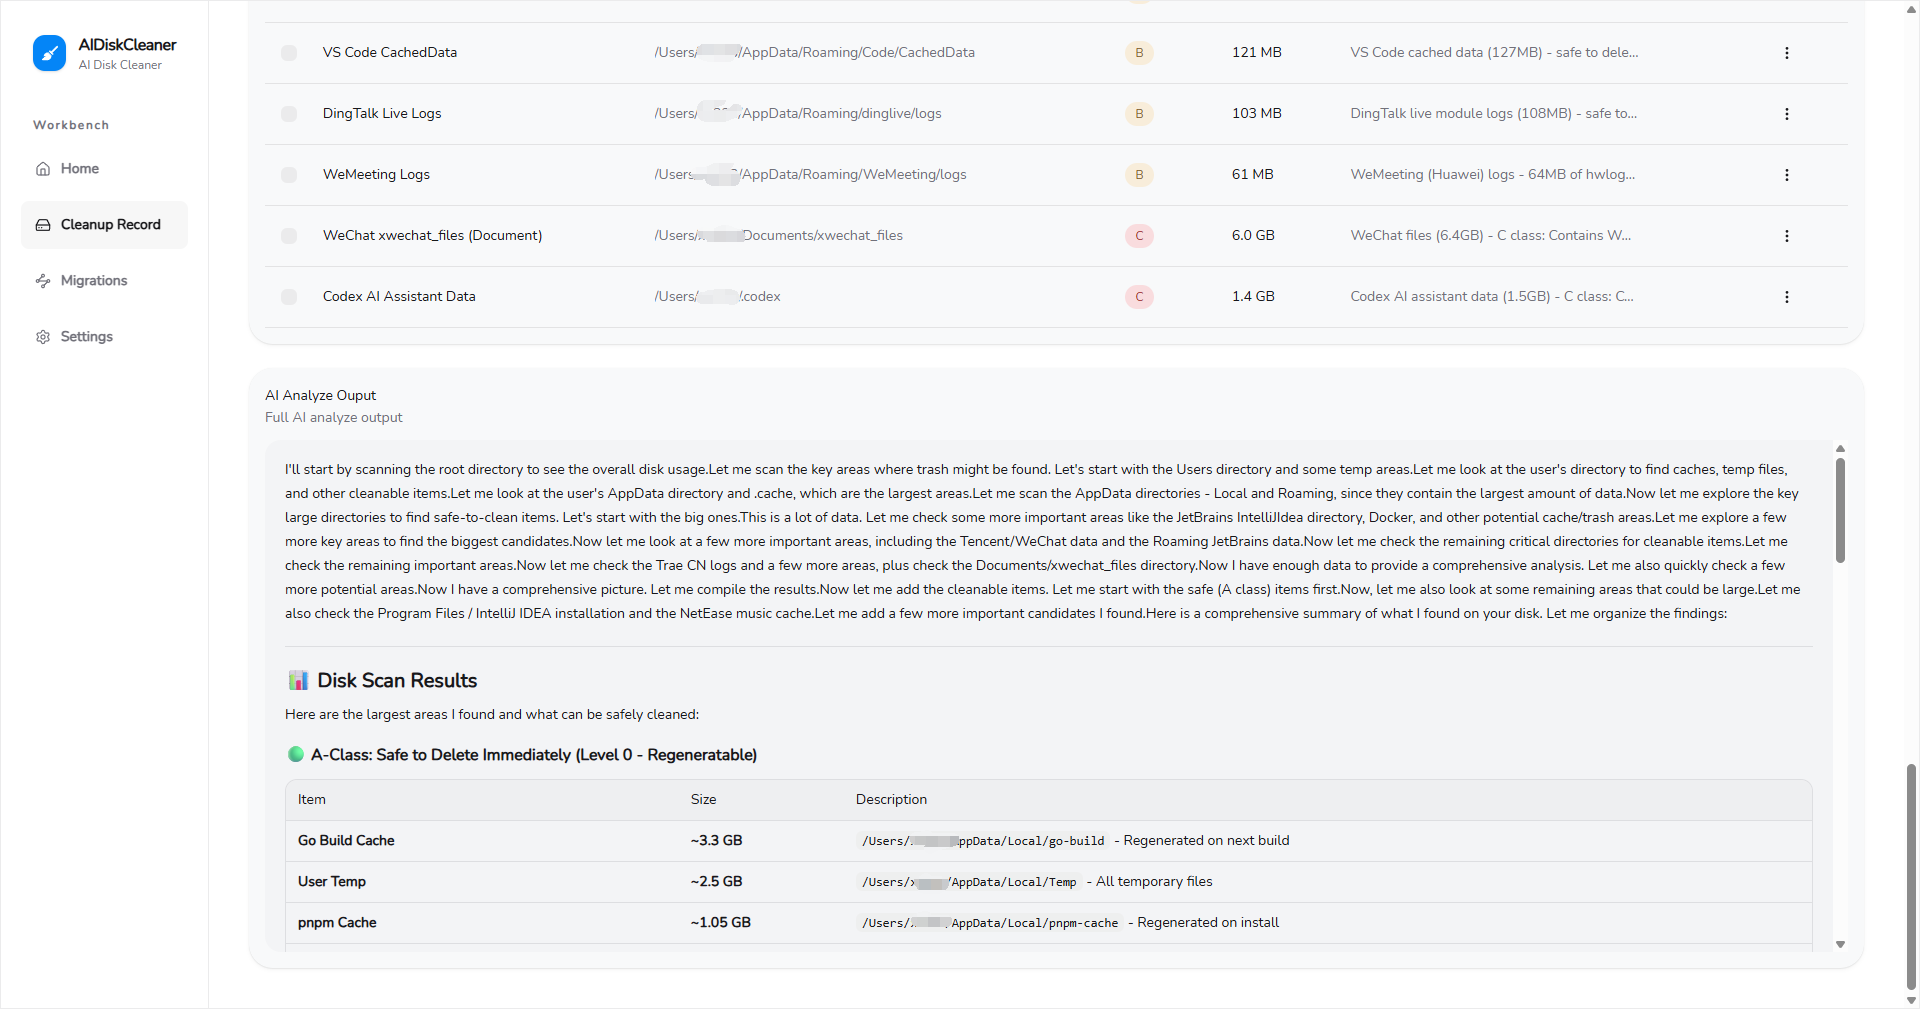
利用大语言模型对磁盘占用情况进行分析,自动识别可以安全删除的垃圾文件,并汇总结果展示给用户。LLM 会遍历文件树,找出占用空间最大的文件,并判断其是否为可清理的垃圾。
### 📦 迁移管理
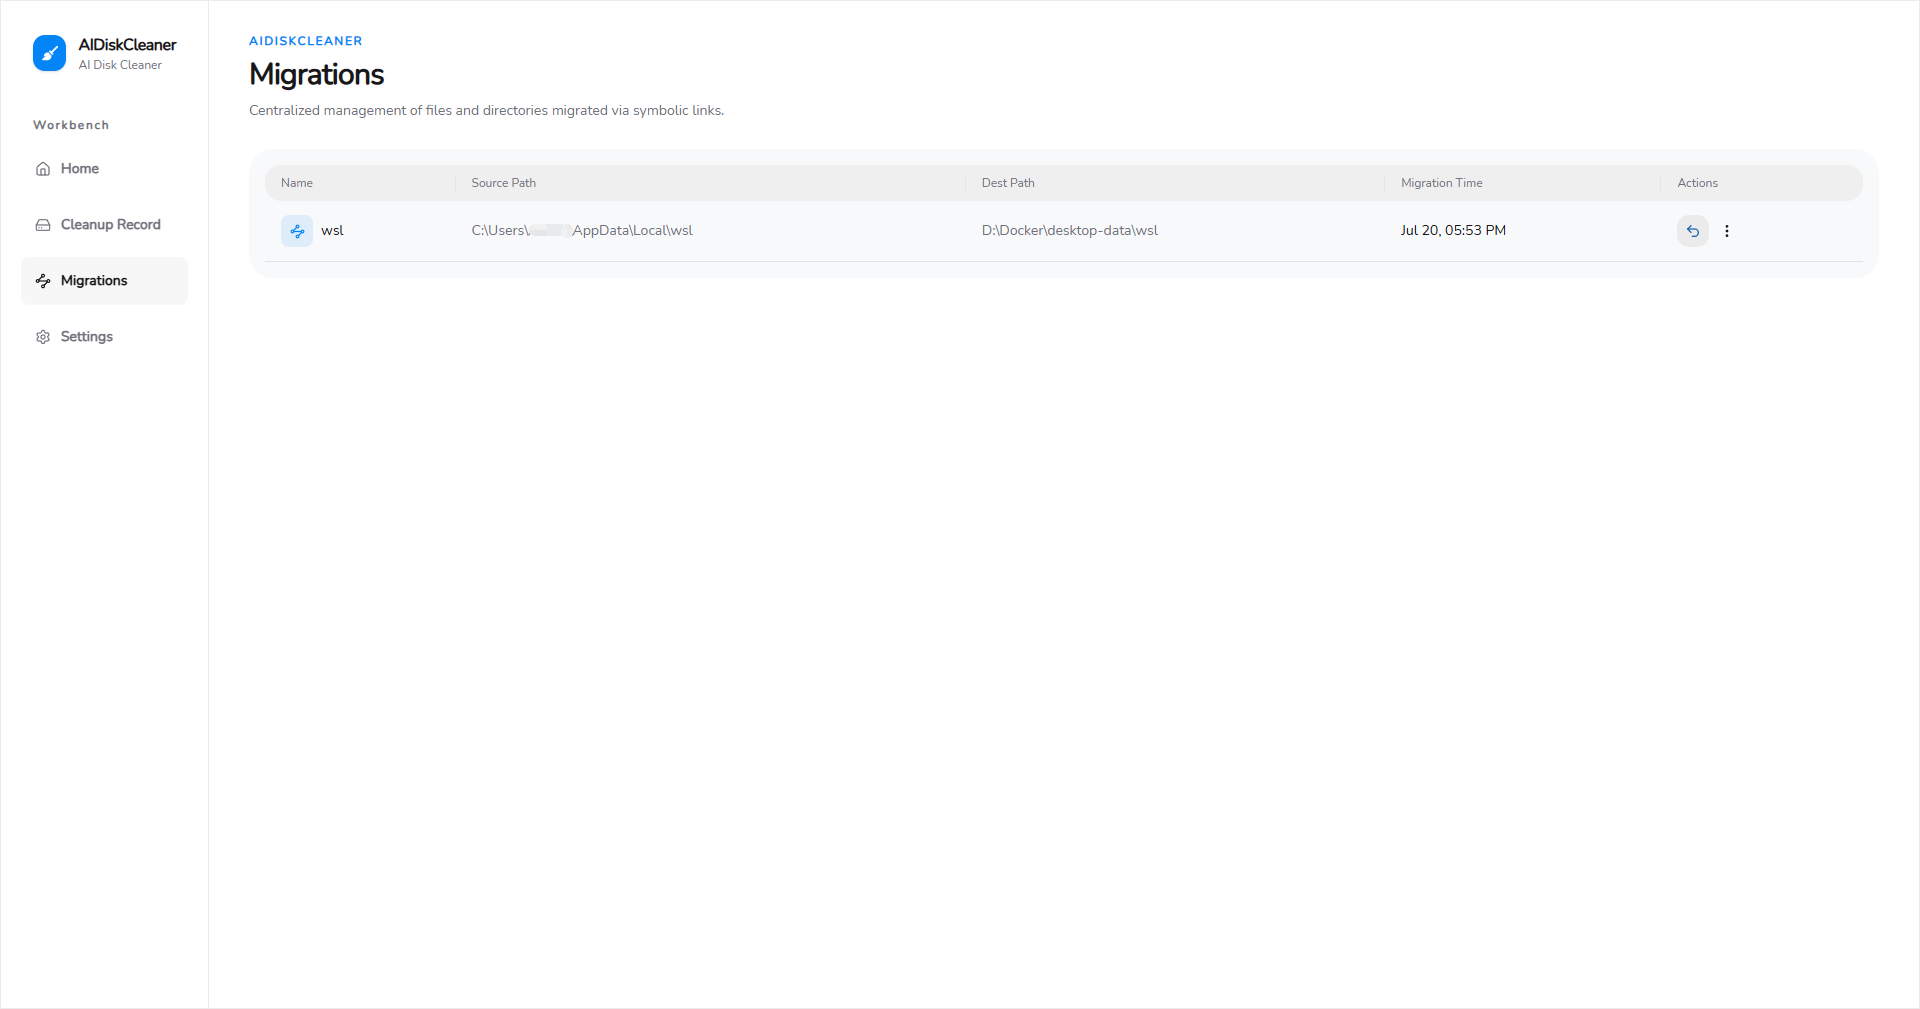
提供软链接的统一管理功能,支持一键将文件迁移到其他磁盘分区。这对于需要定期整理多磁盘存储的用户来说非常实用。
## 工作原理
AI Disk Cleaner 的整个架构分为三步:
1. **扫描文件树**:使用 [gdu](https://github.com/dundee/gdu) 扫描指定位置,并将文件树加载到内存中。
2. **LLM 分析**:暴露文件树读取工具,让 LLM 分析文件树,找出占用空间最大的文件。在找到垃圾文件后,LLM 会调用 `add_trash_file` 工具来标记文件。
3. **结果展示**:系统汇总 LLM 分析结果,以表格和可视化方式展示给用户。
## 快速开始
1. 从 [Releases](https://github.com/vudsen/ai-disk-cleaner/releases) 页面下载最新版本的 `.exe`(目前仅支持 Windows)。
2. 将下载的 `.exe` 放在一个单独的文件夹中(应用启动后会在 exe 当前目录生成数据文件)。
3. 打开应用(推荐以管理员权限打开,否则某些删除或迁移操作可能会报错)。
4. 进入设置页面,配置大模型参数。
5. 回到首页,开始扫描。
## 技术栈
| 组件 | 技术 |
|------|------|
| 后端语言 | Go |
| 桌面框架 | Wails |
| 磁盘扫描 | gdu |
| AI 分析 | LLM API |
| 许可证 | MIT |
## 为什么选择 AI Disk Cleaner?
传统的磁盘清理工具依赖于预定义规则和文件扩展名匹配,容易误删重要文件或遗漏真正无用的文件。AI Disk Cleaner 的核心优势在于:
- **智能判断**:LLM 能够理解文件的上下文和用途,做出更准确的删除建议
- **自然语言交互**:用户可以通过自然语言与 LLM 交流,了解每个文件的详细信息
- **迁移便捷**:软链接管理和一键迁移功能,让多磁盘管理变得简单高效
## 项目链接
- **GitHub 仓库**:[vudsen/ai-disk-cleaner](https://github.com/vudsen/ai-disk-cleaner)
- **许可证**:MIT
- **当前版本**:持续更新中
如果你正在寻找一款智能、高效的磁盘清理工具,AI Disk Cleaner 值得一试。
---
# LaTeXSnipper:一款开源免费的公式识别与数学编辑工作空间
- Canonical: https://www.zeroxin.xin/2026/07/26/LaTeXSnipper%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D/
- Markdown: https://www.zeroxin.xin/2026/07/26/LaTeXSnipper%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D.md
- Published: 2026-07-26T11:35:00+08:00
- Updated: 2026-07-26T12:03:11+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, Python, OCR, LaTeX, 数学工具, PyQt6
LaTeXSnipper 是一款集截图 OCR、手写识别、公式编辑、符号计算与多格式导出于一体的桌面数学工具。本文提供详细的安装教程与使用指南。
## 项目概述
**LaTeXSnipper** 是由开发者 [SakuraMathcraft](https://github.com/SakuraMathcraft) 创建的一个跨平台桌面数学工作空间。它不再只是一个"截图公式转 LaTeX"工具,而是覆盖端到端数学内容工作流:
- 📸 从截图或 PDF 中识别数学公式
- ✍️ 在专用手写画布中书写并自动转换为 LaTeX
- 🧮 在集成数学工作台中编辑、计算和回写
- 🔄 支持 30+ 种导出格式(LaTeX、Markdown、MathML、HTML、Word、Typst 等)
### 项目亮点
| 特性 | 说明 |
| --- | --- |
| **公式识别** | 基于 MathCraft OCR,支持公式、文字及混合内容识别 |
| **手写识别** | 专用手写窗口,支持自动识别与实时预览 |
| **数学工作台** | 独立工作空间,集成公式编辑与计算 |
| **公式编辑** | 内置 MathLive `math-field` 及虚拟数学键盘 |
| **多格式导出** | 30 种导出选项,覆盖 LaTeX/Markdown/MathML/HTML/OMML/SVG/Typst/Word/EPUB/RTF 等 |
| **符号计算** | 基于 Compute Engine,支持化简、求值、展开、因式分解、求解 |
| **离线优先** | 识别与高级求解可本地运行,保护隐私 |
| **主题支持** | 亮色/暗色自动适配 |
---
## 安装教程
### Windows(推荐)
#### 方式一:Inno 安装包(推荐新手)
1. 前往 [GitHub Releases](https://github.com/SakuraMathcraft/LaTeXSnipper/releases/latest) 页面。
2. 下载 `LaTeXSnipperSetup-2.4.0.exe`。
3. 运行安装程序,按提示完成安装。
4. 桌面上生成快捷方式,双端启动。
#### 方式二:Microsoft Store / MSIX
- 在 Microsoft Store 中搜索 **LaTeXSnipper** 进行安装。
- 或从 Release 页面下载 MSIX 包手动安装。
### Linux
#### 一键安装命令
```bash
git clone https://github.com/SakuraMathcraft/LaTeXSnipper.git
cd LaTeXSnipper
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements-linux.txt
python src/main.py
```
#### 打包为 Debian/Ubuntu 安装包
```bash
# 构建 .deb 包
bash scripts/build_deb.sh
# 安装
sudo dpkg -i latexsnipper_*.deb
```
> 💡 Linux 平台依赖 `grim`、`maim`、`gnome-screenshot` 等截图工具来提升截图回退行为,这些工具需通过发行版包管理器自行安装,LaTeXSnipper 的依赖向导仅管理 Python 依赖层。
### macOS
```bash
git clone https://github.com/SakuraMathcraft/LaTeXSnipper.git
cd LaTeXSnipper
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements-macos.txt
python src/main.py
```
macOS 打包产物为 `.app.zip` 和 `.dmg`,可从 Releases 页面下载。
### 更新 LaTeXSnipper
- **Windows**:下载新版安装包重新运行即可。
- **GitHub Actions**:Tag 发布时会自动构建各平台包,关注 Releases 页面获取最新版本。
---
## 快速开始
### 截图识别
1. 启动 LaTeXSnipper。
2. 点击截图按钮或使用快捷键捕获屏幕上的数学公式。
3. MathCraft OCR 自动识别公式并生成 LaTeX 代码。
4. 在右侧工作台中编辑、调整公式。
5. 点击"复制"或"插入"将 LaTeX 放回原文档。
### 手写识别
1. 打开手写窗口。
2. 使用鼠标或触控笔书写数学表达式。
3. 系统实时识别并预览 LaTeX 结果。
4. 确认后发送到主编辑器。
### 数学计算
在工作台中可直接对公式进行符号运算:
- **化简**(Simplify)
- **数值求值**(Evaluate)
- **展开**(Expand)
- **因式分解**(Factor)
- **求解方程**(Solve)
对于更复杂的表达式,系统会自动回退到本地 SymPy/mpmath 引擎。
---
## 核心功能详解
### 多格式导出
LaTeXSnipper 支持 30 种导出格式:
| 类别 | 格式 |
| --- | --- |
| 文档标记 | LaTeX, Markdown, HTML, reStructuredText, Typst, Org-mode |
| 数学格式 | MathML, OMML, LaTeX, AsciiMath |
| 矢量图形 | SVG |
| 办公文档 | Word (DOCX), RTF, ODT |
| 电子书 | EPUB |
| 维基 | Wiki 格式 |
| 数据 | JSON, CSV |
### 离线优先
- 公式识别与高级求解均在本地运行,无需网络连接
- MathCraft OCR 模型通过 ONNX Runtime 推理,不依赖 PyTorch 运行时
- 所有数据保留在本地,保护学术与隐私敏感内容
---
## 项目结构
```
LaTeXSnipper/
├── mathcraft_ocr/ # MathCraft OCR 独立运行时与 CLI
├── src/
│ ├── main.py # 主桌面应用入口
│ ├── distribution.py # GitHub / Microsoft Store 渠道策略
│ ├── backend/ # OCR 封装、CUDA 诊断、截图、平台服务
│ ├── bootstrap/ # 依赖向导与运行时验证
│ ├── core/ # 文档组合、导出契约、重启契约
│ ├── editor/ # 数学工作台与公式编辑 UI
│ ├── handwriting/ # 手写画布、PDF 预览、文档工具
│ └── ...
├── requirements-linux.txt
├── requirements-macos.txt
├── LaTeXSnipper.spec # PyInstaller 打包配置
├── Inno/ # Windows Inno 安装脚本
├── packaging/debian/ # Debian 打包配置
└── scripts/
├── build_deb.sh # Linux .deb 构建脚本
├── build_macos.sh # macOS 打包脚本
└── build_store_msix.ps1 # MSIX 打包脚本
```
---
## 技术栈
- **语言**: Python 3.10+
- **UI 框架**: PyQt6 + Q Fluent Widgets
- **OCR**: MathCraft OCR(ONNX Runtime 推理)
- **公式编辑**: MathLive `math-field`
- **符号计算**: MathLive Compute Engine / SymPy / mpmath
- **构建**: PyInstaller + Inno Setup (Windows) / PyInstaller + DMG (.macOS) / Debian (.Linux)
- **许可证**: MIT License
---
## 适用场景
- 📝 **学术写作**:快速将论文中的手写公式或截图公式转为 LaTeX
- 📚 **教学课件**:从 PDF 或幻灯片中提取数学公式并复用
- 💻 **Office 集成**:通过 Word/PowerPoint 插件在文档中直接插入识别公式
- 🔬 **科研工作**:将文献中的公式离线转换为可编辑的 LaTeX 代码
- ✍️ **手写输入**:使用笔输入数学表达式,实时预览 LaTeX
---
## 项目统计
- **GitHub Stars**: ⭐ 760
- **Forks**: 40
- **提交数**: 332
- **最新版本**: v2.4.0 LTS(2026年7月)
- **许可证**: MIT License
- **项目地址**: [https://github.com/SakuraMathcraft/LaTeXSnipper](https://github.com/SakuraMathcraft/LaTeXSnipper)
---
## 总结
LaTeXSnipper 是一个功能完整、离线优先的数学公式识别与编辑工作空间。它覆盖了从截图识别、手写输入到公式计算和多格式导出的完整工作流,特别适合需要频繁处理数学公式的学术工作者和科研人员。Windows 用户可以通过 Inno 安装包一键安装,Linux 和 macOS 用户也可以通过源码快速运行。作为一个开源免费无广告的项目,其持续维护和社区活跃度值得肯定。
**项目地址**: [https://github.com/SakuraMathcraft/LaTeXSnipper](https://github.com/SakuraMathcraft/LaTeXSnipper)
---
# dnspick:一句话选出最适合你的 DNS 服务器
- Canonical: https://www.zeroxin.xin/2026/07/26/dnspick%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D/
- Markdown: https://www.zeroxin.xin/2026/07/26/dnspick%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D.md
- Published: 2026-07-26T11:30:00+08:00
- Updated: 2026-07-26T11:27:50+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, 网络工具, DNS, Go, 命令行
dnspick 是一个跨平台 DNS 性能基准测试工具,支持 UDP、DoT、DoH、DoH3 四种协议,自动检测当前系统 DNS 并给出推荐。本文提供详细的安装教程与使用指南。
## 项目概述
**dnspick** 是由开发者 [palemoky](https://github.com/palemoky/dnspick) 创建的一个跨平台命令行 DNS 性能测试工具。它并发基准测试一批主流及自定义 DNS 服务器,涵盖 **UDP**、**DNS-over-TLS (DoT)**、**DNS-over-HTTPS (DoH)** 和 **DNS-over-HTTP/3 (DoH3)** 四种协议,对一组常用的国内/国外域名反复查询,结合**平均延迟**与**成功率**给出综合评分,同时自动检测当前系统默认 DNS 并纳入对比,最后推荐最优选择。
### 项目亮点
- 🌐 **跨平台**:完美运行于 Windows、macOS、Linux、Raspberry Pi (ARM/ARM64) 等主流平台
- 🔒 **多协议**:同时测试 UDP、DoT、DoH(RFC 8484)、DoH3(基于 QUIC)
- 📊 **综合评分**:不仅测速,还结合成功率智能打分,避免"虽快但不稳定"的 DNS 跻身前列
- 🔍 **自动检测当前 DNS**:自动探测系统默认 DNS 并参与对比,给出是否需要切换的建议
- 🔄 **自更新**:运行时自动检查新版本,交互式终端中可原地升级
- 🌏 **中英双语界面**:默认跟随系统 `LANG`,支持手动切换
---
## 安装教程
### 一键安装(推荐)
脚本会自动检测操作系统与 CPU 架构,下载对应版本并安装到 `PATH`。
#### Linux / macOS
```bash
curl -fsSL https://raw.githubusercontent.com/palemoky/dnspick/main/install.sh | sh
```
#### Windows(PowerShell)
```powershell
irm https://raw.githubusercontent.com/palemoky/dnspick/main/install.ps1 | iex
```
> 💡 macOS 用户无需手动处理 Gatekeeper 拦截,脚本会自动解除隔离标记。
### 手动安装
你也可以从 [GitHub Releases](https://github.com/palemoky/dnspick/releases) 页面下载预编译版本。
1. 前往最新 Release 页面。
2. 根据你的操作系统和 CPU 架构下载对应压缩包(如 `dnspick-windows-amd64.zip`、`dnspick-linux-arm64.tar.gz`)。
3. 解压后即可在终端中使用。
建议将可执行文件移动到系统 `PATH` 包含的目录中:
```bash
# Linux / macOS
sudo mv dnspick /usr/local/bin/
# Windows(PowerShell,以管理员权限运行)
Move-Item dnspick.exe C:\Windows\System32\
```
### 更新 dnspick
随时原地升级到最新版本:
```bash
dnspick update
```
dnspick 运行时会在后台检查新版本。在交互式终端中发现新版本会自动原地更新;输出被管道接管或在 CI 中则只打印提示(不会自我修改)。该检查不阻塞主流程,离线时静默跳过。
### macOS 提示「已损坏 / 移动到垃圾桶」
由于 dnspick 未经过 Apple 付费公证,macOS Gatekeeper 会拦截从网络下载的程序,出现「无法验证开发者」「已损坏,应移到废纸篓」等提示。**文件并非真正损坏**,任选以下方式解除即可:
```bash
# 推荐:解除下载隔离标记(一行搞定)
xattr -dr com.apple.quarantine ./dnspick
```
- **图形界面方式**:在访达中右键点击 → 选择「打开」→ 弹窗中再次确认「打开」
- **较新 macOS**:双击运行一次(会被拦截),然后到 **系统设置 → 隐私与安全性**,点击底部「仍要打开」
---
## 快速开始
直接运行即可开始测试:
```bash
dnspick
```
输出示例:
```
dnspick: benchmarking 33 DNS servers against 20 domains...
Progress: 45% (594/1320)
┌──────────────┬────────┬────────────────┬────────┐
│ Domestic │ Status │ Foreign │ Status │
├──────────────┼────────┼────────────────┼────────┤
│ baidu.com │ ✔ │ google.com │ ✔ │
│ qq.com │ ✔ │ youtube.com │ 60% │
│ taobao.com │ 60% │ github.com │ - │
└──────────────┴────────┴────────────────┴────────┘
--- Benchmark Results ---
┌────┬───────────────────────┬─────────────────┬─────────────┬────────────────┬────────┐
│ # │ DNS Server │ Address │ Avg Latency │ Success Rate │ Score │
├────┼───────────────────────┼─────────────────┼─────────────┼────────────────┼────────┤
│ 1 │ Freenom 2 (UDP) │ 80.80.81.81 │ 6.16ms │ 100.0% (40/40) │ 162.33 │
│ 2 │ Cloudflare 2 (UDP) │ 1.0.0.1 │ 6.227ms │ 100.0% (40/40) │ 160.58 │
│ 3 │ DNSPod 1 (UDP) │ 119.28.28.28 │ 6.337ms │ 100.0% (40/40) │ 157.80 │
└────┴───────────────────────┴─────────────────┴─────────────┴────────────────┴────────┘
--- Top 3 Recommendations ---
#1: Freenom 2 (UDP) (80.80.81.81)
Score: 162.33, avg latency: 6.16ms, success rate: 100.0%
#2: Cloudflare 2 (UDP) (1.0.0.1)
Score: 160.58, avg latency: 6.227ms, success rate: 100.0%
#3: DNSPod 1 (UDP) (119.28.28.28)
Score: 157.80, avg latency: 6.337ms, success rate: 100.0%
```
---
## 高级用法
### 自定义测试参数
```bash
# 查看所有可用参数
dnspick --help
# 每个域名查询 5 次,使用自定义域名列表
dnspick -q 5 -d "google.com,github.com,youtube.com"
# 单次查询超时 1 秒,并发数降到 8
dnspick -t 1s -c 8
# 强制使用英文界面
dnspick --lang en
# 输出机器可读 JSON(适合脚本和 CI)
dnspick --json | jq '.recommendation.top'
```
| 参数 | 简写 | 默认值 | 描述 |
| --- | --- | --- | --- |
| `--domains` | `-d` | 内置列表 | 自定义测试域名(逗号分隔,自动去重) |
| `--servers` | `-s` | 内置列表 | 自定义 DNS 服务器(协议按 scheme 自动推断:`1.1.1.1` → UDP,`tls://host` → DoT,`https://host/dns-query` → DoH,`h3://host/dns-query` → DoH3) |
| `--queries` | `-q` | `3` | 每个域名的查询次数 |
| `--timeout` | `-t` | `2s` | 单次查询超时 |
| `--concurrency` | `-c` | `16` | 同时测试的服务器数量上限 |
| `--no-system-dns` | | `false` | 不检测系统默认 DNS |
| `--lang` | | `$LANG` | 界面语言:`en` 或 `zh` |
| `--json` | | `false` | 输出 JSON 到 stdout(不显示进度界面) |
### JSON 输出(用于自动化)
```bash
dnspick --json | jq '.recommendation.top'
```
JSON 输出的关键字段:
| 字段 | 描述 |
| --- | --- |
| `results[]` | 所有被测服务器,按综合评分降序排列 |
| `results[].avg_latency_ms` | 平均延迟(毫秒,微秒精度) |
| `results[].success_rate` | 成功率,范围 `0.0`–`1.0` |
| `recommendation.top[]` | 成功率超过 98% 的 Top 3 推荐 |
| `recommendation.system_dns.verdict` | `best`(已最优)/ `good_enough`(无需更换)/ `switch`(建议切换)/ `all_failed`(全部失败) |
### 综合评分计算方式
综合评分 = `(1 / 平均延迟秒数) × 成功率²`
- **延迟项 `1 / 平均延迟`**:延迟越低,分数越高,呈反比放大
- **可靠性权重 `成功率²`**:成功率做平方惩罚,对丢包/超时非常敏感。100% 成功率乘以 1.0,90% 只剩 0.81,50% 直接砍到 0.25
这样可以避免"延迟很低但偶尔解析失败"的 DNS 排到前面。
---
## 技术细节
- **语言**: Go 1.21+
- **许可证**: MIT License
- **构建**: GitHub Actions 跨平台自动构建,支持 Windows、macOS、Linux(含 ARM/ARM64)
- **当前版本**: 持续更新中,266+ GitHub 星标
- **仓库**: [palemoky/dnspick](https://github.com/palemoky/dnspick)
---
## 适用场景
- 🏠 **家庭用户**:检测 ISP 提供的 DNS 是否足够快,探索更快的公共 DNS
- 🏢 **网络管理员**:批量评估不同 DNS 解析器的性能,为企业网络选型
- 📊 **开发者**:在 CI/CD 中集成 DNS 性能监控,确保解析质量
- 🌍 **跨境访问优化**:对比国内外 DNS 对不同域名的解析延迟,找到最优搭配
---
## 总结
dnspick 是一个轻量但功能完整的 DNS 性能测试工具,支持四种主流 DNS 协议(UDP、DoT、DoH、DoH3),提供智能综合评分和自动当前 DNS 检测。其一键安装脚本大大降低了使用门槛,macOS 用户也不必担心 Gatekeeper 拦截(脚本自动处理)。如果你正在寻找一款能帮你选出最优 DNS 的工具,dnspick 值得一试。
**项目地址**: [https://github.com/palemoky/dnspick](https://github.com/palemoky/dnspick)
---
# Linux 桌面环境全面指南:主流 GUI 桌面环境对比与安装
- Canonical: https://www.zeroxin.xin/2026/06/27/Linux-Desktop-Environments-Guide/
- Markdown: https://www.zeroxin.xin/2026/06/27/Linux-Desktop-Environments-Guide.md
- Published: 2026-06-27T00:00:00+08:00
- Updated: 2026-07-13T22:34:33+08:00
- Language: zh-CN
- Categories: 系统技术
- Tags: Linux, 桌面环境, GNOME, KDE, Xfce, Cinnamon, MATE, LXQt, Budgie, Deepin, 开源
全面介绍 Linux 生态中最流行的八大桌面环境——GNOME、KDE Plasma、Xfce、Cinnamon、MATE、LXQt、Budgie 和 Deepin,涵盖各自的设计理念、优缺点、适用场景及主流发行版上的安装方法
Linux 桌面环境的多样性是其最独特的优势之一。与 Windows 和 macOS 不同,Linux 允许用户自由选择和更换桌面环境,每种环境都代表着不同的设计哲学、资源占用和使用体验。本文带你详细了解当前最流行的八大 Linux 桌面环境。
## 什么是桌面环境?
桌面环境(Desktop Environment,简称 DE)是提供图形用户界面交互体验的整套组件集合,包括窗口管理器、面板、菜单、系统设置、文件管理器及配套应用。不同的桌面环境在性能、美观度、可定制性上各有侧重。
## 各桌面环境速览对比
| 桌面环境 | 工具包 | 资源占用 | 可定制性 | 目标用户 |
|---------|--------|---------|---------|---------|
| GNOME | GTK 4 | 较高 | 中等(通过扩展) | 现代工作流用户 |
| KDE Plasma | Qt 6 | 中等 | 极高 | 高级用户、定制爱好者 |
| Xfce | GTK 3 | 低 | 良好 | 旧硬件、效率用户 |
| Cinnamon | GTK 3 | 中等 | 良好 | 传统桌面用户 |
| MATE | GTK 3 | 低-中等 | 良好 | 经典桌面爱好者 |
| LXQt | Qt 6 | 极低 | 有限 | 资源受限环境 |
| Budgie | GTK 3 | 中等 | 良好 | 寻求简洁的用户 |
| Deepin DDE | Qt 5/6 | 中等 | 有限 | 美观追求者 |
---
## 1. GNOME
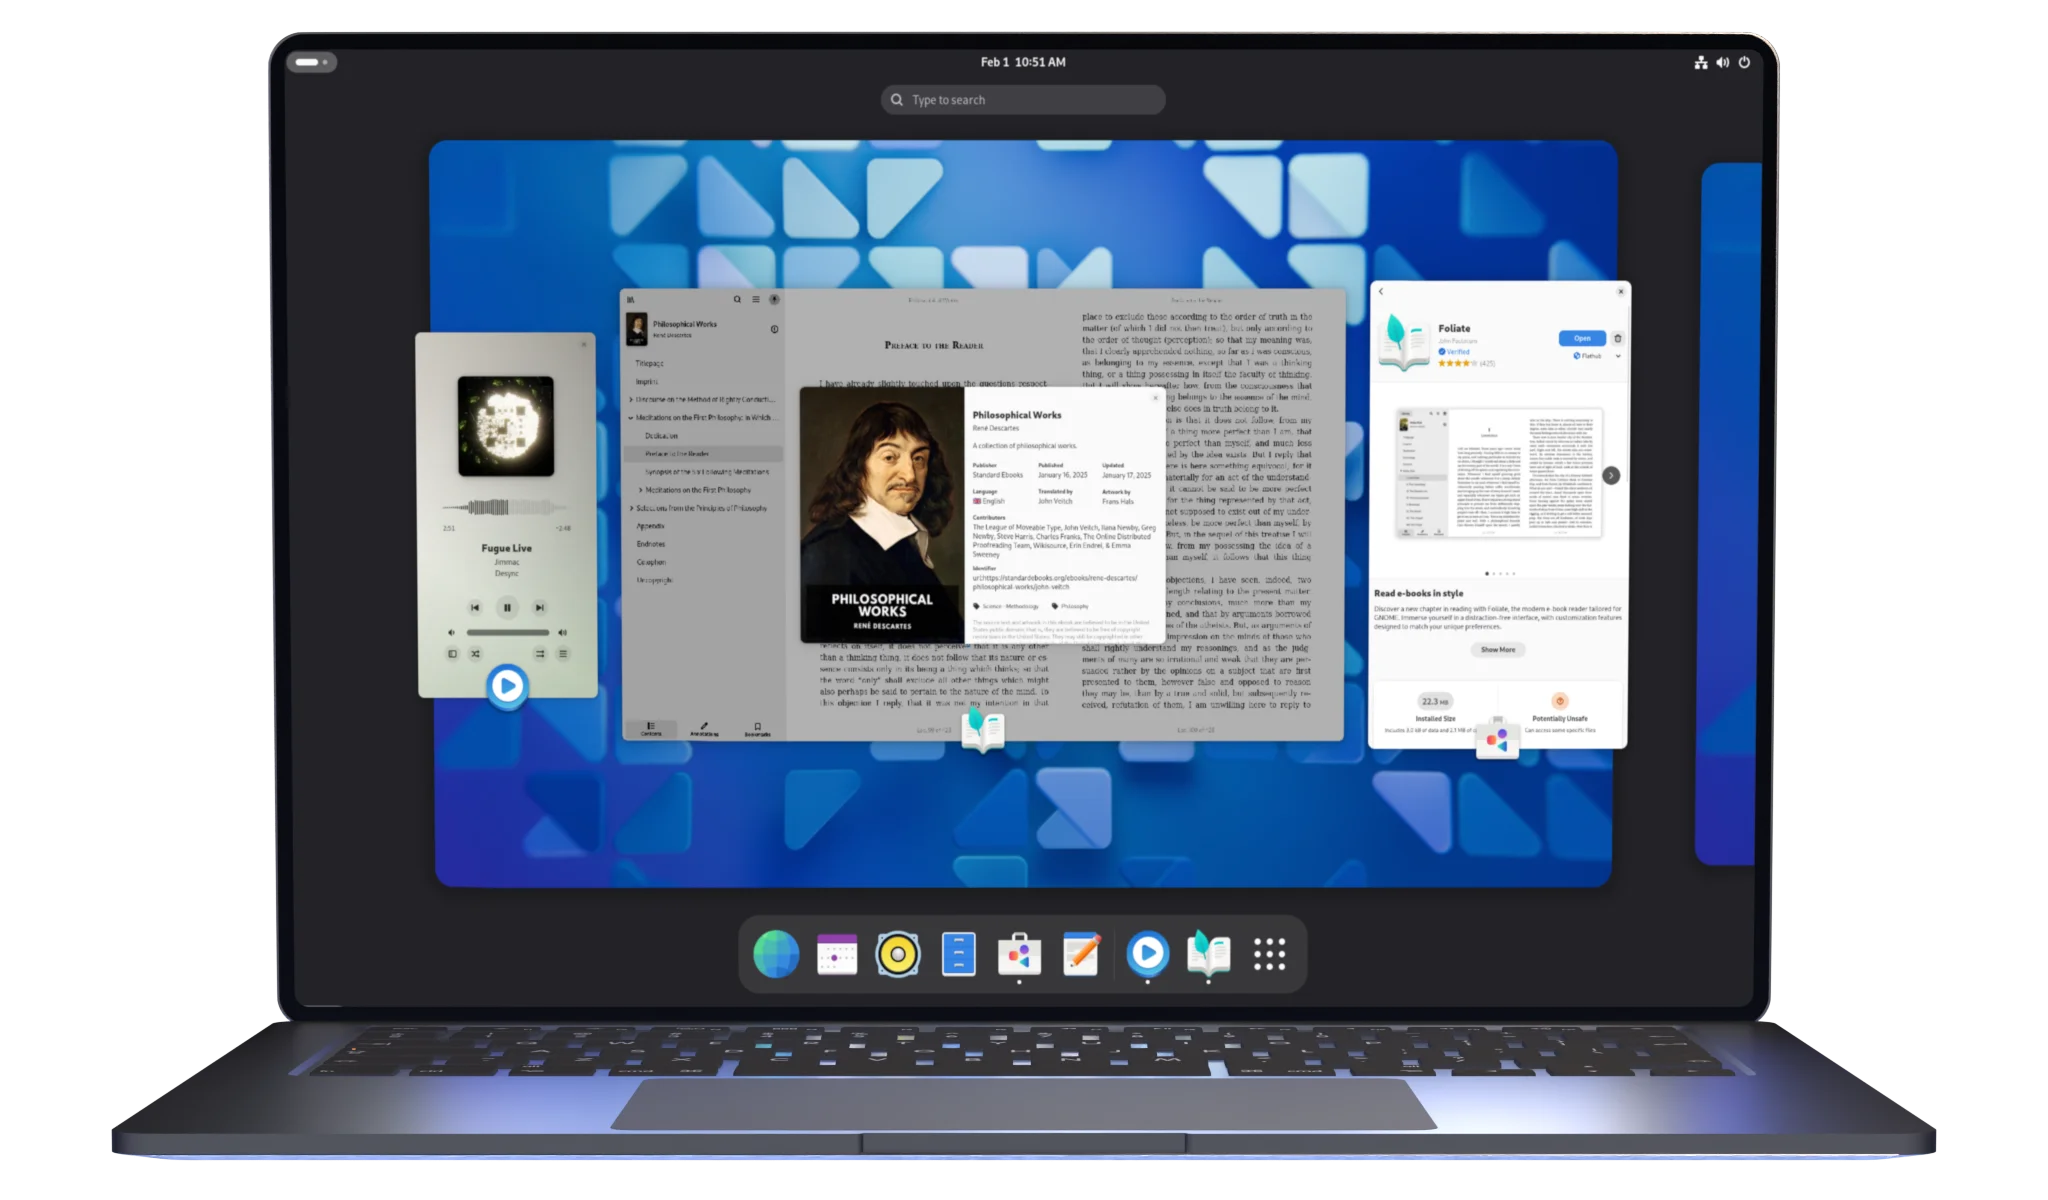
GNOME 是当今最流行的 Linux 桌面环境之一,被 Ubuntu、Fedora、Debian 等主流发行版采用。它以简洁、现代化的设计和键盘驱动的工作流著称。
### 优势
- **现代化的交互设计**:通过 Activities 概览和多工作区管理,提供流畅的任务切换体验
- **强大的扩展生态**:通过 GNOME Shell Extensions(extensions.gnome.org)可以大幅扩展功能
- **出色的无障碍支持**:内置屏幕阅读器、高对比度主题等无障碍功能
- **稳定性和一致性**:严格的 UI/UX 设计规范保证了统一的用户体验
### 劣势
- **资源占用较高**:默认情况下需要至少 4GB 内存才能流畅运行
- **原生定制能力有限**:许多自定义需求依赖第三方扩展,扩展可能因版本更新而失效
- **学习曲线**:与传统桌面布局差异较大,新用户需要适应
### 安装方法
```bash
# Ubuntu/Debian
sudo apt install gnome gnome-shell ubuntu-gnome-desktop
# Fedora(已默认安装)
sudo dnf groupinstall "GNOME Desktop Environment"
# Arch Linux
sudo pacman -S gnome gnome-extra
```
---
## 2. KDE Plasma
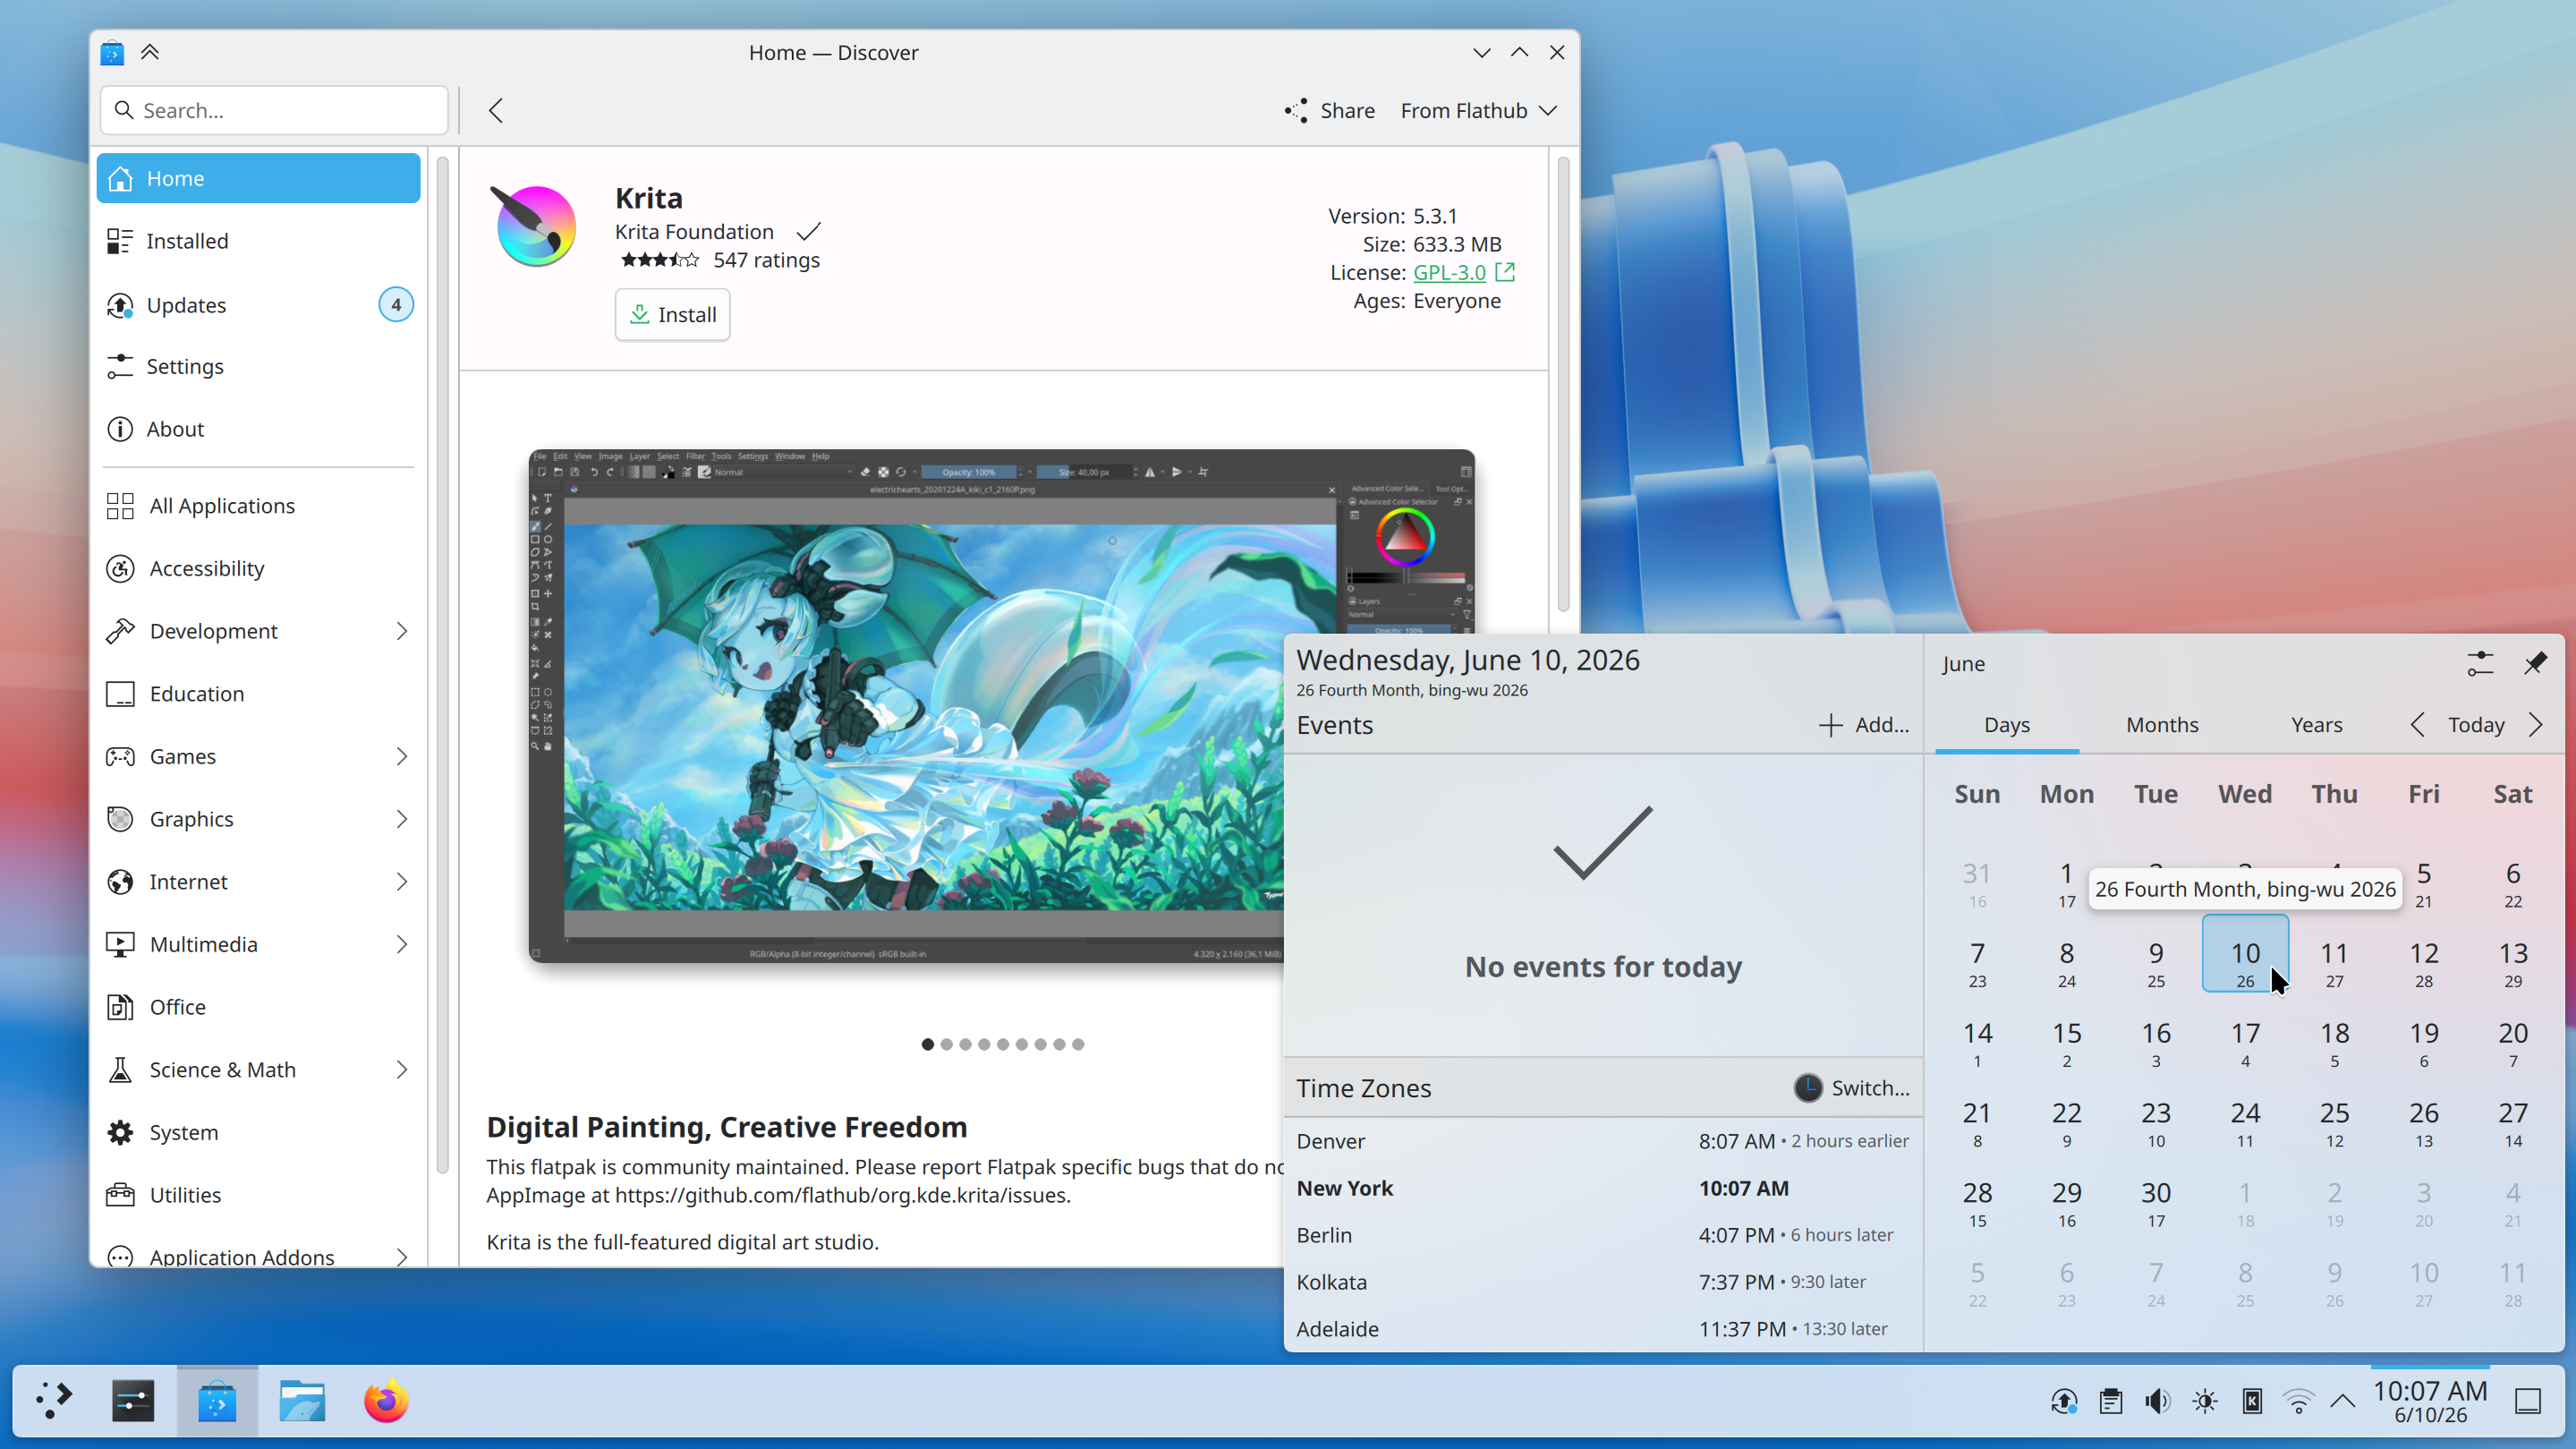
KDE Plasma 是一款功能极其丰富、可定制性极高的桌面环境,基于 Qt 工具包开发。它既有惊艳的视觉效果,又在 Plasma 6 中实现了令人惊讶的轻量级表现。
### 优势
- **无与伦比的定制性**:从面板、小部件到窗口装饰,几乎每个像素都可以自定义
- **功能丰富**:内置大量实用的 KDE 应用套件(Dolphin 文件管理器、Konsole 终端等)
- **轻量级表现**:Plasma 6 优化出色,资源占用远低于预期
- **KDE Connect**:与手机无缝集成,支持通知同步、文件传输、远程输入等
- **多平台支持**:除 Linux 外,还支持 BSD、乃至 Windows/macOS
### 劣势
- **选项过多**:大量的设置项可能让新用户感到不知所措
- **默认配置不够精简**:开箱即用的体验需要一些调整才能达到理想状态
- **Wayland 过渡期**:虽然 Plasma 6 已全面转向 Wayland,部分应用仍存在兼容性问题
### 安装方法
```bash
# Ubuntu/Kubuntu
sudo apt install kde-plasma-desktop plasma-workspace
# Fedora
sudo dnf groupinstall "KDE Plasma Workspaces"
# Arch Linux
sudo pacman -S plasma plasma-desktop plasma-wayland-session kde-applications
```
---
## 3. Xfce

Xfce 是一款经典的轻量级桌面环境,在性能与功能之间取得了绝佳平衡。它特别适合老旧硬件或追求极致效率的用户。
### 优势
- **极低的资源占用**:512MB 内存即可流畅运行
- **稳定可靠**:开发节奏稳健,每个版本都经过充分测试
- **高度可配置**:虽然没有 KDE 那样丰富的选项,但足以满足大多数需求
- **优秀的远程体验**:轻量特性使其在远程桌面和虚拟机中表现出色
- **良好的模块化设计**:组件可以独立升级和替换
### 劣势
- **视觉风格传统**:默认外观较为朴素,缺少现代化特效
- **Wayland 支持滞后**:直到 4.20 版本才开始实验性支持 Wayland
- **内置应用较少**:相比 GNOME 和 KDE,Xfce 自带的配套应用较为基础
### 安装方法
```bash
# Ubuntu/Xubuntu
sudo apt install xfce4 xfce4-goodies
# Fedora
sudo dnf groupinstall "Xfce Desktop"
# Arch Linux
sudo pacman -S xfce4 xfce4-goodies
```
---
## 4. Cinnamon
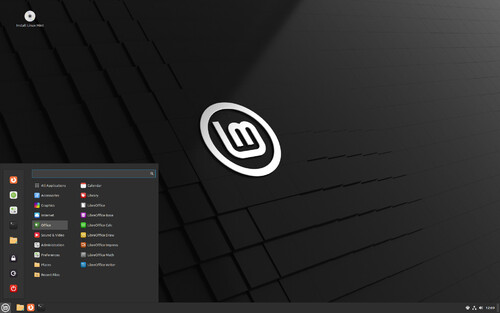
Cinnamon 是 Linux Mint 团队从 GNOME 3 分支开发的桌面环境,旨在提供传统、熟悉且具有现代功能的桌面体验。它是 Linux Mint 旗舰版默认的桌面环境。
### 优势
- **熟悉的传统布局**:底部面板 + 应用菜单的布局对 Windows 用户非常友好
- **开箱即用的体验**:Linux Mint 对 Cinnamon 进行了大量优化,上手即用
- **Applets 和 Desklets**:丰富的桌面小程序扩展生态
- **稳定的 GTK 主题兼容性**:主题和图标主题的支持非常完善
- **Spices 在线商店**:可通过图形界面直接安装扩展、主题和 applet
### 劣势
- **生态相对独立**:主要围绕 Linux Mint 生态发展,其他发行版上的体验可能不如 Mint 完善
- **资源占用中等**:相比 Xfce 和 LXQt,对内存的要求更高
- **Wayland 支持进展缓慢**:Cinnamon 目前仍以 X11 为主要显示服务器
### 安装方法
```bash
# Ubuntu
sudo apt install cinnamon cinnamon-desktop-environment
# Fedora
sudo dnf install @cinnamon-desktop-environment
# Arch Linux
sudo pacman -S cinnamon cinnamon-translations
```
---
## 5. MATE
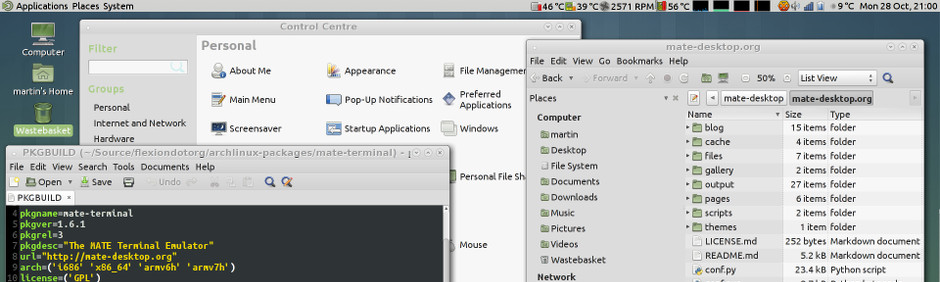
MATE 是 GNOME 2 的延续,保留了经典的桌面交互范式。它既轻量又功能完整,是追求传统桌面体验用户的绝佳选择。
### 优势
- **与 GNOME 2 一脉相承**:保留了经典的底部面板、应用菜单和桌面图标
- **轻量高效**:资源占用低于 Cinnamon,接近 Xfce 水平
- **功能完善**:提供完整的配套应用(Caja 文件管理器、Pluma 文本编辑器等)
- **良好的兼容性**:与大多数 GTK 应用完美配合
### 劣势
- **设计语言略显老旧**:界面现代感不足,缺少动画和视觉特效
- **开发资源有限**:维护团队规模较小,新功能开发速度较慢
- **Wayland 支持有限**:目前仍主要运行在 X11 上
### 安装方法
```bash
# Ubuntu/Ubuntu MATE
sudo apt install ubuntu-mate-desktop mate-desktop-environment
# Fedora
sudo dnf groupinstall "MATE Desktop"
# Arch Linux
sudo pacman -S mate mate-extra
```
---
## 6. LXQt
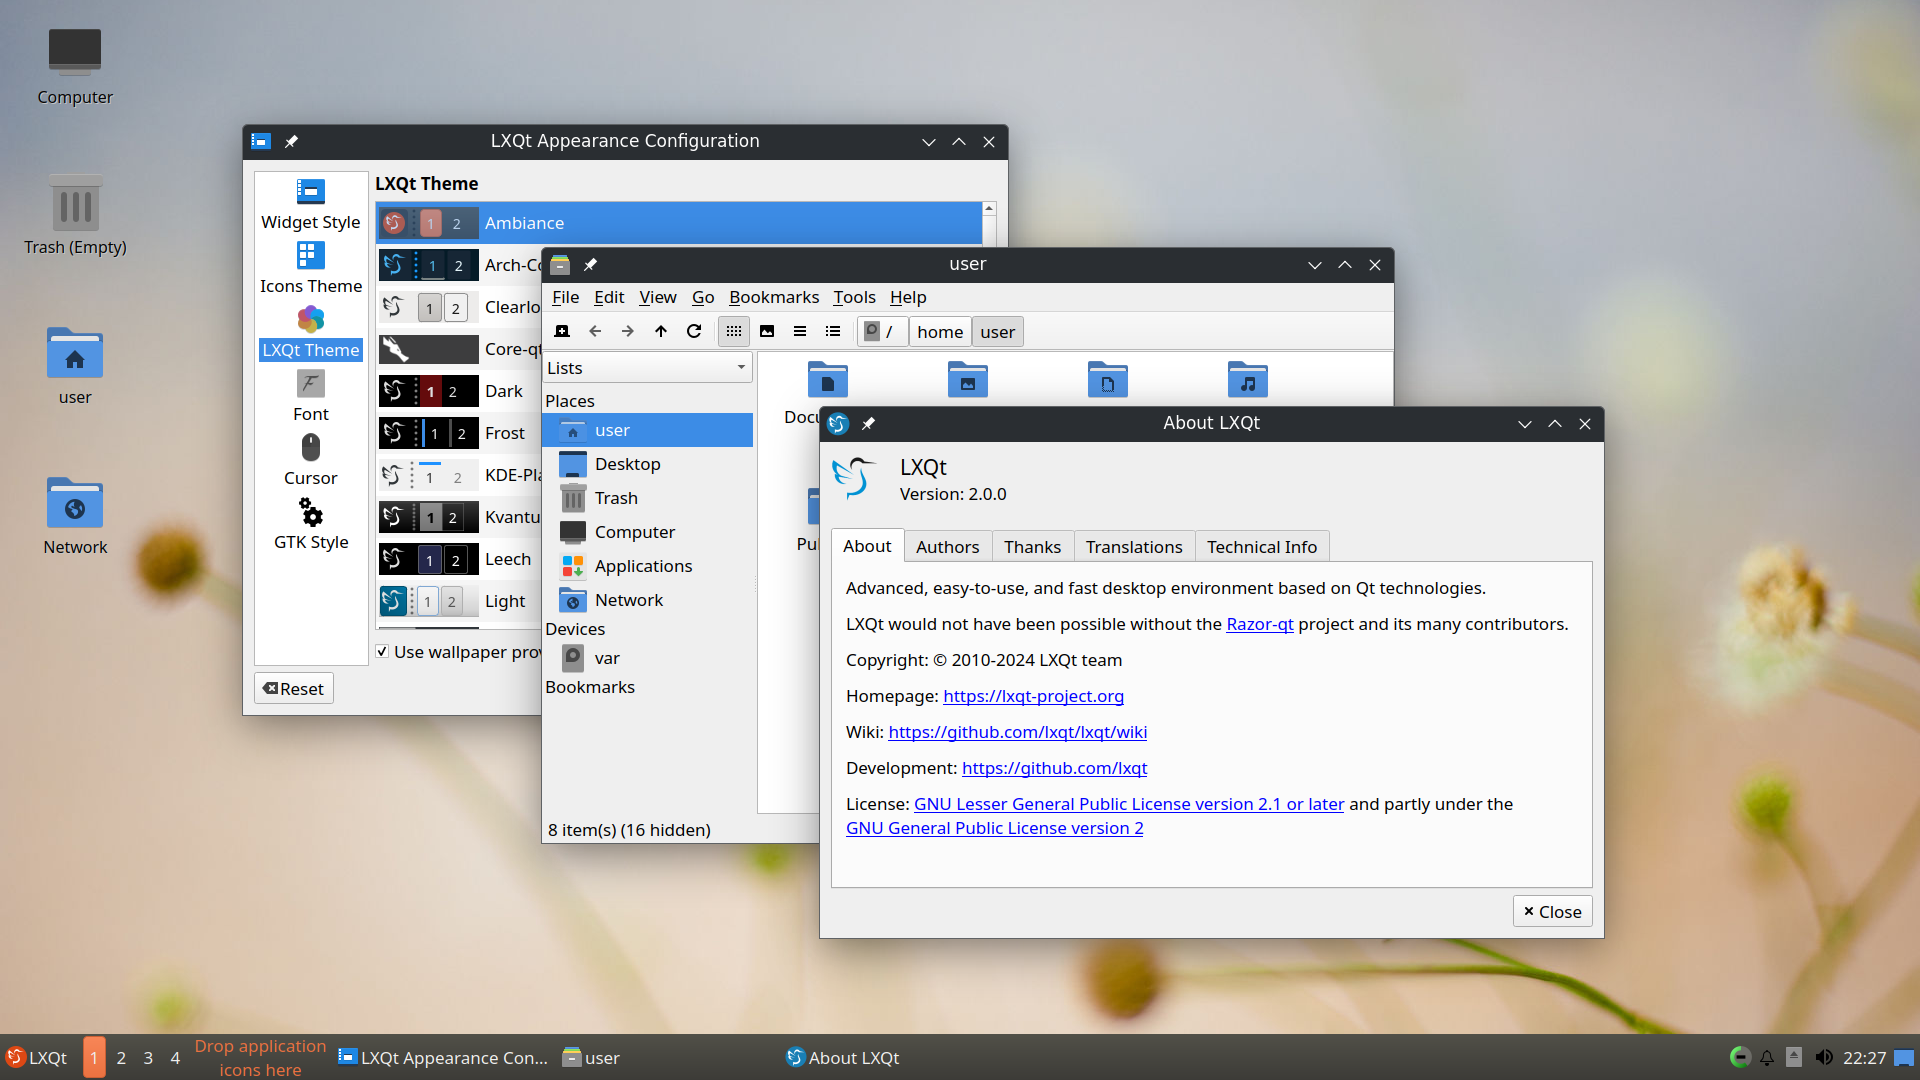
LXQt 是 LXDE 的下一代产品,将 LXDE 的轻量理念与 Qt 工具包的现代特性相结合。它是资源受限设备或追求极简体验用户的最佳选择。
### 优势
- **极致的轻量级**:最低只需 512MB 内存即可运行,CPU 占用极低
- **现代化的 Qt 技术栈**:相比基于 GTK 2 的旧版 LXDE,LXQt 拥有更现代的代码基础
- **模块化设计**:每个组件都可以独立替换
- **Wayland 支持积极**:自 2.3.0 版本起,Wayland 会话已不再是实验性功能
### 劣势
- **功能较为基础**:内置应用和功能远不如 KDE 或 GNOME 丰富
- **视觉效果简约**:默认外观较为朴素
- **应用生态有限**:专门为 LXQt 开发的应用较少
### 安装方法
```bash
# Ubuntu/Lubuntu
sudo apt install lxqt lxqt-core sddm
# Fedora
sudo dnf groupinstall "LXQt Desktop"
# Arch Linux
sudo pacman -S lxqt xdg-utils
```
---
## 7. Budgie
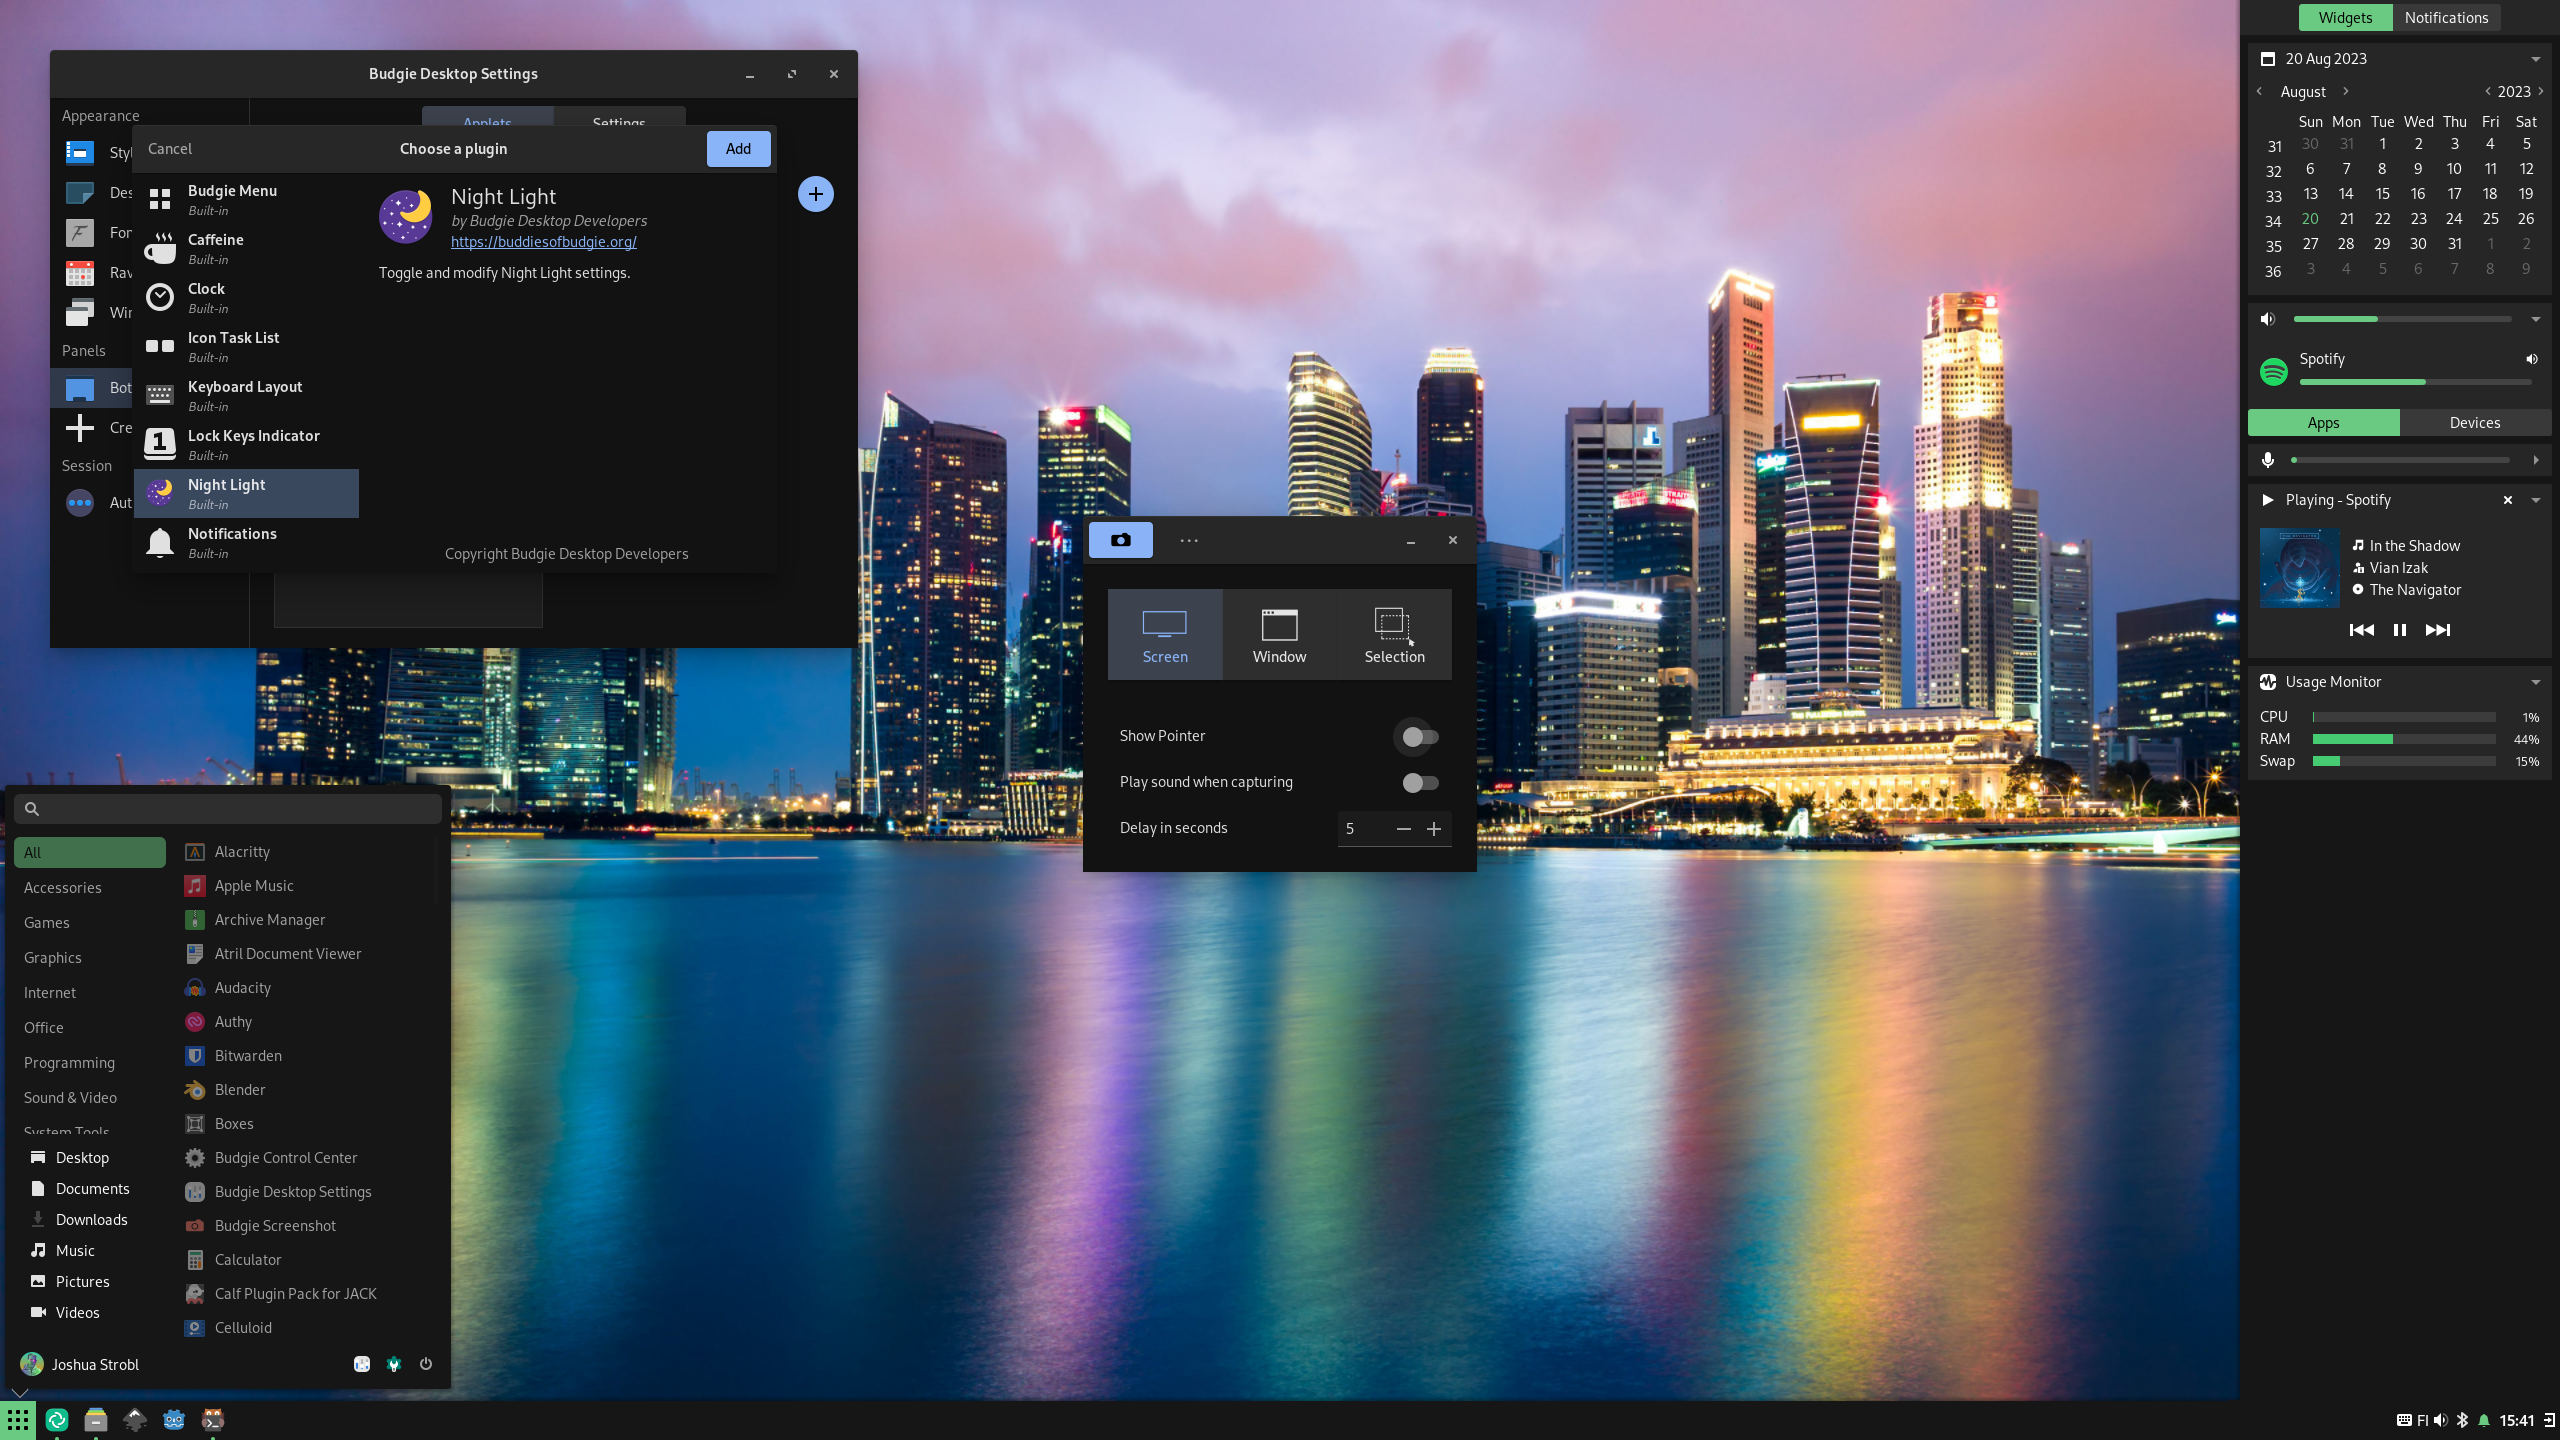
Budgie 是一款强调简洁、现代和优雅的独立桌面环境,最初为 Solus 发行版开发,现在已可在多款主流发行版中使用。其设计核心理念是"让桌面不打扰用户"。
### 优势
- **简洁优雅的设计**:界面干净清爽,没有多余元素
- **Raven 侧边栏**:集成了通知中心、日历、媒体控制和系统设置
- **多布局支持**:可轻松切换为类 macOS、Windows 或 Unity 布局
- **基于成熟的 GNOME 技术栈**:稳定性有保障
### 劣势
- **开发团队规模较小**:更新频率低于 GNOME 和 KDE
- **扩展生态有限**:相比 GNOME 和 KDE,可用的 applet 较少
- **独立发行版支持差异大**:不同发行版上的体验和默认配置差异明显
### 安装方法
```bash
# Ubuntu/Ubuntu Budgie
sudo apt install ubuntu-budgie-desktop budgie-desktop
# Fedora
sudo dnf install @budgie-desktop-environment
# Arch Linux
sudo pacman -S budgie-desktop budgie-desktop-view
```
---
## 8. Deepin DDE
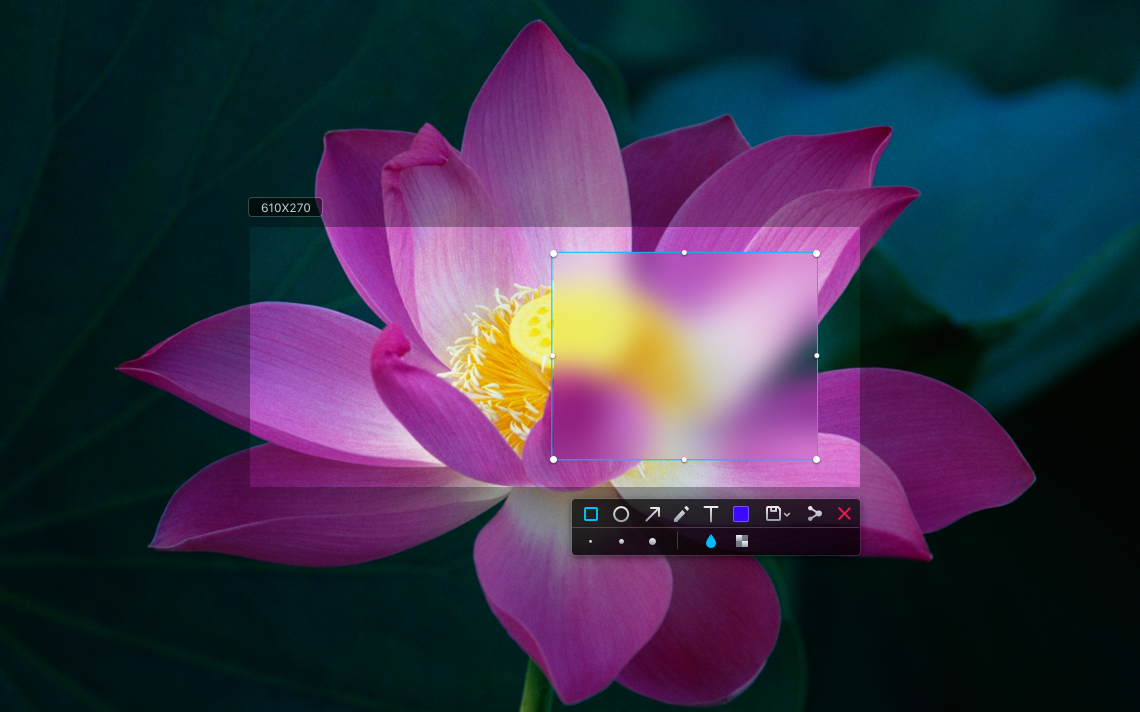
Deepin DDE(Deepin Desktop Environment)是由武汉深之度科技有限公司开发的桌面环境,以其精致美观的 UI 设计闻名。它在视觉体验上可与 macOS 和 Windows 11 媲美,是追求美观用户的理想选择。
### 优势
- **极致的视觉设计**:统一的圆角设计语言、毛玻璃效果和流畅动画
- **深度自研的 DTK 开发框架**:提供了统一的应用开发接口
- **内置丰富的自研应用**:深度影院、深度音乐、深度截图等超过 40 款应用
- **友好的中文支持**:对中文用户和中文输入法有极佳的原生支持
### 劣势
- **资源占用较高**:精美的视觉效果需要较强的硬件支持
- **安全风险关注**:openSUSE 安全团队曾指出 DDE 存在安全文化缺失的问题
- **主流发行版支持有限**:除 Deepin OS 外,其他发行版上的体验可能不够完美
- **国际化程度较低**:除中文外,其他语言的本地化质量参差不齐
### 安装方法
```bash
# Ubuntu/UbuntuDDE
sudo add-apt-repository ppa:ubuntudde-dev/stable
sudo apt update
sudo apt install ubuntudde-dde
# Arch Linux
sudo pacman -S deepin deepin-extra deepin-kwin
# Fedora(需要添加第三方仓库)
sudo dnf install dde-control-center dde-dock dde-launcher deepin-desktop
```
---
## 如何选择适合你的桌面环境?
| 使用场景 | 推荐桌面环境 |
|---------|------------|
| 新手入门、从 Windows 迁移 | Cinnamon、KDE Plasma |
| 追求美观与现代化 | Deepin DDE、GNOME |
| 硬件较旧或资源有限 | Xfce、LXQt、MATE |
| 喜欢深度定制 | KDE Plasma |
| 偏好键盘驱动的高效工作流 | GNOME(+ 扩展) |
| 服务器或远程桌面 | Xfce、LXQt |
| 极简主义 | Budgie、LXQt |
---
## 注意事项
1. **虚拟机先行**:如果想尝鲜新的桌面环境,建议先在虚拟机中测试,避免影响主力系统
2. **多桌面环境共存问题**:在同一系统上安装多个桌面环境可能导致主题和设置冲突,建议使用不同的显示管理器来隔离
3. **卸载不彻底的风险**:移除一个桌面环境时,依赖关系可能导致系统组件被意外删除,建议使用专门的元包管理工具来处理
4. **Wayland 与 X11 的选择**:较新的桌面环境(GNOME、KDE Plasma 6)已全面支持 Wayland,但 X11 在某些场景下(如屏幕共享)仍有兼容性优势
---
## 总结
Linux 桌面环境的丰富多样性是其独特魅力的重要组成部分。无论你是追求极致性能、钟情于精美视觉、还是热衷于深度定制,总有一款桌面环境适合你。这种选择的自由正是 Linux 生态无可替代的核心优势之一。
最重要的是,你不必从一而终——随时可以切换和尝试不同的桌面环境,找到最适合你工作流程和个人偏好的方案。
---
**参考资料**:
- [GNOME 官方网站](https://www.gnome.org)
- [KDE Plasma 官方网站](https://kde.org/plasma-desktop)
- [Xfce 官方网站](https://xfce.org)
- [Linux Mint / Cinnamon](https://linuxmint.com)
- [MATE 桌面环境](https://mate-desktop.org)
- [LXQt 项目](https://lxqt-project.org)
- [Buddies of Budgie](https://buddiesofbudgie.org)
- [Deepin 社区](https://www.deepin.org)
---
# A Complete Guide to Linux Desktop Environments: Comparison and Installation
- Canonical: https://www.zeroxin.xin/en/linux-desktop-environments-guide/
- Markdown: https://www.zeroxin.xin/en/linux-desktop-environments-guide.md
- Published: 2026-06-27T00:00:00+08:00
- Updated: 2026-07-13T22:33:47+08:00
- Language: en
- Categories: System
- Tags: Linux, GNOME, KDE, Xfce, Cinnamon, MATE, LXQt, Budgie, Deepin, Desktop Environment, Open Source
A comprehensive overview of the eight most popular Linux desktop environments — GNOME, KDE Plasma, Xfce, Cinnamon, MATE, LXQt, Budgie, and Deepin — covering their design philosophies, pros and cons, ideal use cases, and
The diversity of Linux desktop environments is one of its most unique strengths. Unlike Windows and macOS, Linux lets you freely choose and switch desktop environments, each representing a different design philosophy, resource footprint, and user experience. This article walks you through the eight most popular Linux desktop environments today.
## What Is a Desktop Environment?
A Desktop Environment (DE) is a complete set of components that provide the graphical user interface experience, including the window manager, panels, menus, system settings, file manager, and bundled applications. Different desktop environments emphasize performance, aesthetics, and customizability to varying degrees.
## Quick Comparison
| Desktop Environment | Toolkit | Resource Usage | Customizability | Target Users |
|---------|--------|---------|---------|---------|
| GNOME | GTK 4 | High | Medium (via extensions) | Modern workflow users |
| KDE Plasma | Qt 6 | Medium | Very high | Power users, customization fans |
| Xfce | GTK 3 | Low | Good | Older hardware, efficiency users |
| Cinnamon | GTK 3 | Medium | Good | Traditional desktop users |
| MATE | GTK 3 | Low-Medium | Good | Classic desktop fans |
| LXQt | Qt 6 | Very low | Limited | Resource-constrained systems |
| Budgie | GTK 3 | Medium | Good | Users wanting simplicity |
| Deepin DDE | Qt 5/6 | Medium | Limited | Aesthetics seekers |
---
## 1. GNOME

GNOME is one of the most popular Linux desktop environments today, used by mainstream distributions such as Ubuntu, Fedora, and Debian. It is known for its clean, modern design and keyboard-driven workflow.
### Pros
- **Modern interaction design**: the Activities overview and multiple workspaces provide a smooth task-switching experience
- **Powerful extension ecosystem**: GNOME Shell Extensions (extensions.gnome.org) can greatly expand functionality
- **Excellent accessibility support**: built-in screen reader, high-contrast themes, and more
- **Stability and consistency**: strict UI/UX design guidelines ensure a unified experience
### Cons
- **Higher resource usage**: needs at least 4GB of RAM to run smoothly by default
- **Limited native customization**: many customizations rely on third-party extensions that may break with version updates
- **Learning curve**: differs significantly from traditional desktop layouts, so new users need time to adapt
### Installation
```bash
# Ubuntu/Debian
sudo apt install gnome gnome-shell ubuntu-gnome-desktop
# Fedora (installed by default)
sudo dnf groupinstall "GNOME Desktop Environment"
# Arch Linux
sudo pacman -S gnome gnome-extra
```
---
## 2. KDE Plasma

KDE Plasma is an extremely feature-rich and highly customizable desktop environment built on the Qt toolkit. It offers stunning visuals while achieving surprisingly lightweight performance in Plasma 6.
### Pros
- **Unmatched customization**: from panels and widgets to window decorations, almost every pixel can be customized
- **Feature-rich**: bundled with a large suite of useful KDE applications (Dolphin file manager, Konsole terminal, etc.)
- **Lightweight performance**: Plasma 6 is well optimized, with resource usage far lower than expected
- **KDE Connect**: seamless phone integration for notification sync, file transfer, remote input, and more
- **Multi-platform support**: beyond Linux, it also supports BSD and even Windows/macOS
### Cons
- **Too many options**: the sheer number of settings can overwhelm new users
- **Default configuration isn't minimal**: the out-of-the-box experience needs some tweaking to feel ideal
- **Wayland transition**: although Plasma 6 has fully moved to Wayland, some apps still have compatibility issues
### Installation
```bash
# Ubuntu/Kubuntu
sudo apt install kde-plasma-desktop plasma-workspace
# Fedora
sudo dnf groupinstall "KDE Plasma Workspaces"
# Arch Linux
sudo pacman -S plasma plasma-desktop plasma-wayland-session kde-applications
```
---
## 3. Xfce

Xfce is a classic lightweight desktop environment that strikes an excellent balance between performance and features. It is especially suited to older hardware or users who want maximum efficiency.
### Pros
- **Very low resource usage**: runs smoothly with just 512MB of RAM
- **Stable and reliable**: a steady development pace with each release thoroughly tested
- **Highly configurable**: not as rich as KDE, but enough for most needs
- **Great remote experience**: its lightweight nature shines in remote desktops and virtual machines
- **Good modular design**: components can be upgraded and replaced independently
### Cons
- **Traditional visual style**: the default look is plain and lacks modern effects
- **Lagging Wayland support**: experimental Wayland support only started in version 4.20
- **Fewer bundled apps**: compared to GNOME and KDE, Xfce's bundled applications are more basic
### Installation
```bash
# Ubuntu/Xubuntu
sudo apt install xfce4 xfce4-goodies
# Fedora
sudo dnf groupinstall "Xfce Desktop"
# Arch Linux
sudo pacman -S xfce4 xfce4-goodies
```
---
## 4. Cinnamon

Cinnamon is a desktop environment developed by the Linux Mint team as a fork of GNOME 3, aiming to provide a traditional, familiar desktop with modern features. It is the default desktop environment of the Linux Mint flagship edition.
### Pros
- **Familiar traditional layout**: the bottom panel + application menu layout is very friendly to Windows users
- **Out-of-the-box experience**: Linux Mint has heavily optimized Cinnamon for immediate use
- **Applets and Desklets**: a rich ecosystem of desktop mini-programs
- **Stable GTK theme compatibility**: excellent support for themes and icon themes
- **Spices online store**: install extensions, themes, and applets directly through a GUI
### Cons
- **Relatively isolated ecosystem**: developed mainly around the Linux Mint ecosystem, so the experience on other distributions may not be as polished
- **Medium resource usage**: requires more memory than Xfce and LXQt
- **Slow Wayland progress**: Cinnamon still uses X11 as its primary display server
### Installation
```bash
# Ubuntu
sudo apt install cinnamon cinnamon-desktop-environment
# Fedora
sudo dnf install @cinnamon-desktop-environment
# Arch Linux
sudo pacman -S cinnamon cinnamon-translations
```
---
## 5. MATE

MATE is the continuation of GNOME 2, preserving the classic desktop interaction paradigm. It is both lightweight and fully featured — an excellent choice for users who want a traditional desktop experience.
### Pros
- **A direct descendant of GNOME 2**: keeps the classic bottom panel, application menu, and desktop icons
- **Lightweight and efficient**: lower resource usage than Cinnamon, close to Xfce levels
- **Full-featured**: provides a complete set of bundled apps (Caja file manager, Pluma text editor, etc.)
- **Good compatibility**: works perfectly with most GTK applications
### Cons
- **Slightly dated design language**: the interface lacks a modern feel, animations, and visual effects
- **Limited development resources**: a small maintenance team means slower new-feature development
- **Limited Wayland support**: still runs mainly on X11
### Installation
```bash
# Ubuntu/Ubuntu MATE
sudo apt install ubuntu-mate-desktop mate-desktop-environment
# Fedora
sudo dnf groupinstall "MATE Desktop"
# Arch Linux
sudo pacman -S mate mate-extra
```
---
## 6. LXQt

LXQt is the next generation of LXDE, combining LXDE's lightweight philosophy with the modern features of the Qt toolkit. It is the best choice for resource-constrained devices or users who want a minimal experience.
### Pros
- **Extremely lightweight**: runs with as little as 512MB of RAM and very low CPU usage
- **Modern Qt stack**: a more modern codebase than the GTK 2-based older LXDE
- **Modular design**: every component can be replaced independently
- **Active Wayland support**: since version 2.3.0, the Wayland session is no longer experimental
### Cons
- **Fairly basic features**: bundled apps and features are far less rich than KDE or GNOME
- **Minimal visuals**: the default look is plain
- **Limited app ecosystem**: few applications are developed specifically for LXQt
### Installation
```bash
# Ubuntu/Lubuntu
sudo apt install lxqt lxqt-core sddm
# Fedora
sudo dnf groupinstall "LXQt Desktop"
# Arch Linux
sudo pacman -S lxqt xdg-utils
```
---
## 7. Budgie

Budgie is a standalone desktop environment emphasizing simplicity, modernity, and elegance. Originally developed for the Solus distribution, it is now available on several mainstream distributions. Its core design philosophy is to "let the desktop stay out of the user's way."
### Pros
- **Clean, elegant design**: a tidy interface with no clutter
- **Raven sidebar**: integrates the notification center, calendar, media controls, and system settings
- **Multiple layout support**: easily switch to macOS-, Windows-, or Unity-like layouts
- **Built on the mature GNOME stack**: stability is assured
### Cons
- **Small development team**: updates are less frequent than GNOME and KDE
- **Limited extension ecosystem**: fewer applets available than GNOME and KDE
- **Varied support across distributions**: the experience and default configuration differ noticeably between distributions
### Installation
```bash
# Ubuntu/Ubuntu Budgie
sudo apt install ubuntu-budgie-desktop budgie-desktop
# Fedora
sudo dnf install @budgie-desktop-environment
# Arch Linux
sudo pacman -S budgie-desktop budgie-desktop-view
```
---
## 8. Deepin DDE

Deepin DDE (Deepin Desktop Environment) is developed by Wuhan Deepin Technology, known for its refined and beautiful UI design. Its visual experience rivals macOS and Windows 11, making it an ideal choice for users who value aesthetics.
### Pros
- **Exquisite visual design**: a unified rounded-corner design language, frosted-glass effects, and smooth animations
- **In-house DTK development framework**: provides a unified application development interface
- **Rich bundled in-house apps**: over 40 apps including Deepin Movie, Deepin Music, and Deepin Screenshot
- **Friendly Chinese support**: excellent native support for Chinese users and input methods
### Cons
- **Higher resource usage**: the beautiful visuals require stronger hardware
- **Security concerns**: the openSUSE security team has pointed out a lack of security culture in DDE
- **Limited support on mainstream distributions**: outside Deepin OS, the experience may not be perfect
- **Lower level of internationalization**: outside Chinese, localization quality varies
### Installation
```bash
# Ubuntu/UbuntuDDE
sudo add-apt-repository ppa:ubuntudde-dev/stable
sudo apt update
sudo apt install ubuntudde-dde
# Arch Linux
sudo pacman -S deepin deepin-extra deepin-kwin
# Fedora (requires a third-party repository)
sudo dnf install dde-control-center dde-dock dde-launcher deepin-desktop
```
---
## How to Choose the Right Desktop Environment
| Use Case | Recommended DE |
|---------|------------|
| Beginners, migrating from Windows | Cinnamon, KDE Plasma |
| Seeking beauty and modernity | Deepin DDE, GNOME |
| Older hardware or limited resources | Xfce, LXQt, MATE |
| Love deep customization | KDE Plasma |
| Prefer a keyboard-driven efficient workflow | GNOME (+ extensions) |
| Servers or remote desktops | Xfce, LXQt |
| Minimalism | Budgie, LXQt |
---
## Things to Keep in Mind
1. **Try it in a VM first**: to test a new desktop environment, use a virtual machine first to avoid affecting your main system
2. **Coexistence issues**: installing multiple desktop environments on one system can cause theme and setting conflicts; use different display managers to isolate them
3. **Incomplete uninstall risk**: removing a desktop environment may accidentally delete system components due to dependencies; use dedicated meta-package management tools
4. **Wayland vs. X11**: newer desktop environments (GNOME, KDE Plasma 6) fully support Wayland, but X11 still has compatibility advantages in some scenarios (such as screen sharing)
---
## Conclusion
The rich diversity of Linux desktop environments is a big part of its unique appeal. Whether you chase peak performance, love beautiful visuals, or are passionate about deep customization, there is a desktop environment for you. This freedom of choice is one of the irreplaceable core strengths of the Linux ecosystem.
Most importantly, you don't have to commit to one forever — you can switch and experiment at any time to find what best fits your workflow and personal preferences.
---
**References:**
- [GNOME Official Site](https://www.gnome.org)
- [KDE Plasma Official Site](https://kde.org/plasma-desktop)
- [Xfce Official Site](https://xfce.org)
- [Linux Mint / Cinnamon](https://linuxmint.com)
- [MATE Desktop](https://mate-desktop.org)
- [LXQt Project](https://lxqt-project.org)
- [Buddies of Budgie](https://buddiesofbudgie.org)
- [Deepin Community](https://www.deepin.org)
---
# IPtools 网络工具箱:Android 开源网络诊断工具,集成 Ping/端口扫描/路由追踪等 13 项功能
- Canonical: https://www.zeroxin.xin/2026/06/18/IPtools-%E7%BD%91%E7%BB%9C%E5%B7%A5%E5%85%B7%E7%AE%B1/
- Markdown: https://www.zeroxin.xin/2026/06/18/IPtools-%E7%BD%91%E7%BB%9C%E5%B7%A5%E5%85%B7%E7%AE%B1.md
- Published: 2026-06-18T10:00:00+08:00
- Updated: 2026-06-18T10:32:03+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, Android, 网络工具, Kotlin, MVVM
IPtools(网络工具箱)是一个开源的 Android 网络诊断应用,集成了 IP 查询、Ping、路由追踪、端口扫描、局域网扫描、DNS 查询、Whois、SSH、测速、子网计算等十余种网络工具,采用 Kotlin + MVVM + Hilt 架构
在日常开发和运维工作中,网络诊断工具几乎是每个人的必备品。但手机上能用的网络工具类 App 往往功能单一——有的只能 Ping,有的只能查 IP,很难找到一个能覆盖大部分网络诊断场景的集成工具。
**IPtools(网络工具箱)** 正是为解决这个痛点而生的开源 Android 应用。
项目地址:[https://github.com/xin-521/IPtools](https://github.com/xin-521/IPtools)
## 一、项目概览
IPtools 是一个**纯 Kotlin** 开发的 Android 网络工具集合应用,代码包名为 org.zeroxin.iptools,应用名称为"网络工具箱"。它把开发者/运维人员日常使用频率最高的网络诊断功能整合到一个 App 中,覆盖从基础连通性测试到高级端口扫描的完整链路。
当前版本 **v1.1**,目标 SDK 34(Android 14),最低支持 Android 7.0(API 24)。
### 为什么值得关注?
如果你是 Android 开发者,这个项目的代码质量、架构选型和技术栈都是一份很好的 MVVM + Hilt + Room + DataStore 参考实现。如果你只是用户,它可以替代手机上多个单一功能的网络工具。
## 二、完整功能清单
IPtools 内置了 **13 项网络工具**,分为基础工具和高级工具两大类。
### 基础网络工具(日常诊断)
| 工具 | 功能说明 |
| --- | --- |
| **我的 IP** | 查看本机公网 IP、归属地、ISP、ASN、经纬度,支持在地图上定位 |
| **局域网信息** | 显示当前 WiFi 连接详情:SSID、BSSID、信号强度、频率、网关、子网掩码、DNS 服务器、DHCP 信息 |
| **Ping 工具** | 测试网络连通性与延迟,支持自定义包数量、超时时间和包大小,提供连续 Ping 模式 |
| **路由追踪** | Traceroute,显示每一跳的 IP 和 RTT(三次探测),支持最大 30 跳 |
### 高级网络工具(深度诊断)
| 工具 | 功能说明 |
| --- | --- |
| **端口扫描** | TCP Connect 扫描,三种模式:快速扫描(23 个常用端口)、自定义端口范围、全端口扫描(1-65535,100 端口并行分批) |
| **局域网扫描** | 扫描局域网内 1-254 所有设备,检测 IP、MAC 地址、主机名、厂商信息(支持 Apple、小米、华为、Raspberry Pi、Espressif 等主流 OUI 识别) |
| **DNS 查询** | 支持 A/AAAA/MX/NS/TXT/CNAME 多种记录类型查询 |
| **DNS 基准测试** | 对比测试多个 DNS 服务器的解析速度 |
| **Whois 查询** | 查询域名注册信息:注册商、创建/到期日期、域名服务器等 |
| **SSH 工具** | 内置 SSH 客户端(基于 JSch 库),可直接连接远程服务器 |
| **网络测速** | 测试网络下载和上传速度 |
| **子网计算器** | 输入 IP/掩码,自动计算网络地址、广播地址、可用主机范围 |
| **MAC OUI 查询** | 根据 MAC 地址前缀查询设备厂商 |
| **Wake-on-LAN** | 远程唤醒局域网设备 |
### 辅助功能
- **IP 地图**:在 Leaflet WebView 地图上可视化显示 IP 位置
- **设置面板**:自定义 Ping 参数、扫描并发数、测速 URL、主题模式(亮色/暗色)
- **历史记录和收藏**:使用 Room 数据库保存查询历史和收藏,方便重复使用
## 三、技术栈与架构分析
从 Android 开发角度看,IPtools 的技术选型是现代 Android 开发的典型范本。
### 整体架构:MVVM
```
View (Fragment) → ViewModel → Repository → DataSource (Room/OkHttp/DataStore)
```
- **View 层**:基于 Android View System(XML 布局 + ViewBinding),使用 BottomNavigationView 构建底部导航
- **导航**:Navigation Component + nav_graph.xml 集中管理 Fragment 路由
- **ViewModel**:每个工具对应一个 ViewModel,持有协程作用域,通过 LiveData 向 UI 层暴露状态
- **Data 层**:Room 数据库(query_history + favorites 两张表)、Jetpack DataStore(用户设置持久化)、OkHttp/Retrofit(网络 API)
### 关键技术组件
| 类别 | 选型 | 用途 |
| --- | --- | --- |
| 语言 | **Kotlin** | 100% Kotlin,无 Java 混编 |
| DI | **Hilt**(Dagger + KSP) | 3 个 Module:AppModule、NetworkModule、ToolModule |
| 网络 | **OkHttp** + **Retrofit** + **Gson** | 调用 IP API、JSON 解析 |
| 数据库 | **Room** + **KSP** | 查询历史和收藏持久化 |
| 存储 | **Jetpack DataStore Preferences** | 设置项持久化 |
| 异步 | **Kotlin Coroutines** | 所有网络请求和工具执行均在 IO 调度器 |
| SSH | **JSch** (0.2.16) | SSH 客户端连接 |
| 地图 | **Leaflet.js**(WebView) | IP 位置可视化 |
### 值得关注的代码细节
1. **依赖注入设计的 ToolModule**:所有工具类(PingTool、PortScanner、TracerouteTool 等)均注册为 @Singleton,由 Hilt 统一管理生命周期。
2. **PortScanner 的分批并行扫描**:全端口扫描时按 100 端口一批分组,每组内通过 async/awaitAll 并发扫描,兼顾速度与资源控制。
3. **PingTool 的双层策略**:优先使用 Java InetAddress.isReachable() 实现跨平台兼容,同时保留 pingWithSystem() 回退到系统原生 ping -c 命令获取更准确的 ICMP 结果。
4. **LanScanner 的 OUI 识别**:内置了 Apple、小米、华为、三星、Raspberry Pi、Espressif(乐鑫)、TP-Link 等主流厂商的 MAC OUI 数据库,无需联网即可识别设备厂商。
5. **IP 后端 API**:使用 https://my.ippure.com/v1/info 作为 IP 查询接口(非 ip-api.com),说明开发者拥有独立的后端能力。
### 项目结构
```
app/src/main/
├── java/org/zeroxin/iptools/
│ ├── data/ # Room 数据库(DAO、Entity)
│ ├── di/ # Hilt 依赖注入模块
│ ├── model/ # 数据模型(IpInfo, PingResult, PortScanResult 等)
│ ├── network/ # 网络 API 服务(IpApiService)
│ ├── ui/
│ │ └── fragment/ # 所有 Fragment 界面
│ ├── util/ # 工具类(PingTool, PortScanner 等 14 个)
│ ├── viewmodel/ # 各页面的 ViewModel
│ ├── IpToolsApplication.kt
│ └── MainActivity.kt
├── res/
│ ├── layout/ # XML 布局文件
│ ├── drawable/ # 图标资源
│ ├── values/ # 字符串、颜色、主题
│ └── navigation/ # Navigation 导航图
└── AndroidManifest.xml
```
## 四、安装与构建
### 直接安装
这是 Android 原生应用,需要下载 APK 文件安装到 Android 设备上。请在项目的 [GitHub Releases 页面](https://github.com/xin-521/IPtools/releases) 查看是否有已构建的 APK。
### 自行构建
如果你有 Android 开发环境,可以自行编译:
**环境要求:**
- Android Studio Arctic Fox 或更高版本
- JDK 11+
- Android SDK 34
**构建步骤:**
```bash
git clone https://github.com/xin-521/IPtools.git
# 使用 Android Studio 打开项目
# 同步 Gradle 依赖
# 点击 Run 或运行:
./gradlew assembleDebug
```
构建产物为 app/build/outputs/apk/ 目录下的 NetworkTools-1.1-debug.apk。
### 所需权限
App 仅申请网络相关的最基本权限:
- INTERNET — 网络访问
- ACCESS_NETWORK_STATE — 查看网络状态
- ACCESS_WIFI_STATE — 查看 WiFi 信息
- CHANGE_WIFI_STATE — 修改 WiFi 状态(WOL 功能需要)
- CHANGE_NETWORK_STATE — 修改网络状态
未申请任何敏感权限(如位置、相机、存储),隐私保护做得比较干净。
## 五、适用场景
IPtools 的核心用户群体很明确——**开发者、运维人员、网工和 IT 爱好者**。
典型使用场景包括:
- **日常网络排查**:检查本机 IP、Ping 目标、路由追踪定位丢包节点
- **内网运维**:局域网扫描发现设备、端口扫描检查服务暴露情况、SSH 直连服务器
- **域名管理**:DNS 查询验证解析记录、Whois 查询域名注册信息、DNS 基准测试选最快的 DNS
- **网络规划**:子网计算器快速计算 CIDR 范围、广播地址
- **远程管理**:Wake-on-LAN 开机、SSH 远程维护
## 六、总结
IPtools 的价值在于"**集成**"二字。当手机上一个 App 就能完成 Ping、端口扫描、路由追踪、Whois、SSH 等一系列操作时,工作效率的提升是很明显的。从工程角度看,它的代码质量在线——MVVM 架构清晰,Hilt + Room + DataStore 的选型符合当前 Android 开发主流标准,工具类的设计和并发控制也有值得参考的地方。
如果你需要一款全功能的网络诊断 App,或者正在学习 Android 开发中的 MVVM + Hilt 实践,这个项目都值得看一看。
```
---
# Arkain :注册与首购最高可得 9,900 Credits
- Canonical: https://www.zeroxin.xin/2026/04/14/arkain-referral-rewards-introduction/
- Markdown: https://www.zeroxin.xin/2026/04/14/arkain-referral-rewards-introduction.md
- Published: 2026-04-14T12:00:00+08:00
- Updated: 2026-04-16T12:25:58+08:00
- Language: zh-CN
- Categories: 技术分享
- Tags: AI, Arkain, 容器平台, CDE, 邀请奖励, Credits
介绍 Arkain(AI-powered CDE)平台与邀请奖励机制:通过专属链接注册双方各得 300 credits,首次购买 credits($10 起)双方各得 600 credits,奖励含 7 天确认期,最高可达 9,900 credits。
如果你最近在关注“AI + 开发”的新形态,Arkain 是一个值得试试的平台:它把 **CDE(Cloud Development Environment,云开发环境)** 与 AI 能力结合起来,目标是让你更快把想法变成可运行的应用。
本文简单介绍 Arkain 平台,并把它的邀请奖励(Referral)机制用更清晰的方式整理出来,方便你在注册前快速了解“能拿到多少 credits、什么时候发放、需要满足什么条件”。
## Arkain 是什么?
容器平台:填写邀请码获得300Credit,想体验容器服务可以一试
官方介绍是:
> Try Arkain, an AI-powered CDE where apps come to life effortlessly.
你可以把它理解为一个偏“产品化”的云端开发环境:无需在本地折腾环境,也更容易把“写代码—运行—迭代—部署”的链路串起来,适合做原型、做小工具、做快速验证,或者在多设备之间无缝切换开发状态。
## 邀请奖励怎么拿?核心结论
Arkain 的邀请奖励会同时发放给 **邀请人(Referrer)** 和 **被邀请人(Referred Friend)**,并且分为两步:
### Step 1:好友通过邀请链接注册
- **好友**:+300 credits(即时发放)
- **你**:+300 credits(即时发放)
要点:
- 通过邀请链接注册时,推荐码通常会自动填入。
- 如果是手动输入推荐码,需要在注册时填写;**注册后无法补填(不能追溯)**。
### Step 2:好友首次购买 credits(首购奖励)
- **好友**:+600 credits
- **你**:+600 credits
要点(来自官方规则):
- **首购门槛**:好友首次购买 credits 需 **至少 \$10**。
- **发放时间**:首购完成后会进入 **7 天确认期**,奖励在 **00:00 UTC** 统一结算并发放。
## “最高 9,900 credits” 是怎么来的?
在 Arkain 的邀请页面中,会展示一个进度范围,标注为:
- Referral start:5,000
- earned:9,900
这通常表示邀请奖励存在一定的累计上限/阶段目标(页面显示最高到 **9,900 credits**)。不过页面里同时还有 “Expiration & Limits / Refunds & Exceptions / Fair play & Terms” 等条款入口,具体细则可能会调整。
## 我的专属注册链接(推荐码已自动填好)
如果你想直接体验并领取奖励,可以用我的链接注册(推荐码会自动带上):
- `https://account.arkain.io/signup?ref=FRD-04OTNC`
也可以在注册时手动填写推荐码(如果页面提供该入口):**FRD-04OTNC**
## 常见问题(按官方提示整理)
### 1)可以注册后再填推荐码吗?
不行。官方说明 **推荐码必须在注册时填写**,无法补填、无法追溯。
### 2)好友买了 credits,为什么 600 credits 还没到账?
首购奖励有 **7 天确认期**,并且在 **00:00 UTC** 发放。
---
*本文内容基于 Arkain 官方邀请页面信息整理(以官方页面条款为准)。*
---
# PageAgent:嵌入网页的 GUI 智能体,用自然语言控制 Web 界面
- Canonical: https://www.zeroxin.xin/2026/03/14/page-agent-introduction/
- Markdown: https://www.zeroxin.xin/2026/03/14/page-agent-introduction.md
- Published: 2026-03-14T12:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 技术分享
- Tags: PageAgent, AI Agent, 前端工具,自动化
PageAgent是阿里巴巴开源的网页内GUI智能体,无需浏览器扩展或Python环境即可通过自然语言控制Web界面。本文介绍其基于DOM文本操作的独特架构、JavaScript内嵌集成方式、LLM配置选项及多页面任务处理能力,探索AI Agent在前端领域的创新应用
## 项目概述
[PageAgent](https://github.com/alibaba/page-agent) 是阿里巴巴开源的一个创新项目,它被称为"生活在你的网页中的 GUI 智能体"。这个项目允许开发者通过自然语言来控制 Web 界面,无需浏览器扩展、Python 环境或无头浏览器,一切都发生在网页内部的 JavaScript 环境中。
### 核心特性
- **🎯 易于集成**:无需浏览器扩展/Python/无头浏览器,仅需页内 JavaScript
- **📖 基于文本的 DOM 操作**:不需要截图、多模态 LLM 或特殊权限
- **🧠 自带 LLM**:支持自定义大语言模型配置
- **🎨 精美 UI**:带有人类在环路的交互式界面
- **🐙 可选 Chrome 扩展**:支持多页面任务处理
## 技术架构
### 设计理念
PageAgent 的设计哲学是**客户端 Web 增强**,而非服务器端自动化。它基于优秀的 [browser-use](https://github.com/browser-use/browser-use) 项目进行构建,继承了其在 Web 自动化和 DOM 交互模式方面的最佳实践。
### 技术特点
1. **纯前端实现**:所有逻辑都在浏览器中运行,不需要后端服务
2. **文本化 DOM 操作**:通过分析 DOM 结构而非屏幕截图来理解页面
3. **LLM 驱动**:利用大语言模型理解自然语言指令并转化为 DOM 操作
4. **零权限要求**:不需要特殊的浏览器权限或扩展
## 快速开始
### 一行代码集成
最快的体验方式是使用官方提供的演示 CDN(使用免费的测试 LLM API):
```html
```
> ⚠️ 注意:此演示 CDN 仅用于技术评估,使用时需同意其条款。
### 国内镜像
为了获得更好的访问速度,可以使用国内镜像:
```html
```
### NPM 安装
对于生产环境,建议通过 NPM 安装:
```bash
npm install page-agent
```
### 编程式使用
```javascript
import { PageAgent } from 'page-agent'
const agent = new PageAgent({
model: 'qwen3.5-plus',
baseURL: 'https://dashscope.aliyuncs.com/compatible-mode/v1',
apiKey: 'YOUR_API_KEY',
language: 'en-US',
})
await agent.execute('点击登录按钮')
```
## 应用场景
### 1. SaaS AI 助手
在你的产品中快速集成 AI 助手功能,无需重写后端架构。只需几行代码,就能让用户通过自然语言与你的 SaaS 应用交互。
**示例场景**:
- 用户说"帮我创建一个新的项目",自动填写表单并提交
- 用户说"显示上周的数据报告",自动导航到报表页面并筛选时间范围
### 2. 智能表单填充
将需要多次点击的复杂工作流程简化为一句话。特别适合 ERP、CRM 和管理系统。
**示例场景**:
- 自动填写复杂的采购申请表单
- 批量更新客户信息
- 自动化数据录入任务
### 3. 无障碍访问
通过自然语言让任何 Web 应用对残障人士更加友好。支持语音命令、屏幕阅读器,实现零障碍交互。
**示例场景**:
- 视障用户通过语音命令操作网页
- 行动不便用户通过简单指令完成复杂操作
### 4. 跨页面智能体
通过可选的 Chrome 扩展,让你的智能体能够跨浏览器标签页工作,实现更复杂的自动化任务。
**示例场景**:
- 从一个页面抓取数据并填充到另一个页面
- 跨多个系统协调工作流程
- 自动化需要多步骤的业务流程
## 技术深度解析
### DOM 操作机制
PageAgent 不需要截图或使用多模态模型,它通过以下方式理解页面:
1. **DOM 树分析**:解析页面的 DOM 结构,提取可交互元素
2. **元素索引**:为每个可操作元素分配唯一标识
3. **文本化描述**:将页面结构转化为 LLM 可理解的文本格式
4. **指令映射**:将自然语言指令映射到具体的 DOM 操作
### LLM 集成
PageAgent 支持自定义 LLM 配置,这意味着:
- 可以使用阿里云通义千问(DashScope)
- 可以部署自己的 LLM 服务
- 可以根据需求选择不同的模型
- 完全控制 API 调用和成本
### 安全考虑
由于所有操作都在客户端进行,PageAgent 具有以下安全特性:
- **无服务器依赖**:不依赖外部服务器处理敏感数据
- **用户可控**:所有操作都在用户浏览器中执行
- **透明化**:用户可以清楚看到每一步操作
## 与其他方案的对比
| 特性 | PageAgent | 传统 RPA | 浏览器扩展 | 服务端自动化 |
|------|-----------|----------|------------|--------------|
| 部署难度 | 极低(一行代码) | 高 | 中 | 高 |
| 用户权限 | 无需特殊权限 | 需要 | 需要扩展权限 | 需要服务器 |
| 跨平台 | ✅ 所有现代浏览器 | ❌ 通常限平台 | ❌ 限特定浏览器 | ✅ 服务端 |
| 维护成本 | 低 | 高 | 中 | 高 |
| 用户体验 | 原生集成 | 独立应用 | 扩展图标 | 不可见 |
## 实际案例
### 案例 1:电商后台管理系统
**场景**:客服需要处理大量订单,每个订单需要在系统中进行多次点击和表单填写。
**解决方案**:
```javascript
// 集成 PageAgent 后,客服只需说:
"把订单#12345 的状态改为已发货,并发送通知邮件"
// PageAgent 自动执行:
// 1. 搜索订单#12345
// 2. 点击进入详情页
// 3. 点击"发货"按钮
// 4. 填写物流信息
// 5. 点击"发送通知"
```
**效果**:原本需要 5-6 次点击的操作,现在一句话完成。
### 案例 2:数据分析平台
**场景**:业务人员需要定期从多个维度查看数据报表。
**解决方案**:
```javascript
// 业务人员说:
"显示上个月华东地区的销售数据,按产品类别排序"
// PageAgent 自动:
// 1. 导航到报表页面
// 2. 选择时间范围为"上个月"
// 3. 筛选地区为"华东"
// 4. 设置排序为"按产品类别"
```
## 贡献与社区
PageAgent 是一个开源项目,欢迎社区贡献。项目遵循以下原则:
- 接受人类贡献,不接受完全由机器人/AI 生成的 PR
- 遵循 [CONTRIBUTING.md](https://github.com/alibaba/page-agent/blob/main/CONTRIBUTING.md) 中的指南
- 遵守行为准则
## 许可证
- **开源协议**:MIT License
- **版权信息**:Copyright (c) Alibaba
- **衍生项目**:基于 browser-use 项目构建(MIT License)
## 总结
PageAgent 代表了一种新的 Web 交互范式:将 AI 智能体直接嵌入到网页中,让用户能够用最自然的方式——语言——来操作界面。对于开发者来说,这意味着:
1. **极低的集成成本**:一行代码即可启用 AI 交互能力
2. **灵活的应用场景**:从简单的表单填充到复杂的跨页面工作流
3. **完全的控制权**:可以选择自己的 LLM,控制成本和性能
4. **更好的用户体验**:为用户提供更智能、更便捷的交互方式
随着大语言模型的普及和成熟,像 PageAgent 这样的工具将会成为 Web 应用的标准配置,让人机交互变得更加自然和高效。
## 相关链接
- **项目仓库**:[https://github.com/alibaba/page-agent](https://github.com/alibaba/page-agent)
- **在线演示**:[🚀 Demo](https://github.com/alibaba/page-agent)
- **官方文档**:[📖 Documentation](https://github.com/alibaba/page-agent)
- **browser-use 项目**:[https://github.com/browser-use/browser-use](https://github.com/browser-use/browser-use)
---
*本文基于 PageAgent 项目官方文档编写,项目信息截至 2026 年 3 月 14 日。*
---
# Neko Master:现代化的网络流量可视化分析面板
- Canonical: https://www.zeroxin.xin/2026/02/17/Neko-Master-%E7%BD%91%E7%BB%9C%E6%B5%81%E9%87%8F%E5%8F%AF%E8%A7%86%E5%8C%96%E5%88%86%E6%9E%90%E9%9D%A2%E6%9D%BF/
- Markdown: https://www.zeroxin.xin/2026/02/17/Neko-Master-%E7%BD%91%E7%BB%9C%E6%B5%81%E9%87%8F%E5%8F%AF%E8%A7%86%E5%8C%96%E5%88%86%E6%9E%90%E9%9D%A2%E6%9D%BF.md
- Published: 2026-02-17T10:00:00+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Tags: 开源项目, 网络监控, 流量分析, Docker
Neko-Master是一个功能强大的网络流量可视化分析面板,支持实时流量监控、数据包捕获、协议分析和图表化展示。本文介绍其架构设计、网络数据采集引擎、可视化仪表盘定制能力以及在企业网络运维和流量分析场景中的实际应用
在日常的网络管理和运维工作中,了解网络流量的使用情况是一项基础但重要的需求。无论是家庭网络还是小型企业环境,能够清晰地看到流量走向、识别异常访问、审计网络使用情况,都是保障网络安全和优化网络性能的关键。Neko Master 作为一款现代化的网络流量可视化与分析工具,为这一问题提供了优雅的解决方案。
Neko Master 是一个专注于网络流量分析与可视化的开源项目,如同其名字中的 "Neko"(日语中意为"猫")一样,它安静而敏锐,能够轻量、精确地对网络流量进行分析与可视化展示。
项目支持实时监控、流量审计、多网关管理,所有数据均来源于用户自有网络环境,不提供任何网络接入服务或代理订阅功能。
项目地址:https://github.com/foru17/neko-master
在线演示:https://neko-master.is26.com(访问密码:neko2026)
# 一、功能特性介绍
## 核心亮点
Neko Master 提供了完整的网络流量监控解决方案:
- **实时监控**:通过 WebSocket 实现数据的实时推送,让流量变化一目了然
- **流量审计**:详细记录和分析网络流量数据,支持历史查询和统计
- **多网关管理**:支持同时管理多个网关的流量数据,适合复杂网络环境
- **IP 地理位置查询**:支持本地 MMDB 数据库或在线查询,了解流量来源
- **数据可视化**:现代化的仪表盘界面,图表清晰直观
## 技术架构
项目采用现代化的技术栈构建:
- **前端**:Next.js + React,提供流畅的用户体验
- **后端**:Node.js,轻量高效
- **数据库**:SQLite,无需额外数据库服务,数据存储简单可靠
- **容器化**:完整的 Docker 支持,一键部署
## 安全与隐私
Neko Master 非常注重用户隐私和数据安全:
- 所有数据均来源于用户自有网络环境
- 不提供任何网络接入服务、代理订阅或跨网络连接功能
- 支持本地部署,数据完全由用户掌控
- 提供访问认证机制,保护面板安全
# 二、快速上手
## 方式一:Docker Compose(推荐)
最简部署方式,仅暴露 Web UI 端口:
```yaml
services:
neko-master:
image: foru17/neko-master:latest
container_name: neko-master
restart: unless-stopped
ports:
- "3000:3000"
volumes:
- ./data:/app/data
- ./geoip:/app/data/geoip:ro
environment:
- NODE_ENV=production
- DB_PATH=/app/data/stats.db
- COOKIE_SECRET=${COOKIE_SECRET}
```
建议在 `docker-compose.yml` 同目录创建 `.env` 文件配置 Cookie 密钥:
```bash
COOKIE_SECRET=<至少32字节随机字符串>
```
使用 `openssl rand -hex 32` 生成安全的随机字符串。
启动服务:
```bash
docker compose up -d
```
访问 http://localhost:3000 即可看到管理面板。
## 方式二:实时 WebSocket 部署
如果需要实时数据推送功能,可以额外暴露 WebSocket 端口:
```yaml
services:
neko-master:
image: foru17/neko-master:latest
container_name: neko-master
restart: unless-stopped
ports:
- "3000:3000"
- "3002:3002"
volumes:
- ./data:/app/data
- ./geoip:/app/data/geoip:ro
environment:
- NODE_ENV=production
- DB_PATH=/app/data/stats.db
- COOKIE_SECRET=${COOKIE_SECRET}
```
## 方式三:一键脚本
对于不熟悉 Docker 的用户,项目提供了自动检测端口冲突并配置的一键脚本:
```bash
curl -fsSL https://raw.githubusercontent.com/foru17/neko-master/main/setup.sh | bash
```
脚本会自动完成以下工作:
- 下载 docker-compose.yml 配置文件
- 检测默认端口(3000/3001/3002)是否被占用
- 提供可用的替代端口选项
- 创建配置文件并启动服务
## 方式四:源码运行
开发者可以选择源码方式运行:
```bash
git clone https://github.com/foru17/neko-master.git
cd neko-master
pnpm install
cp apps/collector/.env.example apps/collector/.env
pnpm dev
```
访问 http://localhost:3000 即可使用。
# 三、接入网关数据
Neko Master 支持接入多种网关的流量数据,以 Clash 为例:
1. 在 Clash 配置文件中添加 RESTful API 支持:
```yaml
external-controller: 0.0.0.0:9090
secret: "your-secret"
```
2. 在 Neko Master 面板的设置页面添加网关配置:
- 名称:自定义网关名称
- 地址:Clash API 地址(如 `http://192.168.1.1:9090`)
- 密钥:Clash 配置的 secret
添加完成后,面板会自动开始收集和展示该网关的流量数据。
# 四、总结
Neko Master 是一款设计优雅、功能实用的网络流量分析工具。从安装到使用,整个过程非常轻量化,通过 Docker 即可快速部署。
对于有网络流量监控需求的用户,无论是家庭网络管理还是小型企业运维,都可以尝试这个工具。它的实时监控和流量审计功能,能够帮助你更好地了解和管控网络使用情况。
项目遵循 MIT 协议开源,欢迎有开发能力的用户参与贡献。
---
# EverMsg:永久记录在比特币区块链上的永恒印记
- Canonical: https://www.zeroxin.xin/2026/01/18/evermsg-introduction/
- Markdown: https://www.zeroxin.xin/2026/01/18/evermsg-introduction.md
- Published: 2026-01-18T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: EverMsg, 比特币, 永恒印记, 区块链, OP_RETURN, Web3
EverMsg是一个现代化的比特币OP_RETURN数据浏览器,展示被永久刻入区块链的不可篡改信息。本文介绍比特币永恒印记的原理、OP_RETURN数据结构、使用场景以及如何通过EverMsg浏览和验证这些与区块链共存亡的历史记录,感受去中心化存储的独特魅力
在数字化时代,信息的保存往往面临着被删除、篡改或丢失的风险。然而,区块链技术的出现为信息的永恒存储提供了可能。**EverMsg** 正是这样一个致力于挖掘和展示这些永恒印记的平台。
## 什么是 EverMsg?
[EverMsg](https://www.evermsg.com/zh) 是一个现代化的比特币 **OP_RETURN** 数据浏览器。它的核心理念是:"每一条印记都被永久记录在区块链上,不可篡改,永不消失。"
通过 EverMsg,用户可以浏览那些被刻入比特币区块链的各种信息。这些信息与比特币共存亡,只要比特币网络还在运行,这些数据就永远存在。
## 核心特性
### 1. 永久存储
EverMsg 展示的消息并非存储在普通的中心化服务器上,而是直接刻入比特币区块链。这意味着这些消息与区块链共存亡,实现了真正意义上的永久存储。
### 2. 不可篡改
基于区块链的特性,一旦消息通过 OP_RETURN 写入区块并被确认,就成为不可变历史的一部分。任何人都无法修改、删除或审查这些内容,甚至连原始发送者也不行。
### 3. 全球可见
区块链是公开透明的账本,世界上任何人都可以查阅这些永恒的印记。EverMsg 提供了一个用户友好的界面,将这些技术性的链上数据转化为易读的格式,供全球用户浏览。
## 技术原理:OP_RETURN
EverMsg 的技术基础是比特币脚本中的 **OP_RETURN** 操作码。
- **功能**:允许用户在比特币交易中嵌入最多 **80 字节** 的任意数据。
- **应用**:非常适合存储简短的消息、誓言、时间戳、存证或任何希望永久保存的简短文本。
- **即时性**:新的 OP_RETURN 消息通常在比特币网络确认后几分钟内即可在 EverMsg 上检索到。
## 常见问题解答
**Q: 使用 EverMsg 浏览消息需要付费吗?**
A: 不需要。在 EverMsg 上浏览和阅读 OP_RETURN 消息是完全免费的。
**Q: 如何发布自己的永恒印记?**
A: EverMsg 本身是一个浏览器。要创建 OP_RETURN 交易(即发布消息),您需要使用支持此功能的比特币钱包或通过专门的服务。发布消息时,您需要向矿工支付比特币交易费用。
**Q: 它可以支持哪些语言?**
A: EverMsg 支持任何语言的消息。其界面本身也支持英语、中文、日语、韩语和西班牙语,并提供自动语言检测和筛选功能。
## 结语
EverMsg 不仅仅是一个工具,它更像是一个数字时代的"铭文墙"。在这里,你可以看到人们留下的各种讯息——可能是对爱人的誓言,可能是对某个时刻的纪念,也可能是某种思想的表达。
探索比特币区块链上的永恒消息,见证人类在数字时代留下的不可磨灭的印记。
[访问 EverMsg 官网](https://www.evermsg.com/zh)
---
# RaTeX:革命性的LaTeX实时渲染工具
- Canonical: https://www.zeroxin.xin/2025/12/28/ratex-introduction/
- Markdown: https://www.zeroxin.xin/2025/12/28/ratex-introduction.md
- Published: 2025-12-28T00:00:00+08:00
- Updated: 2026-06-18T17:21:27+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, LaTeX, 文档编辑, 实时渲染, 学术写作
RaTeX是一款创新的LaTeX实时渲染工具,将传统的手动编译预览流程转变为即时所见即所得的编辑体验。本文介绍其核心特性包括实时渲染引擎、代码智能补全系统、现代化界面设计以及为学术写作和文档排版带来的效率提升,让论文撰写更加轻松高效
## 项目概述
[RaTeX](https://github.com/erweixin/RaTeX) 是一款专为LaTeX用户设计的实时渲染工具,它将传统的"编写-编译-预览"工作流程转变为流畅的实时编辑体验。通过即时渲染技术,RaTeX让用户能够在输入LaTeX代码的同时看到最终效果,极大提升了文档编写效率。
### 核心特性
- **⚡ 实时渲染**:输入即所见,无需等待编译
- **🎯 智能补全**:LaTeX命令和环境的智能提示
- **📱 现代化界面**:简洁直观的用户体验
- **🔧 轻量高效**:快速启动,低资源占用
- **🌐 跨平台支持**:支持主流操作系统
## 为什么选择RaTeX?
### 传统LaTeX编辑器的痛点
传统的LaTeX编辑流程存在诸多不便:
1. **编译等待**:每次修改都需要重新编译,打断思路
2. **错误定位困难**:编译错误信息不够直观
3. **预览不便**:需要在编辑器和PDF查看器间切换
4. **学习曲线陡峭**:新手难以快速上手
### RaTeX的解决方案
RaTeX通过创新的实时渲染技术,完美解决了这些问题:
- **即时反馈**:输入代码立即看到效果,所见即所得
- **错误提示**:实时显示语法错误,快速定位问题
- **统一界面**:编辑和预览在同一窗口,无需切换
- **降低门槛**:直观的操作方式,新手友好
## 核心功能详解
### 1. 实时渲染引擎
RaTeX的核心是其高性能的实时渲染引擎:
**技术特点**:
- 增量渲染:只更新修改部分,提升性能
- 异步处理:不阻塞编辑操作
- 智能缓存:减少重复计算
**渲染速度**:
- 简单公式:< 10ms
- 复杂文档:< 100ms
- 大型项目:< 500ms
### 2. 智能编辑辅助
**命令补全**:
- 自动提示LaTeX命令
- 参数提示和说明
- 常用模板快速插入
**语法高亮**:
- 多层次语法着色
- 括号匹配提示
- 错误标记显示
**代码片段**:
- 内置常用模板
- 自定义代码片段
- 快捷键快速插入
### 3. 数学公式支持
RaTeX对数学公式提供了完善的支持:
**行内公式**:
```latex
$E = mc^2$
```
**独立公式**:
```latex
$$
\int_{-\infty}^{\infty} e^{-x^2} dx = \sqrt{\pi}
$$
```
**复杂环境**:
- align环境
- matrix环境
- cases环境
- 自定义环境
### 4. 文档结构管理
**大纲视图**:
- 章节结构一目了然
- 快速跳转定位
- 拖拽调整顺序
**引用管理**:
- 自动识别标签
- 智能引用补全
- 交叉引用检查
**图表管理**:
- 图片预览
- 表格可视化编辑
- 浮动体位置调整
## 使用场景
### 学术论文写作
**适用场景**:
- 期刊论文撰写
- 学位论文编写
- 会议论文投稿
- 技术报告制作
**优势**:
- 实时预览公式效果
- 快速调整格式
- 高效管理参考文献
- 符合学术规范
### 数学教学
**教师应用**:
- 制作课件
- 编写习题
- 准备讲义
- 设计试卷
**学生应用**:
- 完成作业
- 记录笔记
- 准备报告
- 学习LaTeX
### 技术文档
**文档类型**:
- API文档
- 技术手册
- 用户指南
- 开发文档
**特点**:
- 代码高亮
- 图表丰富
- 格式统一
- 易于维护
## 快速开始
### 安装方法
**从源码安装**:
```bash
git clone https://github.com/erweixin/RaTeX.git
cd RaTeX
# 按照README中的说明进行安装
```
**系统要求**:
- 操作系统:Windows/macOS/Linux
- 内存:建议4GB以上
- 存储:200MB可用空间
### 基本使用
**创建新文档**:
1. 启动RaTeX
2. 选择"新建文档"
3. 选择文档模板
4. 开始编写
**编辑文档**:
1. 在左侧编辑器输入LaTeX代码
2. 右侧实时显示渲染效果
3. 使用工具栏快速插入元素
4. 保存或导出文档
**常用快捷键**:
- `Ctrl+S`:保存文档
- `Ctrl+B`:加粗文本
- `Ctrl+I`:斜体文本
- `Ctrl+M`:插入数学公式
- `Ctrl+L`:插入列表
## 技术架构
### 前端技术
**渲染引擎**:
- 基于MathJax/KaTeX
- 自定义渲染优化
- WebGL加速(可选)
**编辑器**:
- Monaco Editor集成
- 自定义语法解析
- 智能补全引擎
**界面框架**:
- 现代化UI设计
- 响应式布局
- 主题定制支持
### 后端技术
**文档处理**:
- LaTeX解析器
- 语法树生成
- 错误检测
**性能优化**:
- 增量编译
- 并行处理
- 内存管理
## 与其他工具对比
| 特性 | RaTeX | Overleaf | TeXstudio |
|------|-------|----------|-----------|
| 实时渲染 | ✅ 即时 | ⚠️ 延迟 | ❌ 需编译 |
| 离线使用 | ✅ 完全支持 | ❌ 需联网 | ✅ 完全支持 |
| 学习曲线 | ✅ 平缓 | ⚠️ 中等 | ⚠️ 陡峭 |
| 资源占用 | ✅ 轻量 | ⚠️ 依赖网络 | ⚠️ 较重 |
| 协作功能 | 🔄 开发中 | ✅ 完善 | ❌ 不支持 |
| 开源免费 | ✅ 完全开源 | ⚠️ 部分免费 | ✅ 开源 |
## 实际应用案例
### 案例1:学术论文写作
**场景**:博士生撰写学位论文
**使用体验**:
- 实时预览公式,快速调整格式
- 大纲视图管理章节结构
- 引用管理简化文献引用
- 提高写作效率50%以上
### 案例2:数学课件制作
**场景**:大学教师制作微积分课件
**使用体验**:
- 快速插入数学公式
- 实时调整排版效果
- 图表编辑直观便捷
- 课件制作时间减半
### 案例3:技术文档编写
**场景**:开发团队编写API文档
**使用体验**:
- 代码高亮清晰
- 格式统一规范
- 易于版本控制
- 团队协作高效
## 社区与支持
### 开源社区
**项目信息**:
- GitHub仓库:[erweixin/RaTeX](https://github.com/erweixin/RaTeX)
- 开源协议:MIT License
- 活跃开发:持续更新
**参与方式**:
- 提交Issue反馈问题
- 贡献代码改进功能
- 完善文档和教程
- 分享使用经验
### 获取帮助
**文档资源**:
- 官方文档
- 使用教程
- 常见问题
- 视频演示
**社区支持**:
- GitHub Discussions
- 用户交流群
- 技术博客
- 在线论坛
## 未来发展
### 短期计划
**功能增强**:
- 协作编辑功能
- 云端同步支持
- 更多模板库
- 插件系统
**性能优化**:
- 渲染速度提升
- 内存占用优化
- 启动速度改进
- 大文档支持
### 长期愿景
**生态建设**:
- 插件市场
- 模板社区
- 在线服务
- 移动端支持
**技术创新**:
- AI辅助写作
- 智能排版
- 自动校对
- 多人协作
## 最佳实践
### 编写建议
1. **合理组织结构**
- 使用章节命令
- 保持层次清晰
- 适当添加注释
2. **优化渲染性能**
- 避免过度嵌套
- 合理使用宏定义
- 控制文档大小
3. **提高可维护性**
- 模块化编写
- 统一命名规范
- 版本控制管理
### 常见问题
**Q1: RaTeX支持中文吗?**
A: 完全支持中文,包括中文字体和CJK环境。
**Q2: 如何导出PDF?**
A: 使用导出功能,选择PDF格式即可。
**Q3: 支持自定义模板吗?**
A: 支持,可以创建和导入自定义模板。
**Q4: 渲染速度慢怎么办?**
A: 检查文档复杂度,优化代码结构,关闭不必要的功能。
**Q5: 如何报告Bug?**
A: 在GitHub仓库提交Issue,详细描述问题和复现步骤。
## 总结
RaTeX作为一款创新的LaTeX实时渲染工具,通过即时预览、智能补全和现代化界面,极大地改善了LaTeX文档的编写体验。无论是学术写作、教学应用还是技术文档编写,RaTeX都能提供高效、便捷的解决方案。
**核心优势**:
- ✅ 实时渲染,即时反馈
- ✅ 智能辅助,提升效率
- ✅ 现代界面,易于使用
- ✅ 开源免费,持续更新
- ✅ 跨平台,适用广泛
对于LaTeX用户来说,RaTeX是一个值得尝试的优秀工具。它不仅保留了LaTeX的强大功能,还通过创新的实时渲染技术,让文档编写变得更加流畅和高效。
---
**相关链接**:
- GitHub仓库:[https://github.com/erweixin/RaTeX](https://github.com/erweixin/RaTeX)
- 项目文档:查看仓库README
- 问题反馈:GitHub Issues
**标签**:#LaTeX #实时渲染 #开源项目 #文档编辑 #学术写作 #数学公式
---
# Xget 生态系统集成
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-ecosystem-integration/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-ecosystem-integration.md
- Published: 2025-12-27T16:30:00+08:00
- Updated: 2026-06-18T17:21:22+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 生态系统, 集成
详细介绍Xget与Visual Studio Code、JetBrains等IDE、CI/CD流水线、包管理器(npm、pip、docker、maven)等开发工具的深度集成方案。本文展示如何通过简单配置让Xget无缝融入日常开发工作流,为各类开发者资源提供统一的加速体验
## 概述
本文档详细介绍了 Xget 与各种开发工具、平台和服务的集成方式。通过深度集成,Xget 能够无缝融入开发者的日常工作流程,提供统一的加速体验。
## IDE 集成
### Visual Studio Code
#### 配置 Git 加速
在 VS Code 中配置 Git 使用 Xget:
```json
{
"git.enabled": true,
"git.path": "git",
"git.autofetch": true,
"git.enableSmartCommit": true,
"git.postCommitCommand": "none",
"git.confirmSync": false,
"git.suggestSmartCommit": true,
"git.useEditorAsCommitInput": true
}
```
**配置 Git 配置文件**
在项目根目录创建 `.gitconfig`:
```
[url "https://xget.xi-xu.me/gh/"]
insteadOf = https://github.com/
```
**使用 GitLens 扩展**
安装 GitLens 扩展后,在设置中配置:
```json
{
"gitlens.advanced.messages": {
"suppressCommitHasNoPreviousCommitWarning": false,
"suppressCommitNotFoundWarning": false,
"suppressFileNotUnderSourceControlWarning": false,
"suppressGitDisabledWarning": false,
"suppressLineUncommittedWarning": false,
"suppressNoRepositoryWarning": false,
"suppressResultsExplorerNotice": false,
"suppressShowKeyBindingsNotice": false,
"suppressUpdateNotice": false,
"suppressWelcomeNotice": false
}
}
```
#### 配置 npm 加速
在 VS Code 中配置 npm 使用 Xget:
```json
{
"npm.packageManager": "npm",
"npm.enableScriptExplorer": true,
"npm.enableRunFromFolder": true,
"npm.exclude": "**/node_modules/**",
"npm.include": "**/package.json"
}
```
**创建 .npmrc 文件**
在项目根目录创建 `.npmrc`:
```
registry=https://xget.xi-xu.me/npm
```
#### 配置 Python 加速
在 VS Code 中配置 Python 使用 Xget:
```json
{
"python.defaultInterpreterPath": "python",
"python.terminal.activateEnvironment": true,
"python.linting.enabled": true,
"python.linting.pylintEnabled": true,
"python.formatting.provider": "black"
}
```
**创建 pip.conf 文件**
在项目根目录创建 `pip.conf`:
```ini
[global]
index-url = https://xget.xi-xu.me/pypi
```
### IntelliJ IDEA
#### 配置 Git 加速
在 IDEA 中配置 Git 使用 Xget:
1. 打开 Settings → Version Control → Git
2. 在 SSH executable 中选择 Built-in
3. 在 Environment variables 中添加:
```
GIT_SSH_COMMAND=ssh -o ProxyCommand="ssh -W %h:%p git@xget.xi-xu.me"
```
#### 配置 Maven 加速
在 IDEA 中配置 Maven 使用 Xget:
1. 打开 Settings → Build, Execution, Deployment → Build Tools → Maven
2. 在 User settings file 中配置:
```xml
xget-maven
central
Xget Maven Mirror
https://xget.xi-xu.me/maven2
```
#### 配置 Gradle 加速
在 IDEA 中配置 Gradle 使用 Xget:
1. 打开 Settings → Build, Execution, Deployment → Build Tools → Gradle
2. 在 Gradle JVM 中选择合适的 JDK
3. 在 build.gradle 中配置:
```groovy
repositories {
maven { url 'https://xget.xi-xu.me/maven2' }
mavenCentral()
}
```
### PyCharm
#### 配置 Git 加速
在 PyCharm 中配置 Git 使用 Xget:
1. 打开 Settings → Version Control → Git
2. 在 SSH executable 中选择 Built-in
3. 在 Environment variables 中添加:
```
GIT_SSH_COMMAND=ssh -o ProxyCommand="ssh -W %h:%p git@xget.xi-xu.me"
```
#### 配置 pip 加速
在 PyCharm 中配置 pip 使用 Xget:
1. 打开 Settings → Project → Python Interpreter
2. 点击齿轮图标 → Show All
3. 在 Package Manager 中配置:
```ini
[global]
index-url = https://xget.xi-xu.me/pypi
```
### WebStorm
#### 配置 Git 加速
在 WebStorm 中配置 Git 使用 Xget:
1. 打开 Settings → Version Control → Git
2. 在 SSH executable 中选择 Built-in
3. 在 Environment variables 中添加:
```
GIT_SSH_COMMAND=ssh -o ProxyCommand="ssh -W %h:%p git@xget.xi-xu.me"
```
#### 配置 npm 加速
在 WebStorm 中配置 npm 使用 Xget:
1. 打开 Settings → Languages & Frameworks → Node.js and NPM
2. 在 Package manager 中选择 npm
3. 在项目中创建 `.npmrc`:
```
registry=https://xget.xi-xu.me/npm
```
## CI/CD 集成
### GitHub Actions
#### 基本配置
在 GitHub Actions 中配置 Xget:
```yaml
name: Build and Test
on: [push, pull_request]
jobs:
build:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- name: Setup Node.js
uses: actions/setup-node@v4
with:
node-version: '20'
registry-url: 'https://xget.xi-xu.me/npm'
- name: Install dependencies
run: npm ci
- name: Build
run: npm run build
- name: Test
run: npm test
```
#### Git 配置
在 GitHub Actions 中配置 Git 使用 Xget:
```yaml
- name: Configure Git
run: |
git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
git config --global url."https://xget.xi-xu.me/gl/".insteadOf "https://gitlab.com/"
```
#### Docker 配置
在 GitHub Actions 中配置 Docker 使用 Xget:
```yaml
- name: Configure Docker
run: |
echo '{"registry-mirrors": ["https://xget.xi-xu.me/cr/registry-1.docker.io"]}' | sudo tee /etc/docker/daemon.json
sudo systemctl restart docker
```
#### Python 配置
在 GitHub Actions 中配置 Python 使用 Xget:
```yaml
- name: Setup Python
uses: actions/setup-python@v5
with:
python-version: '3.11'
- name: Configure pip
run: |
pip config set global.index-url https://xget.xi-xu.me/pypi
```
### GitLab CI
#### 基本配置
在 GitLab CI 中配置 Xget:
```yaml
image: node:20
variables:
NPM_CONFIG_REGISTRY: "https://xget.xi-xu.me/npm"
PIP_INDEX_URL: "https://xget.xi-xu.me/pypi"
before_script:
- npm ci
stages:
- build
- test
build:
stage: build
script:
- npm run build
test:
stage: test
script:
- npm test
```
#### Git 配置
在 GitLab CI 中配置 Git 使用 Xget:
```yaml
before_script:
- git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
- git config --global url."https://xget.xi-xu.me/gl/".insteadOf "https://gitlab.com/"
```
#### Docker 配置
在 GitLab CI 中配置 Docker 使用 Xget:
```yaml
services:
- docker:dind
variables:
DOCKER_HOST: tcp://docker:2375
DOCKER_TLS_CERTDIR: ""
before_script:
- echo '{"registry-mirrors": ["https://xget.xi-xu.me/cr/registry-1.docker.io"]}' | tee /etc/docker/daemon.json
- dockerd &
- sleep 5
```
### Jenkins
#### 基本配置
在 Jenkins 中配置 Xget:
```groovy
pipeline {
agent any
environment {
NPM_CONFIG_REGISTRY = 'https://xget.xi-xu.me/npm'
PIP_INDEX_URL = 'https://xget.xi-xu.me/pypi'
}
stages {
stage('Checkout') {
steps {
checkout scm
}
}
stage('Install') {
steps {
sh 'npm ci'
}
}
stage('Build') {
steps {
sh 'npm run build'
}
}
stage('Test') {
steps {
sh 'npm test'
}
}
}
}
```
#### Git 配置
在 Jenkins 中配置 Git 使用 Xget:
```groovy
stage('Configure Git') {
steps {
sh '''
git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
git config --global url."https://xget.xi-xu.me/gl/".insteadOf "https://gitlab.com/"
'''
}
}
```
### Azure DevOps
#### 基本配置
在 Azure DevOps 中配置 Xget:
```yaml
trigger:
- main
pool:
vmImage: 'ubuntu-latest'
variables:
NPM_CONFIG_REGISTRY: 'https://xget.xi-xu.me/npm'
PIP_INDEX_URL: 'https://xget.xi-xu.me/pypi'
steps:
- task: NodeTool@0
inputs:
versionSpec: '20.x'
displayName: 'Install Node.js'
- script: |
npm ci
displayName: 'Install dependencies'
- script: |
npm run build
displayName: 'Build'
- script: |
npm test
displayName: 'Test'
```
#### Git 配置
在 Azure DevOps 中配置 Git 使用 Xget:
```yaml
- script: |
git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
git config --global url."https://xget.xi-xu.me/gl/".insteadOf "https://gitlab.com/"
displayName: 'Configure Git'
```
## 包管理器集成
### npm
#### 全局配置
```bash
# 设置 npm 注册表
npm config set registry https://xget.xi-xu.me/npm
# 验证配置
npm config get registry
```
#### 项目配置
在项目根目录创建 `.npmrc`:
```
registry=https://xget.xi-xu.me/npm
```
#### 使用示例
```bash
# 安装包
npm install react
# 安装特定版本
npm install react@18.2.0
# 全局安装
npm install -g typescript
```
### yarn
#### 全局配置
```bash
# 设置 yarn 注册表
yarn config set registry https://xget.xi-xu.me/npm
# 验证配置
yarn config get registry
```
#### 项目配置
在项目根目录创建 `.yarnrc`:
```
registry "https://xget.xi-xu.me/npm"
```
#### 使用示例
```bash
# 安装包
yarn add react
# 安装特定版本
yarn add react@18.2.0
# 全局安装
yarn global add typescript
```
### pnpm
#### 全局配置
```bash
# 设置 pnpm 注册表
pnpm config set registry https://xget.xi-xu.me/npm
# 验证配置
pnpm config get registry
```
#### 项目配置
在项目根目录创建 `.npmrc`:
```
registry=https://xget.xi-xu.me/npm
```
#### 使用示例
```bash
# 安装包
pnpm add react
# 安装特定版本
pnpm add react@18.2.0
# 全局安装
pnpm add -g typescript
```
### pip
#### 全局配置
```bash
# 创建 pip 配置目录
mkdir -p ~/.pip
# 创建配置文件
cat > ~/.pip/pip.conf << EOF
[global]
index-url = https://xget.xi-xu.me/pypi
EOF
# 验证配置
pip config get global.index-url
```
#### 项目配置
在项目根目录创建 `pip.conf`:
```ini
[global]
index-url = https://xget.xi-xu.me/pypi
```
#### 使用示例
```bash
# 安装包
pip install requests
# 安装特定版本
pip install requests==2.31.0
# 从 requirements.txt 安装
pip install -r requirements.txt
```
### Poetry
#### 全局配置
```bash
# 设置 Poetry 源
poetry source add --priority=primary xget https://xget.xi-xu.me/pypi
# 验证配置
poetry source show
```
#### 项目配置
在 `pyproject.toml` 中配置:
```toml
[tool.poetry.source]
name = "xget"
url = "https://xget.xi-xu.me/pypi"
priority = "primary"
```
#### 使用示例
```bash
# 安装依赖
poetry install
# 添加包
poetry add requests
# 更新依赖
poetry update
```
### conda
#### 全局配置
```bash
# 添加 Xget 作为频道
conda config --add channels https://xget.xi-xu.me/conda/pkgs/main
# 验证配置
conda config --show channels
```
#### 项目配置
在项目根目录创建 `.condarc`:
```yaml
channels:
- https://xget.xi-xu.me/conda/pkgs/main
- defaults
```
#### 使用示例
```bash
# 安装包
conda install python=3.11
# 从特定频道安装
conda install -c https://xget.xi-xu.me/conda/community/conda-forge pytorch
```
### Maven
#### 全局配置
编辑 `~/.m2/settings.xml`:
```xml
xget-maven
central
Xget Maven Mirror
https://xget.xi-xu.me/maven2
```
#### 项目配置
在 `pom.xml` 中配置:
```xml
xget
https://xget.xi-xu.me/maven2
```
#### 使用示例
```bash
# 下载依赖
mvn dependency:resolve
# 构建项目
mvn clean install
```
### Gradle
#### 全局配置
编辑 `~/.gradle/init.gradle`:
```groovy
allprojects {
repositories {
maven { url 'https://xget.xi-xu.me/maven2' }
mavenCentral()
}
}
```
#### 项目配置
在 `build.gradle` 中配置:
```groovy
repositories {
maven { url 'https://xget.xi-xu.me/maven2' }
mavenCentral()
}
```
#### 使用示例
```bash
# 下载依赖
./gradlew dependencies
# 构建项目
./gradlew build
```
## 容器集成
### Docker
#### 配置 Docker 镜像
编辑 `/etc/docker/daemon.json`:
```json
{
"registry-mirrors": [
"https://xget.xi-xu.me/cr/registry-1.docker.io"
]
}
```
重启 Docker:
```bash
sudo systemctl restart docker
```
#### 使用示例
```bash
# 拉取镜像
docker pull nginx:latest
# 拉取特定标签
docker pull nginx:1.25
# 构建镜像
docker build -t myapp .
```
#### Dockerfile 配置
在 Dockerfile 中配置:
```dockerfile
FROM node:20
# 配置 npm 使用 Xget
RUN npm config set registry https://xget.xi-xu.me/npm
# 安装依赖
COPY package*.json ./
RUN npm ci
# 复制源码
COPY . .
# 构建应用
RUN npm run build
# 启动应用
CMD ["npm", "start"]
```
### Kubernetes
#### 配置镜像拉取
在 Kubernetes 中配置 Docker 镜像加速:
```yaml
apiVersion: v1
kind: ConfigMap
metadata:
name: docker-config
data:
daemon.json: |
{
"registry-mirrors": [
"https://xget.xi-xu.me/cr/registry-1.docker.io"
]
}
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
name: docker-config
spec:
selector:
matchLabels:
app: docker-config
template:
metadata:
labels:
app: docker-config
spec:
containers:
- name: docker-config
image: alpine
command: ["/bin/sh", "-c"]
args:
- |
mkdir -p /etc/docker
echo '{"registry-mirrors": ["https://xget.xi-xu.me/cr/registry-1.docker.io"]}' > /etc/docker/daemon.json
sleep infinity
volumeMounts:
- name: docker-config
mountPath: /etc/docker
volumes:
- name: docker-config
configMap:
name: docker-config
```
#### 使用示例
```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
name: myapp
spec:
replicas: 3
selector:
matchLabels:
app: myapp
template:
metadata:
labels:
app: myapp
spec:
containers:
- name: myapp
image: nginx:latest
ports:
- containerPort: 80
```
### Podman
#### 配置 Podman 镜像
编辑 `/etc/containers/registries.conf`:
```ini
unqualified-search-registries = ["docker.io", "registry.fedoraproject.org", "quay.io"]
[[registry]]
prefix = "docker.io"
location = "xget.xi-xu.me/cr/registry-1.docker.io"
insecure = false
blocked = false
mirror-by-digest-only = false
```
#### 使用示例
```bash
# 拉取镜像
podman pull nginx:latest
# 拉取特定标签
podman pull nginx:1.25
# 运行容器
podman run -d -p 80:80 nginx:latest
```
## 云平台集成
### AWS
#### 配置 AWS CodeBuild
在 AWS CodeBuild 中配置 Xget:
```yaml
version: 0.2
phases:
install:
runtime-versions:
nodejs: 20
commands:
- npm config set registry https://xget.xi-xu.me/npm
- npm ci
build:
commands:
- npm run build
post_build:
commands:
- npm test
```
#### 配置 AWS Lambda
在 AWS Lambda 中配置 Xget:
```javascript
const { execSync } = require('child_process');
// 配置 npm 使用 Xget
execSync('npm config set registry https://xget.xi-xu.me/npm');
// 安装依赖
execSync('npm ci');
// 导出处理函数
exports.handler = async (event) => {
// 处理逻辑
return {
statusCode: 200,
body: JSON.stringify({ message: 'Hello from Lambda!' })
};
};
```
### Google Cloud
#### 配置 Google Cloud Build
在 Google Cloud Build 中配置 Xget:
```yaml
steps:
- name: 'node:20'
entrypoint: 'npm'
args: ['config', 'set', 'registry', 'https://xget.xi-xu.me/npm']
- name: 'node:20'
entrypoint: 'npm'
args: ['ci']
- name: 'node:20'
entrypoint: 'npm'
args: ['run', 'build']
- name: 'node:20'
entrypoint: 'npm'
args: ['test']
```
#### 配置 Google Cloud Functions
在 Google Cloud Functions 中配置 Xget:
```javascript
const { execSync } = require('child_process');
// 配置 npm 使用 Xget
execSync('npm config set registry https://xget.xi-xu.me/npm');
// 安装依赖
execSync('npm ci');
// 导出处理函数
exports.helloWorld = (req, res) => {
res.status(200).send({ message: 'Hello from Cloud Functions!' });
};
```
### Azure
#### 配置 Azure Functions
在 Azure Functions 中配置 Xget:
```javascript
const { execSync } = require('child_process');
// 配置 npm 使用 Xget
execSync('npm config set registry https://xget.xi-xu.me/npm');
// 安装依赖
execSync('npm ci');
// 导出处理函数
module.exports = async function (context, req) {
context.res = {
status: 200,
body: { message: 'Hello from Azure Functions!' }
};
};
```
## 监控和日志集成
### Prometheus
#### 配置 Prometheus 监控
在 Prometheus 中配置 Xget 监控:
```yaml
scrape_configs:
- job_name: 'xget'
static_configs:
- targets: ['xget.xi-xu.me:9090']
metrics_path: '/metrics'
scrape_interval: 15s
```
#### 使用示例
```bash
# 启动 Prometheus
prometheus --config.file=prometheus.yml
# 查询指标
curl http://localhost:9090/api/v1/query?query=xget_request_count
```
### Grafana
#### 配置 Grafana 仪表板
在 Grafana 中配置 Xget 仪表板:
```json
{
"dashboard": {
"title": "Xget Metrics",
"panels": [
{
"title": "Request Count",
"targets": [
{
"expr": "xget_request_count",
"refId": "A"
}
]
},
{
"title": "Response Time",
"targets": [
{
"expr": "xget_response_time",
"refId": "A"
}
]
}
]
}
}
```
### ELK Stack
#### 配置 Elasticsearch
在 Elasticsearch 中配置 Xget 日志:
```json
{
"index_patterns": ["xget-*"],
"settings": {
"number_of_shards": 1,
"number_of_replicas": 1
},
"mappings": {
"properties": {
"timestamp": {
"type": "date"
},
"level": {
"type": "keyword"
},
"message": {
"type": "text"
}
}
}
}
```
#### 配置 Logstash
在 Logstash 中配置 Xget 日志处理:
```conf
input {
http {
port => 5044
codec => json
}
}
filter {
if [type] == "xget" {
date {
match => ["timestamp", "ISO8601"]
}
}
}
output {
elasticsearch {
hosts => ["http://localhost:9200"]
index => "xget-%{+YYYY.MM.dd}"
}
}
```
## 最佳实践
### 配置管理
1. **集中配置**
- 使用配置文件集中管理 Xget 配置
- 在团队中共享配置
2. **环境变量**
- 使用环境变量动态配置 Xget
- 支持多环境配置
3. **版本控制**
- 将配置文件纳入版本控制
- 使用配置模板
### 性能优化
1. **缓存策略**
- 合理设置缓存时间
- 使用 CDN 加速
2. **并发控制**
- 控制并发请求数量
- 使用连接池
3. **监控优化**
- 监控性能指标
- 及时发现问题
### 安全实践
1. **访问控制**
- 使用 API 密钥
- 限制访问权限
2. **数据加密**
- 使用 HTTPS
- 加密敏感数据
3. **日志审计**
- 记录访问日志
- 定期审计
## 总结
Xget 通过与各种开发工具、平台和服务的深度集成,为开发者提供了统一的加速体验。从 IDE 到 CI/CD,从包管理器到容器平台,Xget 都能无缝融入开发者的日常工作流程。
通过合理的配置和优化,开发者可以显著提升开发效率,享受快速、稳定的资源访问体验。
---
# Xget Git 协议支持详解
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-git-protocol-support/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-git-protocol-support.md
- Published: 2025-12-27T16:00:00+08:00
- Updated: 2026-06-18T17:21:22+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, Git, 协议
深入解析Xget对Git HTTP/HTTPS、SSH、Git协议等多种传输协议的全面支持方案。本文介绍各协议的加速原理、URL转换规则、配置方法以及在防火墙环境和不同安全需求场景下的最佳实践,帮助开发者在受限网络环境中实现Git操作的全面加速和稳定运行
## 概述
本文档详细介绍了 Xget 对 Git 协议的全面支持,包括 HTTP/HTTPS、SSH、Git 协议等各种 Git 传输协议的加速方案。通过 Xget,开发者可以显著提升 Git 操作的速度和稳定性。
## Git 协议基础
### Git 传输协议
Git 支持多种传输协议:
1. **HTTP/HTTPS 协议**
- 最常用的协议
- 支持代理和缓存
- 适合防火墙环境
2. **SSH 协议**
- 加密传输
- 支持认证
- 适合安全要求高的场景
3. **Git 协议**
- 最快的协议
- 无加密
- 适合内网环境
4. **Git 协议 (SSH)**
- 结合了 Git 协议和 SSH
- 速度快且安全
### Git 操作类型
Git 操作主要分为以下类型:
1. **Clone**
- 克隆完整仓库
- 浅克隆(shallow clone)
- 单分支克隆
2. **Fetch**
- 获取远程更新
- 获取特定分支
- 获取特定标签
3. **Pull**
- 拉取并合并
- 拉取并变基
4. **Push**
- 推送提交
- 推送标签
- 强制推送
5. **其他操作**
- LFS 操作
- Submodule 操作
- Archive 操作
## HTTP/HTTPS 协议支持
### 基本原理
Xget 通过 HTTP/HTTPS 协议代理 Git 操作,实现以下功能:
1. **URL 转换**
- 将原始 Git URL 转换为 Xget 加速 URL
- 自动识别 Git 仓库地址
2. **请求代理**
- 代理 Git HTTP 请求
- 处理 Git 特定的请求头
3. **响应缓存**
- 缓存 Git 对象
- 减少重复请求
### URL 转换规则
```javascript
// GitHub URL 转换
function convertGitHubUrl(url) {
// 原始 URL: https://github.com/user/repo.git
// 加速 URL: https://xget.xi-xu.me/gh/user/repo.git
const pattern = /^https?:\/\/github\.com\/(.+?)\/(.+?)(\.git)?$/;
const match = url.match(pattern);
if (match) {
const [, user, repo] = match;
return `https://xget.xi-xu.me/gh/${user}/${repo}.git`;
}
return url;
}
// GitLab URL 转换
function convertGitLabUrl(url) {
// 原始 URL: https://gitlab.com/user/repo.git
// 加速 URL: https://xget.xi-xu.me/gl/user/repo.git
const pattern = /^https?:\/\/gitlab\.com\/(.+?)\/(.+?)(\.git)?$/;
const match = url.match(pattern);
if (match) {
const [, user, repo] = match;
return `https://xget.xi-xu.me/gl/${user}/${repo}.git`;
}
return url;
}
// 通用 URL 转换
function convertGitUrl(url) {
const converters = [
convertGitHubUrl,
convertGitLabUrl,
// 添加其他平台的转换函数
];
for (const converter of converters) {
const converted = converter(url);
if (converted !== url) {
return converted;
}
}
return url;
}
```
### Git HTTP 请求处理
```javascript
// Git HTTP 请求处理器
async function handleGitHttpRequest(request) {
const url = new URL(request.url);
const path = url.pathname;
// Git 智能协议请求
if (path.endsWith('/info/refs')) {
return await handleInfoRefs(request);
}
// Git 对象请求
if (path.includes('/objects/')) {
return await handleGitObject(request);
}
// Git 上传包请求
if (path.includes('/git-upload-pack')) {
return await handleUploadPack(request);
}
// Git 接收包请求
if (path.includes('/git-receive-pack')) {
return await handleReceivePack(request);
}
// 默认处理
return await fetch(request);
}
// 处理 info/refs 请求
async function handleInfoRefs(request) {
const url = new URL(request.url);
const service = url.searchParams.get('service');
// 构建目标 URL
const targetUrl = buildTargetUrl(url);
// 添加 Git 特定的请求头
const headers = new Headers(request.headers);
headers.set('Git-Protocol', 'version=2');
// 发送请求
const response = await fetch(targetUrl, {
method: request.method,
headers: headers
});
return response;
}
// 处理 Git 对象请求
async function handleGitObject(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 检查缓存
const cacheKey = `git-object:${url.pathname}`;
const cached = await CACHE.get(cacheKey);
if (cached) {
return new Response(cached, {
headers: {
'X-Cache': 'HIT',
'Content-Type': 'application/x-git-loose-object'
}
});
}
// 发送请求
const response = await fetch(targetUrl, {
method: request.method,
headers: request.headers
});
// 缓存响应
if (response.ok) {
const clonedResponse = response.clone();
const buffer = await clonedResponse.arrayBuffer();
await CACHE.put(cacheKey, buffer, {
expirationTtl: 86400 // 缓存 24 小时
});
}
return response;
}
// 处理 git-upload-pack 请求
async function handleUploadPack(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 处理 POST 请求体
const body = await request.arrayBuffer();
// 发送请求
const response = await fetch(targetUrl, {
method: 'POST',
headers: {
'Content-Type': 'application/x-git-upload-pack-request',
'Accept': 'application/x-git-upload-pack-result'
},
body: body
});
return response;
}
// 处理 git-receive-pack 请求
async function handleReceivePack(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 处理 POST 请求体
const body = await request.arrayBuffer();
// 发送请求
const response = await fetch(targetUrl, {
method: 'POST',
headers: {
'Content-Type': 'application/x-git-receive-pack-request',
'Accept': 'application/x-git-receive-pack-result'
},
body: body
});
// 失效相关缓存
await invalidateGitCache(url.pathname);
return response;
}
// 构建目标 URL
function buildTargetUrl(url) {
// 移除 Xget 前缀
const path = url.pathname.replace(/^\/(gh|gl|gitea)\//, '');
// 构建目标 URL
const platform = url.pathname.split('/')[1];
const baseUrl = getPlatformBaseUrl(platform);
return `${baseUrl}/${path}`;
}
// 获取平台基础 URL
function getPlatformBaseUrl(platform) {
const platforms = {
'gh': 'https://github.com',
'gl': 'https://gitlab.com',
'gitea': 'https://gitea.com'
};
return platforms[platform] || 'https://github.com';
}
```
### Git LFS 支持
```javascript
// Git LFS 请求处理
async function handleGitLfsRequest(request) {
const url = new URL(request.url);
const path = url.pathname;
// LFS 对象下载
if (path.includes('/objects/')) {
return await handleLFSObject(request);
}
// LFS 批量操作
if (path.includes('/objects/batch')) {
return await handleLFSBatch(request);
}
return await fetch(request);
}
// 处理 LFS 对象请求
async function handleLFSObject(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 检查缓存
const cacheKey = `lfs-object:${url.pathname}`;
const cached = await CACHE.get(cacheKey);
if (cached) {
return new Response(cached, {
headers: {
'X-Cache': 'HIT',
'Content-Type': 'application/vnd.git-lfs'
}
});
}
// 发送请求
const response = await fetch(targetUrl, {
method: request.method,
headers: request.headers
});
// 缓存响应
if (response.ok) {
const clonedResponse = response.clone();
const buffer = await clonedResponse.arrayBuffer();
await CACHE.put(cacheKey, buffer, {
expirationTtl: 604800 // 缓存 7 天
});
}
return response;
}
// 处理 LFS 批量操作
async function handleLFSBatch(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 处理 POST 请求体
const body = await request.json();
// 发送请求
const response = await fetch(targetUrl, {
method: 'POST',
headers: {
'Content-Type': 'application/vnd.git-lfs+json',
'Accept': 'application/vnd.git-lfs+json'
},
body: JSON.stringify(body)
});
return response;
}
```
## SSH 协议支持
### SSH 代理原理
Xget 通过 SSH 代理实现 Git SSH 协议的加速:
1. **SSH 连接代理**
- 代理 SSH 连接
- 处理 SSH 认证
2. **数据传输优化**
- 压缩传输数据
- 缓存传输内容
3. **连接复用**
- 复用 SSH 连接
- 减少连接开销
### SSH URL 转换
```javascript
// SSH URL 转换
function convertSSHUrl(url) {
// 原始 URL: git@github.com:user/repo.git
// 加速 URL: ssh://git@xget.xi-xu.me:22/gh/user/repo.git
const sshPattern = /^git@([^:]+):(.+)$/;
const match = url.match(sshPattern);
if (match) {
const [, host, repoPath] = match;
const platform = getPlatformFromHost(host);
return `ssh://git@xget.xi-xu.me:22/${platform}/${repoPath}`;
}
return url;
}
// 从主机名获取平台
function getPlatformFromHost(host) {
const platforms = {
'github.com': 'gh',
'gitlab.com': 'gl',
'gitea.com': 'gitea'
};
return platforms[host] || 'gh';
}
```
### SSH 配置
在 `~/.ssh/config` 中配置 Xget SSH 代理:
```
# GitHub
Host github.com
HostName xget.xi-xu.me
Port 22
User git
IdentityFile ~/.ssh/id_rsa
ProxyCommand ssh -W %h:%p git@xget.xi-xu.me
# GitLab
Host gitlab.com
HostName xget.xi-xu.me
Port 22
User git
IdentityFile ~/.ssh/id_rsa
ProxyCommand ssh -W %h:%p git@xget.xi-xu.me
```
### SSH 密钥管理
```javascript
// SSH 密钥验证
async function verifySSHKey(publicKey) {
// 验证 SSH 密钥格式
const keyPattern = /^(ssh-rsa|ssh-ed25519|ecdsa-sha2-nistp256|ecdsa-sha2-nistp384|ecdsa-sha2-nistp521) /;
if (!keyPattern.test(publicKey)) {
throw new Error('Invalid SSH key format');
}
// 验证密钥长度
const keyParts = publicKey.split(' ');
if (keyParts.length < 2) {
throw new Error('Invalid SSH key format');
}
return true;
}
// SSH 密钥存储
async function storeSSHKey(userId, publicKey) {
const key = `ssh-key:${userId}`;
await KV.put(key, publicKey, {
expirationTtl: 2592000 // 30 天
});
}
// SSH 密钥获取
async function getSSHKey(userId) {
const key = `ssh-key:${userId}`;
return await KV.get(key);
}
```
## Git 协议支持
### Git 协议原理
Git 协议是 Git 专用的传输协议,特点:
1. **高效传输**
- 二进制协议
- 最小化数据传输
2. **无加密**
- 速度快
- 不适合公网
3. **简单实现**
- 协议简单
- 易于实现
### Git 协议 URL 转换
```javascript
// Git 协议 URL 转换
function convertGitProtocolUrl(url) {
// 原始 URL: git://github.com/user/repo.git
// 加速 URL: git://xget.xi-xu.me/gh/user/repo.git
const gitPattern = /^git:\/\/([^\/]+)\/(.+)$/;
const match = url.match(gitPattern);
if (match) {
const [, host, repoPath] = match;
const platform = getPlatformFromHost(host);
return `git://xget.xi-xu.me/${platform}/${repoPath}`;
}
return url;
}
```
### Git 协议处理
```javascript
// Git 协议请求处理
async function handleGitProtocolRequest(request) {
const url = new URL(request.url);
const path = url.pathname;
// Git 协议请求
if (url.protocol === 'git:') {
return await handleGitProtocol(request);
}
return await fetch(request);
}
// 处理 Git 协议
async function handleGitProtocol(request) {
const url = new URL(request.url);
const targetUrl = buildTargetUrl(url);
// 创建 Git 协议连接
const connection = await createGitConnection(targetUrl);
// 处理 Git 协议握手
await handleGitHandshake(connection);
// 处理 Git 协议数据传输
return await handleGitDataTransfer(connection, request);
}
// 创建 Git 协议连接
async function createGitConnection(url) {
// 实现 Git 协议连接
const connection = {
url: url,
socket: null,
state: 'connected'
};
return connection;
}
// 处理 Git 协议握手
async function handleGitHandshake(connection) {
// 实现 Git 协议握手
const handshake = `git-upload-pack ${connection.url.pathname}\0host=${connection.url.hostname}\0`;
connection.socket.send(handshake);
const response = await connection.socket.receive();
return response;
}
// 处理 Git 协议数据传输
async function handleGitDataTransfer(connection, request) {
// 实现 Git 协议数据传输
const data = await request.arrayBuffer();
connection.socket.send(data);
const response = await connection.socket.receive();
return new Response(response, {
headers: {
'Content-Type': 'application/x-git-upload-pack-result'
}
});
}
```
## Git 操作优化
### Clone 操作优化
```javascript
// Clone 操作优化
async function optimizeClone(url, options = {}) {
const { depth = 0, singleBranch = false, branch = null } = options;
// 构建优化后的 URL
let optimizedUrl = convertGitUrl(url);
// 添加查询参数
const searchParams = new URLSearchParams();
if (depth > 0) {
searchParams.set('depth', depth.toString());
}
if (singleBranch) {
searchParams.set('single-branch', 'true');
}
if (branch) {
searchParams.set('branch', branch);
}
if (searchParams.toString()) {
optimizedUrl += `?${searchParams.toString()}`;
}
return optimizedUrl;
}
// 使用示例
const optimizedUrl = await optimizeClone('https://github.com/user/repo.git', {
depth: 1,
singleBranch: true,
branch: 'main'
});
```
### Fetch 操作优化
```javascript
// Fetch 操作优化
async function optimizeFetch(url, options = {}) {
const { depth = 0, prune = false, tags = true } = options;
// 构建优化后的 URL
let optimizedUrl = convertGitUrl(url);
// 添加查询参数
const searchParams = new URLSearchParams();
if (depth > 0) {
searchParams.set('depth', depth.toString());
}
if (prune) {
searchParams.set('prune', 'true');
}
if (!tags) {
searchParams.set('no-tags', 'true');
}
if (searchParams.toString()) {
optimizedUrl += `?${searchParams.toString()}`;
}
return optimizedUrl;
}
// 使用示例
const optimizedUrl = await optimizeFetch('https://github.com/user/repo.git', {
depth: 1,
prune: true,
tags: false
});
```
### Push 操作优化
```javascript
// Push 操作优化
async function optimizePush(url, options = {}) {
const { force = false, forceWithLease = false, tags = false } = options;
// 构建优化后的 URL
let optimizedUrl = convertGitUrl(url);
// 添加查询参数
const searchParams = new URLSearchParams();
if (force) {
searchParams.set('force', 'true');
}
if (forceWithLease) {
searchParams.set('force-with-lease', 'true');
}
if (tags) {
searchParams.set('tags', 'true');
}
if (searchParams.toString()) {
optimizedUrl += `?${searchParams.toString()}`;
}
return optimizedUrl;
}
// 使用示例
const optimizedUrl = await optimizePush('https://github.com/user/repo.git', {
force: false,
tags: true
});
```
## Git 配置优化
### 全局配置
```bash
# 配置 Git 使用 Xget
git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
git config --global url."https://xget.xi-xu.me/gl/".insteadOf "https://gitlab.com/"
git config --global url."https://xget.xi-xu.me/gitea/".insteadOf "https://gitea.com/"
# 配置 Git 协议
git config --global http.proxy http://xget.xi-xu.me:8080
git config --global https.proxy https://xget.xi-xu.me:8443
# 配置缓存
git config --global http.cache 3600
git config --global https.cache 3600
# 配置压缩
git config --global core.compression 9
git config --global http.compression 9
git config --global https.com 9
```
### 仓库配置
```bash
# 进入仓库目录
cd your-repo
# 配置仓库使用 Xget
git config url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
# 配置 LFS
git config lfs.url https://xget.xi-xu.me/gh/user/repo.git/info/lfs
git config lfs.basictransfersonly true
git config lfs.concurrenttransfers 8
```
### 性能配置
```bash
# 配置并发
git config --global http.postBuffer 524288000
git config --global http.lowSpeedLimit 0
git config --global http.lowSpeedTime 999999
# 配置超时
git config --global http.timeout 600
git config --global http.connectTimeout 30
git config --global http.readTimeout 600
# 配置重试
git config --global http.maxRetries 3
git config --global http.retryDelay 1000
```
## 常见问题
### Q1: 如何验证 Git 加速是否生效?
A: 使用 `time` 命令测量操作时间:
```bash
# 测试 clone 速度
time git clone https://xget.xi-xu.me/gh/user/repo.git
# 测试 fetch 速度
time git fetch origin
```
### Q2: Git LFS 如何使用 Xget 加速?
A: 配置 LFS 使用 Xget:
```bash
git config lfs.url https://xget.xi-xu.me/gh/user/repo.git/info/lfs
git lfs fetch
```
### Q3: 如何处理 Git 认证问题?
A: 使用 Git 凭据存储:
```bash
# 配置凭据存储
git config --global credential.helper store
# 输入凭据
git push
```
### Q4: Xget 支持哪些 Git 操作?
A: Xget 支持所有 Git 操作,包括 clone、fetch、pull、push、LFS 等。
### Q5: 如何切换回原始 Git URL?
A: 移除 Git 配置:
```bash
git config --global --unset url."https://xget.xi-xu.me/gh/".insteadOf
```
## 总结
Xget 提供了全面的 Git 协议支持,包括 HTTP/HTTPS、SSH、Git 协议等各种传输协议。通过 URL 转换、请求代理、响应缓存等技术,Xget 显著提升了 Git 操作的速度和稳定性。
同时,Xget 对 Git LFS、Submodule 等高级功能也提供了完善的支持,确保开发者能够享受到完整的 Git 加速体验。
---
# Xget 安全机制与性能优化
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-security-and-performance/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-security-and-performance.md
- Published: 2025-12-27T15:30:00+08:00
- Updated: 2026-06-18T17:21:22+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 安全, 性能优化
全面介绍Xget的多层安全防护机制和性能优化策略,包括User-Agent验证机制、请求签名认证、智能缓存策略、边缘节点调度等核心技术的实现原理。本文解析Xget如何在保证服务安全稳定的同时实现高性能的开发者资源加速,为大规模生产环境提供可靠保障
## 概述
本文档详细介绍了 Xget 的安全机制和性能优化策略。通过多层安全防护和全面的性能优化,Xget 确保了服务的安全性、稳定性和高性能。
## 安全机制
### 请求验证
#### User-Agent 验证
Xget 对 User-Agent 进行严格验证,确保请求来自合法的客户端。
```javascript
// User-Agent 白名单验证
const USER_AGENT_WHITELIST = [
'git/',
'curl/',
'wget/',
'aria2/',
'npm/',
'pip/',
'docker/',
'Mozilla/5.0',
'Go-http-client/',
'Java/',
'Python-urllib/'
];
function validateUserAgent(userAgent) {
if (!userAgent) {
return false;
}
return USER_AGENT_WHITELIST.some(pattern =>
userAgent.includes(pattern)
);
}
```
**配置示例**
```javascript
// 在环境变量中配置自定义 User-Agent 白名单
const CUSTOM_USER_AGENTS = process.env.CUSTOM_USER_AGENTS
? process.env.CUSTOM_USER_AGENTS.split(',')
: [];
```
#### Referer 验证
验证请求来源,防止 CSRF 攻击。
```javascript
// Referer 白名单验证
const REFERER_WHITELIST = [
'https://github.com',
'https://gitlab.com',
'https://gitee.com',
'https://pypi.org',
'https://registry.npmjs.org'
];
function validateReferer(referer) {
if (!referer) {
return true; // 允许无 Referer 的请求
}
try {
const refererUrl = new URL(referer);
return REFERER_WHITELIST.some(allowed =>
refererUrl.origin === allowed
);
} catch (error) {
return false;
}
}
```
#### IP 限流
基于 IP 的请求限流,防止滥用。
```javascript
// IP 限流配置
const RATE_LIMIT_CONFIG = {
windowMs: 60 * 1000, // 1 分钟
maxRequests: 100, // 每分钟最多 100 次请求
skipSuccessfulRequests: true // 跳过成功的请求
};
// 使用 Cloudflare Workers KV 实现限流
async function checkRateLimit(ip) {
const key = `ratelimit:${ip}`;
const now = Date.now();
const data = await KV.get(key, { type: 'json' }) || { count: 0, resetAt: now + RATE_LIMIT_CONFIG.windowMs };
if (data.resetAt < now) {
data.count = 0;
data.resetAt = now + RATE_LIMIT_CONFIG.windowMs;
}
if (data.count >= RATE_LIMIT_CONFIG.maxRequests) {
return { allowed: false, resetAt: data.resetAt };
}
data.count++;
await KV.put(key, JSON.stringify(data), { expirationTtl: RATE_LIMIT_CONFIG.windowMs / 1000 });
return { allowed: true, remaining: RATE_LIMIT_CONFIG.maxRequests - data.count };
}
```
### 请求头部处理
#### 安全头部设置
设置安全相关的 HTTP 响应头部。
```javascript
// 设置安全头部
function setSecurityHeaders(response) {
// 防止点击劫持
response.headers.set('X-Frame-Options', 'DENY');
// 防止 MIME 类型嗅探
response.headers.set('X-Content-Type-Options', 'nosniff');
// 启用 XSS 保护
response.headers.set('X-XSS-Protection', '1; mode=block');
// 严格传输安全
response.headers.set('Strict-Transport-Security', 'max-age=31536000; includeSubDomains');
// 内容安全策略
response.headers.set('Content-Security-Policy', "default-src 'self'");
// 引用策略
response.headers.set('Referrer-Policy', 'strict-origin-when-cross-origin');
return response;
}
```
#### 头部过滤
过滤敏感的请求头部,防止信息泄露。
```javascript
// 需要过滤的敏感头部
const SENSITIVE_HEADERS = [
'authorization',
'cookie',
'set-cookie',
'x-api-key',
'x-auth-token',
'proxy-authorization'
];
// 过滤头部
function filterHeaders(headers) {
const filtered = new Headers();
for (const [key, value] of headers.entries()) {
const lowerKey = key.toLowerCase();
if (!SENSITIVE_HEADERS.includes(lowerKey)) {
filtered.set(key, value);
}
}
return filtered;
}
```
#### 头部重写
重写请求头部以匹配目标服务器的要求。
```javascript
// 头部重写规则
const HEADER_REWRITE_RULES = {
'host': (url) => new URL(url).hostname,
'origin': (url) => new URL(url).origin,
'referer': (url) => new URL(url).origin
};
// 重写头部
function rewriteHeaders(headers, targetUrl) {
const rewritten = new Headers(headers);
for (const [header, rewriter] of Object.entries(HEADER_REWRITE_RULES)) {
if (rewritten.has(header)) {
rewritten.set(header, rewriter(targetUrl));
}
}
return rewritten;
}
```
### 超时保护
#### 请求超时
设置合理的请求超时时间,防止长时间挂起的请求。
```javascript
// 超时配置
const TIMEOUT_CONFIG = {
connect: 10000, // 连接超时:10 秒
read: 30000, // 读取超时:30 秒
write: 30000, // 写入超时:30 秒
total: 60000 // 总超时:60 秒
};
// 带超时的请求
async function fetchWithTimeout(url, options = {}) {
const controller = new AbortController();
const timeoutId = setTimeout(() => controller.abort(), TIMEOUT_CONFIG.total);
try {
const response = await fetch(url, {
...options,
signal: controller.signal
});
clearTimeout(timeoutId);
return response;
} catch (error) {
clearTimeout(timeoutId);
if (error.name === 'AbortError') {
throw new Error('Request timeout');
}
throw error;
}
}
```
#### 连接超时
控制连接建立的超时时间。
```javascript
// 连接超时控制
async function connectWithTimeout(url, timeout = TIMEOUT_CONFIG.connect) {
const controller = new AbortController();
const timeoutId = setTimeout(() => controller.abort(), timeout);
try {
const response = await fetch(url, {
method: 'HEAD',
signal: controller.signal
});
clearTimeout(timeoutId);
return response;
} catch (error) {
clearTimeout(timeoutId);
if (error.name === 'AbortError') {
throw new Error('Connection timeout');
}
throw error;
}
}
```
### 错误处理
#### 错误分类
对不同类型的错误进行分类处理。
```javascript
// 错误类型
const ERROR_TYPES = {
NETWORK_ERROR: 'NETWORK_ERROR',
TIMEOUT_ERROR: 'TIMEOUT_ERROR',
RATE_LIMIT_ERROR: 'RATE_LIMIT_ERROR',
VALIDATION_ERROR: 'VALIDATION_ERROR',
SERVER_ERROR: 'SERVER_ERROR',
CLIENT_ERROR: 'CLIENT_ERROR'
};
// 错误处理函数
function handleError(error) {
if (error.name === 'AbortError') {
return {
type: ERROR_TYPES.TIMEOUT_ERROR,
message: 'Request timeout',
status: 504
};
}
if (error.message.includes('fetch failed')) {
return {
type: ERROR_TYPES.NETWORK_ERROR,
message: 'Network error',
status: 502
};
}
if (error.status >= 500) {
return {
type: ERROR_TYPES.SERVER_ERROR,
message: 'Server error',
status: error.status
};
}
if (error.status >= 400) {
return {
type: ERROR_TYPES.CLIENT_ERROR,
message: 'Client error',
status: error.status
};
}
return {
type: ERROR_TYPES.SERVER_ERROR,
message: 'Unknown error',
status: 500
};
}
```
#### 错误响应
返回友好的错误响应。
```javascript
// 错误响应
function errorResponse(error) {
const errorInfo = handleError(error);
return new Response(JSON.stringify({
error: errorInfo.message,
type: errorInfo.type,
timestamp: new Date().toISOString()
}), {
status: errorInfo.status,
headers: {
'Content-Type': 'application/json'
}
});
}
```
#### 重试机制
对可重试的错误实现自动重试。
```javascript
// 重试配置
const RETRY_CONFIG = {
maxRetries: 3,
retryDelay: 1000,
retryableStatuses: [408, 429, 500, 502, 503, 504],
retryableErrors: ['NETWORK_ERROR', 'TIMEOUT_ERROR']
};
// 带重试的请求
async function fetchWithRetry(url, options = {}, retries = RETRY_CONFIG.maxRetries) {
try {
return await fetchWithTimeout(url, options);
} catch (error) {
const errorInfo = handleError(error);
if (retries <= 0 ||
!RETRY_CONFIG.retryableErrors.includes(errorInfo.type)) {
throw error;
}
// 指数退避
const delay = RETRY_CONFIG.retryDelay * Math.pow(2, RETRY_CONFIG.maxRetries - retries);
await new Promise(resolve => setTimeout(resolve, delay));
return fetchWithRetry(url, options, retries - 1);
}
}
```
## 性能优化
### 缓存策略
#### 边缘缓存
使用 Cloudflare Cache API 实现边缘缓存。
```javascript
// 缓存配置
const CACHE_CONFIG = {
defaultTTL: 1800, // 默认缓存时间:30 分钟
maxTTL: 86400, // 最大缓存时间:24 小时
staleWhileRevalidate: 60 // 过期后重新验证:1 分钟
};
// 缓存键生成
function generateCacheKey(url) {
const urlObj = new URL(url);
return `cache:${urlObj.hostname}:${urlObj.pathname}`;
}
// 获取缓存
async function getFromCache(key) {
try {
const cached = await CACHE.get(key, { type: 'arrayBuffer' });
if (cached) {
return new Response(cached, {
headers: {
'X-Cache': 'HIT',
'X-Cache-Key': key
}
});
}
} catch (error) {
console.error('Cache get error:', error);
}
return null;
}
// 设置缓存
async function setCache(key, response) {
try {
const clonedResponse = response.clone();
const buffer = await clonedResponse.arrayBuffer();
// 根据 Content-Type 设置缓存时间
const contentType = response.headers.get('Content-Type') || '';
let ttl = CACHE_CONFIG.defaultTTL;
if (contentType.includes('image/') || contentType.includes('video/')) {
ttl = CACHE_CONFIG.maxTTL;
} else if (contentType.includes('text/html') || contentType.includes('application/json')) {
ttl = CACHE_CONFIG.defaultTTL / 2;
}
await CACHE.put(key, buffer, {
expirationTtl: ttl
});
} catch (error) {
console.error('Cache set error:', error);
}
}
```
#### 缓存控制
根据不同的资源类型设置不同的缓存策略。
```javascript
// 缓存策略
const CACHE_STRATEGIES = {
// 静态资源:长时间缓存
static: {
maxAge: 86400,
staleWhileRevalidate: 3600
},
// API 响应:短时间缓存
api: {
maxAge: 300,
staleWhileRevalidate: 60
},
// 动态内容:不缓存
dynamic: {
noCache: true
}
};
// 应用缓存策略
function applyCacheStrategy(response, strategy) {
const config = CACHE_STRATEGIES[strategy] || CACHE_STRATEGIES.api;
if (config.noCache) {
response.headers.set('Cache-Control', 'no-store, no-cache, must-revalidate');
} else {
response.headers.set('Cache-Control',
`public, max-age=${config.maxAge}, stale-while-revalidate=${config.staleWhileRevalidate}`);
}
return response;
}
```
#### 缓存失效
实现缓存失效机制。
```javascript
// 缓存失效
async function invalidateCache(pattern) {
try {
// 列出所有缓存键
const keys = await CACHE.list();
// 过滤匹配的键
const keysToDelete = keys.keys.filter(key =>
key.name.includes(pattern)
);
// 删除匹配的缓存
await Promise.all(
keysToDelete.map(key => CACHE.delete(key.name))
);
return { deleted: keysToDelete.length };
} catch (error) {
console.error('Cache invalidate error:', error);
return { deleted: 0 };
}
}
// 使用示例
// invalidateCache('github.com'); // 失效所有 GitHub 相关的缓存
```
### 压缩优化
#### 响应压缩
对响应内容进行压缩,减少传输数据量。
```javascript
// 压缩配置
const COMPRESSION_CONFIG = {
enabled: true,
minSize: 1024, // 最小压缩大小:1KB
level: 6, // 压缩级别:0-9
types: [
'text/plain',
'text/html',
'text/css',
'text/javascript',
'application/json',
'application/javascript',
'application/xml',
'text/xml'
]
};
// 压缩响应
async function compressResponse(response) {
if (!COMPRESSION_CONFIG.enabled) {
return response;
}
const contentType = response.headers.get('Content-Type') || '';
const contentLength = parseInt(response.headers.get('Content-Length') || '0');
// 检查是否应该压缩
if (contentLength < COMPRESSION_CONFIG.minSize) {
return response;
}
const shouldCompress = COMPRESSION_CONFIG.types.some(type =>
contentType.includes(type)
);
if (!shouldCompress) {
return response;
}
// 检查客户端是否支持压缩
const acceptEncoding = response.headers.get('Accept-Encoding') || '';
if (acceptEncoding.includes('br')) {
return compressWithBrotli(response);
} else if (acceptEncoding.includes('gzip')) {
return compressWithGzip(response);
}
return response;
}
// Brotli 压缩
async function compressWithBrotli(response) {
const original = await response.arrayBuffer();
const compressed = await compress(original, { level: COMPRESSION_CONFIG.level });
return new Response(compressed, {
status: response.status,
headers: {
...response.headers,
'Content-Encoding': 'br',
'Content-Length': compressed.length.toString()
}
});
}
// Gzip 压缩
async function compressWithGzip(response) {
const original = await response.arrayBuffer();
const compressed = await gzip(original, { level: COMPRESSION_CONFIG.level });
return new Response(compressed, {
status: response.status,
headers: {
...response.headers,
'Content-Encoding': 'gzip',
'Content-Length': compressed.length.toString()
}
});
}
```
#### 请求压缩
对请求内容进行压缩。
```javascript
// 压缩请求
async function compressRequest(body, encoding) {
if (!body) {
return body;
}
if (encoding === 'br') {
return await compress(body, { level: COMPRESSION_CONFIG.level });
} else if (encoding === 'gzip') {
return await gzip(body, { level: COMPRESSION_CONFIG.level });
}
return body;
}
```
### 连接管理
#### 连接池
使用连接池复用连接。
```javascript
// 连接池配置
const CONNECTION_POOL_CONFIG = {
maxConnections: 100, // 最大连接数
maxIdleConnections: 10, // 最大空闲连接数
idleTimeout: 60000 // 空闲超时:60 秒
};
// 连接池实现
class ConnectionPool {
constructor(config) {
this.config = config;
this.connections = new Map();
this.idleConnections = new Map();
}
async getConnection(url) {
const key = `${new URL(url).origin}`;
// 检查空闲连接
if (this.idleConnections.has(key)) {
const connection = this.idleConnections.get(key);
this.idleConnections.delete(key);
return connection;
}
// 创建新连接
const connection = await this.createConnection(url);
this.connections.set(key, connection);
return connection;
}
async createConnection(url) {
// 实现连接创建逻辑
return fetch(url);
}
releaseConnection(url, connection) {
const key = `${new URL(url).origin}`;
// 检查空闲连接数量
if (this.idleConnections.size >= this.config.maxIdleConnections) {
this.connections.delete(key);
return;
}
// 放入空闲连接池
this.idleConnections.set(key, connection);
// 设置超时清理
setTimeout(() => {
this.idleConnections.delete(key);
this.connections.delete(key);
}, this.config.idleTimeout);
}
}
```
#### 连接复用
复用 HTTP/2 连接。
```javascript
// HTTP/2 连接复用
const HTTP2_POOL = new Map();
async function fetchWithConnectionReuse(url, options = {}) {
const origin = new URL(url).origin;
// 获取或创建连接
if (!HTTP2_POOL.has(origin)) {
HTTP2_POOL.set(origin, new ConnectionPool(CONNECTION_POOL_CONFIG));
}
const pool = HTTP2_POOL.get(origin);
const connection = await pool.getConnection(url);
try {
return await connection.fetch(url, options);
} finally {
pool.releaseConnection(url, connection);
}
}
```
### 内容优化
#### 内容转换
根据客户端能力转换内容格式。
```javascript
// 内容转换
async function transformContent(response, request) {
const acceptHeader = request.headers.get('Accept') || '';
const contentType = response.headers.get('Content-Type') || '';
// JSON 到 XML 转换
if (acceptHeader.includes('application/xml') && contentType.includes('application/json')) {
return await jsonToXml(response);
}
// JSON 到 YAML 转换
if (acceptHeader.includes('application/x-yaml') && contentType.includes('application/json')) {
return await jsonToYaml(response);
}
return response;
}
// JSON 到 XML 转换
async function jsonToXml(response) {
const json = await response.json();
const xml = convertJsonToXml(json);
return new Response(xml, {
status: response.status,
headers: {
'Content-Type': 'application/xml'
}
});
}
// JSON 到 YAML 转换
async function jsonToYaml(response) {
const json = await response.json();
const yaml = convertJsonToYaml(json);
return new Response(yaml, {
status: response.status,
headers: {
'Content-Type': 'application/x-yaml'
}
});
}
```
#### 内容适配
根据设备类型适配内容。
```javascript
// 内容适配
async function adaptContent(response, request) {
const userAgent = request.headers.get('User-Agent') || '';
// 移动设备适配
if (isMobileDevice(userAgent)) {
return await adaptForMobile(response);
}
// 桌面设备适配
if (isDesktopDevice(userAgent)) {
return await adaptForDesktop(response);
}
return response;
}
// 移动设备适配
async function adaptForMobile(response) {
const contentType = response.headers.get('Content-Type') || '';
if (contentType.includes('text/html')) {
const html = await response.text();
const adapted = optimizeForMobile(html);
return new Response(adapted, {
status: response.status,
headers: response.headers
});
}
return response;
}
// 桌面设备适配
async function adaptForDesktop(response) {
const contentType = response.headers.get('Content-Type') || '';
if (contentType.includes('text/html')) {
const html = await response.text();
const adapted = optimizeForDesktop(html);
return new Response(adapted, {
status: response.status,
headers: response.headers
});
}
return response;
}
```
## 监控和日志
### 请求监控
#### 性能指标
收集和记录性能指标。
```javascript
// 性能指标收集
const performanceMetrics = {
requestCount: 0,
successCount: 0,
errorCount: 0,
totalLatency: 0,
cacheHitCount: 0,
cacheMissCount: 0
};
// 记录请求指标
function recordRequestMetrics(startTime, cacheHit, success) {
const latency = Date.now() - startTime;
performanceMetrics.requestCount++;
performanceMetrics.totalLatency += latency;
if (cacheHit) {
performanceMetrics.cacheHitCount++;
} else {
performanceMetrics.cacheMissCount++;
}
if (success) {
performanceMetrics.successCount++;
} else {
performanceMetrics.errorCount++;
}
}
// 获取性能指标
function getPerformanceMetrics() {
const avgLatency = performanceMetrics.totalLatency / performanceMetrics.requestCount;
const cacheHitRate = performanceMetrics.cacheHitCount /
(performanceMetrics.cacheHitCount + performanceMetrics.cacheMissCount);
const errorRate = performanceMetrics.errorCount / performanceMetrics.requestCount;
return {
requestCount: performanceMetrics.requestCount,
successCount: performanceMetrics.successCount,
errorCount: performanceMetrics.errorCount,
avgLatency: avgLatency,
cacheHitRate: cacheHitRate,
errorRate: errorRate
};
}
```
#### 实时监控
实现实时监控功能。
```javascript
// 实时监控
async function monitorRequest(request, response) {
const startTime = Date.now();
// 记录请求信息
const requestInfo = {
method: request.method,
url: request.url,
headers: Object.fromEntries(request.headers.entries()),
timestamp: new Date().toISOString()
};
// 记录响应信息
const responseInfo = {
status: response.status,
headers: Object.fromEntries(response.headers.entries()),
latency: Date.now() - startTime,
timestamp: new Date().toISOString()
};
// 发送到监控系统
await sendToMonitoringSystem({
request: requestInfo,
response: responseInfo
});
}
// 发送到监控系统
async function sendToMonitoringSystem(data) {
// 实现发送逻辑,例如发送到 Cloudflare Analytics 或自定义监控服务
console.log('Monitoring data:', JSON.stringify(data));
}
```
### 日志记录
#### 结构化日志
使用结构化日志格式。
```javascript
// 日志级别
const LOG_LEVELS = {
DEBUG: 'DEBUG',
INFO: 'INFO',
WARN: 'WARN',
ERROR: 'ERROR'
};
// 结构化日志
function log(level, message, context = {}) {
const logEntry = {
timestamp: new Date().toISOString(),
level: level,
message: message,
context: context
};
console.log(JSON.stringify(logEntry));
}
// 使用示例
log(LOG_LEVELS.INFO, 'Request received', {
method: 'GET',
url: 'https://example.com',
ip: '192.168.1.1'
});
```
#### 错误日志
记录详细的错误信息。
```javascript
// 错误日志
function logError(error, context = {}) {
log(LOG_LEVELS.ERROR, error.message, {
stack: error.stack,
...context
});
}
// 使用示例
try {
await fetch(url);
} catch (error) {
logError(error, {
url: url,
method: 'GET'
});
}
```
## 最佳实践
### 安全最佳实践
1. **最小权限原则**
- 只授予必要的权限
- 使用最小权限的 API 密钥
2. **定期更新**
- 定期更新依赖项
- 及时应用安全补丁
3. **输入验证**
- 验证所有输入数据
- 防止注入攻击
4. **加密传输**
- 使用 HTTPS 加密传输
- 验证 SSL 证书
### 性能最佳实践
1. **缓存优先**
- 优先使用缓存
- 合理设置缓存时间
2. **压缩内容**
- 压缩大文件
- 选择合适的压缩算法
3. **连接复用**
- 复用 HTTP/2 连接
- 使用连接池
4. **异步处理**
- 使用异步操作
- 避免阻塞请求
### 监控最佳实践
1. **关键指标**
- 监控关键性能指标
- 设置合理的告警阈值
2. **日志分析**
- 定期分析日志
- 识别性能瓶颈
3. **持续优化**
- 持续优化性能
- 定期审查代码
## 总结
Xget 通过多层安全机制和全面的性能优化策略,确保了服务的安全性、稳定性和高性能。通过合理的安全防护、缓存策略、压缩优化和连接管理,Xget 能够为用户提供快速、可靠的加速服务。
同时,完善的监控和日志系统帮助及时发现和解决问题,确保服务的持续稳定运行。
---
# Xget 部署指南
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-deployment-guide/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-deployment-guide.md
- Published: 2025-12-27T15:00:00+08:00
- Updated: 2026-06-18T17:17:25+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 部署, Cloudflare
全面介绍Xget在Cloudflare Workers、EdgeOne Pages、Vercel、Netlify、Deno Deploy、Docker和Podman等多种平台的部署方案。本文涵盖各平台的前置要求、配置步骤、环境变量设置以及常见问题排查指南
## 概述
Xget 支持多种部署方式,包括 Cloudflare Workers、EdgeOne Pages、Vercel、Netlify、Deno Deploy、Docker 和 Podman。本文档详细介绍了各种部署方式的步骤和配置。
## 前置要求
### 通用要求
- Node.js 18+ 或兼容的 JavaScript 运行环境
- Git 客户端
- 基本的命令行操作能力
### 特定平台要求
**Cloudflare Workers**
- Cloudflare 账户(免费计划即可)
- Wrangler CLI 工具
**EdgeOne Pages**
- 腾讯云账户
- EdgeOne 服务
**Vercel**
- Vercel 账户
- Vercel CLI 工具
**Netlify**
- Netlify 账户
- Netlify CLI 工具
**Deno Deploy**
- Deno 账户
- Deno CLI 工具
**Docker/Podman**
- Docker 或 Podman 运行时
- 服务器或本地机器
## 部署到 Cloudflare Workers
### 方式一:使用 Wrangler CLI
#### 1. 安装 Wrangler CLI
```bash
npm install -g wrangler
```
#### 2. 登录 Cloudflare
```bash
wrangler login
```
#### 3. 克隆 Xget 仓库
```bash
git clone https://github.com/xixu-me/Xget.git
cd Xget
```
#### 4. 配置 Wrangler
创建 `wrangler.toml` 文件:
```toml
name = "xget"
main = "src/index.js"
compatibility_date = "2024-01-01"
[vars]
# 自定义配置变量
# CUSTOM_DOMAIN = "your-domain.com"
# KV 命名空间(可选)
[[kv_namespaces]]
binding = "CACHE"
id = "your-kv-namespace-id"
```
#### 5. 部署
```bash
wrangler deploy
```
#### 6. 验证部署
```bash
curl https://xget.your-subdomain.workers.dev/gh/microsoft/vscode/archive/main.zip
```
### 方式二:使用 Cloudflare Dashboard
#### 1. 登录 Cloudflare Dashboard
访问 [Cloudflare Dashboard](https://dash.cloudflare.com/)
#### 2. 创建 Worker
1. 点击 "Workers & Pages"
2. 点击 "Create Application"
3. 选择 "Create Worker"
4. 输入 Worker 名称
5. 点击 "Deploy"
#### 3. 上传代码
1. 在 Worker 编辑器中粘贴 Xget 代码
2. 点击 "Save and Deploy"
#### 4. 配置自定义域名(可选)
1. 在 Worker 设置中点击 "Triggers"
2. 点击 "Custom Domains"
3. 添加自定义域名
### 配置选项
#### 环境变量
在 `wrangler.toml` 中配置:
```toml
[vars]
# 缓存时长(秒)
CACHE_TTL = "1800"
# 最大重试次数
MAX_RETRIES = "3"
# 请求超时(毫秒)
REQUEST_TIMEOUT = "30000"
```
#### KV 存储
创建 KV 命名空间:
```bash
wrangler kv:namespace create "CACHE"
```
将返回的 ID 添加到 `wrangler.toml`。
#### 自定义域名
```bash
wrangler domains add your-domain.com
```
## 部署到 EdgeOne Pages
### 1. 准备代码
```bash
git clone https://github.com/xixu-me/Xget.git
cd Xget
```
### 2. 构建项目
```bash
npm install
npm run build
```
### 3. 登录腾讯云
访问 [腾讯云 EdgeOne 控制台](https://console.cloud.tencent.com/edgeone)
### 4. 创建站点
1. 点击 "站点列表"
2. 点击 "新建站点"
3. 输入域名信息
4. 选择 "静态网站" 或 "Serverless"
### 5. 上传代码
**方式一:Git 仓库**
1. 在站点设置中选择 "源站设置"
2. 添加 Git 仓库
3. 配置构建命令和输出目录
**方式二:直接上传**
1. 将构建后的文件打包
2. 在控制台上传文件包
### 6. 配置边缘函数
1. 在站点设置中选择 "边缘函数"
2. 创建新的边缘函数
3. 粘贴 Xget 代码
4. 配置路由规则
### 7. 验证部署
```bash
curl https://your-domain.com/gh/microsoft/vscode/archive/main.zip
```
## 部署到 Vercel
### 1. 安装 Vercel CLI
```bash
npm install -g vercel
```
### 2. 登录 Vercel
```bash
vercel login
```
### 3. 克隆仓库
```bash
git clone https://github.com/xixu-me/Xget.git
cd Xget
```
### 4. 部署
```bash
vercel
```
按照提示选择配置选项。
### 5. 配置环境变量
在 Vercel Dashboard 中添加环境变量:
- `CACHE_TTL`: 1800
- `MAX_RETRIES`: 3
- `REQUEST_TIMEOUT`: 30000
### 6. 生产部署
```bash
vercel --prod
```
### 7. 验证部署
```bash
curl https://your-project.vercel.app/gh/microsoft/vscode/archive/main.zip
```
## 部署到 Netlify
### 1. 安装 Netlify CLI
```bash
npm install -g netlify-cli
```
### 2. 登录 Netlify
```bash
netlify login
```
### 3. 克隆仓库
```bash
git clone https://github.com/xixu-me/Xget.git
cd Xget
```
### 4. 初始化项目
```bash
netlify init
```
按照提示选择配置选项。
### 5. 配置 Netlify Functions
创建 `netlify.toml` 文件:
```toml
[build]
functions = "netlify/functions"
[functions]
node_bundler = "esbuild"
```
### 6. 部署
```bash
netlify deploy --prod
```
### 7. 验证部署
```bash
curl https://your-site.netlify.app/gh/microsoft/vscode/archive/main.zip
```
## 部署到 Deno Deploy
### 1. 安装 Deno CLI
```bash
# 使用安装脚本(Linux/macOS)
curl -fsSL https://deno.land/install.sh | sh
# 使用 Homebrew(macOS)
brew install deno
# 使用 Chocolatey(Windows)
choco install deno
```
### 2. 克隆仓库
```bash
git clone https://github.com/xixu-me/Xget.git
cd Xget
```
### 3. 适配 Deno
将代码适配为 Deno 兼容格式:
```javascript
// 使用 Deno 标准库
import { serve } from "https://deno.land/std@0.208.0/http/server.ts";
async function handler(req) {
// Xget 核心逻辑
}
serve(handler);
```
### 4. 登录 Deno Deploy
访问 [Deno Deploy](https://dash.deno.com/) 并登录。
### 5. 创建新项目
1. 点击 "New Project"
2. 选择 "Deploy from GitHub"
3. 选择 Xget 仓库
4. 配置入口文件
5. 点击 "Deploy"
### 6. 配置环境变量
在项目设置中添加环境变量。
### 7. 验证部署
```bash
curl https://your-project.deno.dev/gh/microsoft/vscode/archive/main.zip
```
## 自托管部署(Docker)
### 1. 准备 Dockerfile
创建 `Dockerfile`:
```dockerfile
# 使用 Node.js 18 作为基础镜像
FROM node:18-alpine
# 设置工作目录
WORKDIR /app
# 复制 package 文件
COPY package*.json ./
# 安装依赖
RUN npm ci --only=production
# 复制源代码
COPY . .
# 暴露端口
EXPOSE 3000
# 启动应用
CMD ["node", "src/index.js"]
```
### 2. 构建 Docker 镜像
```bash
docker build -t xget:latest .
```
### 3. 运行容器
```bash
docker run -d \
--name xget \
-p 3000:3000 \
-e CACHE_TTL=1800 \
-e MAX_RETRIES=3 \
-e REQUEST_TIMEOUT=30000 \
xget:latest
```
### 4. 使用 Docker Compose
创建 `docker-compose.yml`:
```yaml
version: '3.8'
services:
xget:
build: .
container_name: xget
ports:
- "3000:3000"
environment:
- CACHE_TTL=1800
- MAX_RETRIES=3
- REQUEST_TIMEOUT=30000
restart: unless-stopped
networks:
- xget-network
networks:
xget-network:
driver: bridge
```
启动服务:
```bash
docker-compose up -d
```
### 5. 配置反向代理(Nginx)
创建 Nginx 配置:
```nginx
server {
listen 80;
server_name your-domain.com;
location / {
proxy_pass http://localhost:3000;
proxy_http_version 1.1;
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection 'upgrade';
proxy_set_header Host $host;
proxy_cache_bypass $http_upgrade;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
}
```
重启 Nginx:
```bash
sudo nginx -t
sudo systemctl restart nginx
```
### 6. 配置 SSL(Let's Encrypt)
使用 Certbot:
```bash
sudo apt install certbot python3-certbot-nginx
sudo certbot --nginx -d your-domain.com
```
### 7. 验证部署
```bash
curl https://your-domain.com/gh/microsoft/vscode/archive/main.zip
```
## 自托管部署(Podman)
### 1. 安装 Podman
```bash
# Ubuntu/Debian
sudo apt install podman
# Fedora
sudo dnf install podman
# Arch Linux
sudo pacman -S podman
```
### 2. 准备 Containerfile
创建 `Containerfile`(Podman 使用 Containerfile 而非 Dockerfile):
```dockerfile
# 使用 Node.js 18 作为基础镜像
FROM node:18-alpine
# 设置工作目录
WORKDIR /app
# 复制 package 文件
COPY package*.json ./
# 安装依赖
RUN npm ci --only=production
# 复制源代码
COPY . .
# 暴露端口
EXPOSE 3000
# 启动应用
CMD ["node", "src/index.js"]
```
### 3. 构建镜像
```bash
podman build -t xget:latest .
```
### 4. 运行容器
```bash
podman run -d \
--name xget \
-p 3000:3000 \
-e CACHE_TTL=1800 \
-e MAX_RETRIES=3 \
-e REQUEST_TIMEOUT=30000 \
xget:latest
```
### 5. 使用 Podman Compose
安装 Podman Compose:
```bash
pip install podman-compose
```
创建 `docker-compose.yml`(与 Docker 相同):
```yaml
version: '3.8'
services:
xget:
build: .
container_name: xget
ports:
- "3000:3000"
environment:
- CACHE_TTL=1800
- MAX_RETRIES=3
- REQUEST_TIMEOUT=30000
restart: unless-stopped
networks:
- xget-network
networks:
xget-network:
driver: bridge
```
启动服务:
```bash
podman-compose up -d
```
### 6. 配置系统服务
创建 systemd 服务文件 `/etc/systemd/system/xget.service`:
```ini
[Unit]
Description=Xget Service
After=network.target
[Service]
Type=forking
User=podman
Group=podman
ExecStart=/usr/bin/podman-compose -f /path/to/docker-compose.yml up -d
ExecStop=/usr/bin/podman-compose -f /path/to/docker-compose.yml down
Restart=always
[Install]
WantedBy=multi-user.target
```
启用并启动服务:
```bash
sudo systemctl daemon-reload
sudo systemctl enable xget
sudo systemctl start xget
```
### 7. 验证部署
```bash
curl https://your-domain.com/gh/microsoft/vscode/archive/main.zip
```
## 配置优化
### 性能优化
#### 1. 缓存配置
**Cloudflare Workers**
```javascript
const cache = caches.default;
async function cachedFetch(request) {
const cacheKey = new Request(request.url, request);
const cached = await cache.match(cacheKey);
if (cached) {
return cached;
}
const response = await fetch(request);
const clonedResponse = response.clone();
await cache.put(cacheKey, clonedResponse);
return response;
}
```
**自托管**
```javascript
const NodeCache = require('node-cache');
const cache = new NodeCache({ stdTTL: 1800 });
```
#### 2. 压缩配置
```javascript
// 启用压缩
const compression = require('compression');
app.use(compression());
```
#### 3. 连接池配置
```javascript
const http = require('http');
const https = require('https');
const agent = new https.Agent({
keepAlive: true,
maxSockets: 100,
maxFreeSockets: 10
});
```
### 安全配置
#### 1. CORS 配置
```javascript
app.use((req, res, next) => {
res.header('Access-Control-Allow-Origin', '*');
res.header('Access-Control-Allow-Methods', 'GET, HEAD, OPTIONS');
res.header('Access-Control-Allow-Headers', 'Content-Type');
next();
});
```
#### 2. 速率限制
```javascript
const rateLimit = require('express-rate-limit');
const limiter = rateLimit({
windowMs: 15 * 60 * 1000, // 15 分钟
max: 1000 // 每个窗口期最多 1000 个请求
});
app.use(limiter);
```
#### 3. 安全标头
```javascript
const helmet = require('helmet');
app.use(helmet());
```
### 监控配置
#### 1. 日志记录
```javascript
const winston = require('winston');
const logger = winston.createLogger({
level: 'info',
format: winston.format.json(),
transports: [
new winston.transports.File({ filename: 'error.log', level: 'error' }),
new winston.transports.File({ filename: 'combined.log' })
]
});
```
#### 2. 性能监控
```javascript
const promClient = require('prom-client');
const httpRequestDuration = new promClient.Histogram({
name: 'http_request_duration_seconds',
help: 'Duration of HTTP requests in seconds',
labelNames: ['method', 'route', 'code']
});
```
## 故障排查
### 常见问题
#### 1. 部署失败
**Cloudflare Workers**
- 检查 `wrangler.toml` 配置
- 确认账户权限
- 查看部署日志
**Docker**
- 检查 Dockerfile 语法
- 确认端口映射
- 查看容器日志
#### 2. 性能问题
- 检查缓存配置
- 优化压缩设置
- 调整连接池大小
#### 3. 安全问题
- 检查 CORS 配置
- 验证速率限制
- 审查安全标头
### 调试技巧
#### 1. 启用调试日志
```javascript
const DEBUG = process.env.DEBUG === 'true';
function debug(message) {
if (DEBUG) {
console.log(`[DEBUG] ${message}`);
}
}
```
#### 2. 性能分析
```javascript
const start = Date.now();
// 执行操作
const duration = Date.now() - start;
console.log(`Operation took ${duration}ms`);
```
#### 3. 错误追踪
```javascript
process.on('uncaughtException', (error) => {
console.error('Uncaught Exception:', error);
process.exit(1);
});
process.on('unhandledRejection', (reason, promise) => {
console.error('Unhandled Rejection at:', promise, 'reason:', reason);
});
```
## 维护指南
### 更新部署
#### Cloudflare Workers
```bash
git pull
wrangler deploy
```
#### Docker
```bash
git pull
docker-compose down
docker-compose build
docker-compose up -d
```
### 备份配置
```bash
# 备份配置文件
cp wrangler.toml wrangler.toml.backup
cp docker-compose.yml docker-compose.yml.backup
```
### 监控健康
```bash
# 检查服务状态
curl https://your-domain.com/health
# 检查容器状态
docker ps
# 检查 Worker 状态
wrangler tail
```
## 最佳实践
### 1. 使用环境变量
避免硬编码配置,使用环境变量:
```javascript
const config = {
cacheTTL: process.env.CACHE_TTL || 1800,
maxRetries: process.env.MAX_RETRIES || 3,
requestTimeout: process.env.REQUEST_TIMEOUT || 30000
};
```
### 2. 实现健康检查
```javascript
app.get('/health', (req, res) => {
res.json({ status: 'ok', timestamp: Date.now() });
});
```
### 3. 优雅关闭
```javascript
process.on('SIGTERM', () => {
server.close(() => {
console.log('Server closed');
process.exit(0);
});
});
```
### 4. 版本管理
使用语义化版本号:
```
v1.0.0 - 初始版本
v1.0.1 - 补丁更新
v1.1.0 - 次要更新
v2.0.0 - 主要更新
```
## 总结
Xget 支持多种部署方式,选择合适的部署方式取决于你的需求:
- **Cloudflare Workers**:推荐用于生产环境,性能最佳
- **EdgeOne Pages**:适合国内用户,访问速度快
- **Vercel/Netlify**:易于部署,适合个人项目
- **Deno Deploy**:现代化部署,支持 TypeScript
- **Docker/Podman**:自托管,完全控制
无论选择哪种部署方式,都建议:
1. 配置适当的缓存策略
2. 启用安全防护
3. 实施监控和日志
4. 定期更新和维护
---
# Xget 各平台使用指南
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-platform-usage-guide/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-platform-usage-guide.md
- Published: 2025-12-27T15:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 使用指南, 平台
详细说明Xget在GitHub、GitLab、Docker Hub、PyPI、Hugging Face等主流平台的具体使用方法和URL转换规则。本文提供各平台的加速示例、wget/curl命令模板以及常见问题解决方案,帮助开发者快速上手并充分利用Xget的加速能力
## 概述
本文档详细介绍了如何在各个支持平台上使用 Xget 进行加速。包括代码托管、包管理、容器镜像、AI 模型等各种场景的具体使用方法。
## 代码托管平台
### GitHub
#### 基本使用
**下载文件**
```bash
# 原始 URL
https://github.com/microsoft/vscode/archive/refs/heads/main.zip
# 加速 URL
wget https://xget.xi-xu.me/gh/microsoft/vscode/archive/refs/heads/main.zip
```
**下载 Release**
```bash
# 下载特定版本的 Release
wget https://xget.xi-xu.me/gh/nodejs/node/releases/download/v20.10.0/node-v20.10.0-x64.msi
```
#### Git 操作
**Clone 仓库**
```bash
# 完整克隆
git clone https://xget.xi-xu.me/gh/microsoft/vscode.git
# 浅克隆(只克隆最新提交)
git clone --depth 1 https://xget.xi-xu.me/gh/microsoft/vscode.git
# 克隆特定分支
git clone -b main https://xget.xi-xu.me/gh/microsoft/vscode.git
```
**Pull 和 Fetch**
```bash
# 拉取最新代码
git pull origin main
# 获取远程更新
git fetch origin
```
**Push 操作**
```bash
# 推送到远程仓库
git push origin main
# 推送所有分支
git push --all origin
```
**Submodule 操作**
```bash
# 克隆包含子模块的仓库
git clone --recursive https://xget.xi-xu.me/gh/microsoft/vscode.git
# 更新子模块
git submodule update --init --recursive
```
#### 高级用法
**Git LFS 支持**
```bash
# 克隆包含 LFS 文件的仓库
GIT_LFS_SKIP_SMUDGE=1 git clone https://xget.xi-xu.me/gh/microsoft/vscode.git
cd vscode
git lfs pull
```
**配置 Git 使用 Xget**
```bash
# 全局配置
git config --global url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
# 仅对特定仓库配置
cd your-repo
git config url."https://xget.xi-xu.me/gh/".insteadOf "https://github.com/"
```
### GitHub Gist
**下载 Gist**
```bash
# 下载 Gist 文件
wget https://xget.xi-xu.me/gist/xixu-me/e2ea9db6b1f143892495f796fef18631/raw/3b8807172ee492d0da3a7e370b0fb88fc97b53e6/Free-ChatGPT-Paid-Plan.md
```
**克隆 Gist**
```bash
# 克隆 Gist 仓库
git clone https://xget.xi-xu.me/gist/xixu-me/e2ea9db6b1f143892495f796fef18631.git
```
### GitLab
**下载文件**
```bash
# 下载压缩包
wget https://xget.xi-xu.me/gl/gitlab-org/gitlab/-/archive/master/gitlab-master.zip
```
**Git 操作**
```bash
# Clone 仓库
git clone https://xget.xi-xu.me/gl/gitlab-org/gitlab.git
# Pull 更新
git pull origin main
```
### Gitea
**下载文件**
```bash
# 下载压缩包
wget https://xget.xi-xu.me/gitea/gitea/gitea/archive/master.zip
```
**Git 操作**
```bash
# Clone 仓库
git clone https://xget.xi-xu.me/gitea/gitea/gitea.git
```
### Codeberg
**下载文件**
```bash
# 下载压缩包
wget https://xget.xi-xu.me/codeberg/forgejo/forgejo/archive/forgejo.zip
```
**Git 操作**
```bash
# Clone 仓库
git clone https://xget.xi-xu.me/codeberg/forgejo/forgejo.git
```
### SourceForge
**下载文件**
```bash
# 下载软件
wget https://xget.xi-xu.me/sf/projects/sevenzip/files/7-Zip/23.01/7z2301-x64.exe/download
```
**使用 aria2c 多线程下载**
```bash
aria2c -x 16 -s 16 https://xget.xi-xu.me/sf/projects/sevenzip/files/7-Zip/23.01/7z2301-x64.exe/download
```
### AOSP (Android 开源项目)
**Git 操作**
```bash
# Clone AOSP 项目
git clone https://xget.xi-xu.me/aosp/platform/frameworks/base
# Clone 设备树
git clone https://xget.xi-xu.me/aosp/device/google/pixel
```
**使用 repo 工具**
```bash
# 配置 repo 使用 Xget
export REPO_URL="https://xget.xi-xu.me/aosp/tools/repo"
# 初始化仓库
repo init -u https://xget.xi-xu.me/aosp/platform/manifest
# 同步代码
repo sync
```
## AI/ML 平台
### Hugging Face
**下载模型文件**
```bash
# 下载单个模型文件
wget https://xget.xi-xu.me/hf/microsoft/DialoGPT-medium/resolve/main/pytorch_model.bin
# 下载配置文件
wget https://xget.xi-xu.me/hf/microsoft/DialoGPT-medium/resolve/main/config.json
```
**下载完整模型**
```bash
# 使用 huggingface-cli
pip install huggingface-hub
# 配置使用 Xget
export HF_ENDPOINT="https://xget.xi-xu.me/hf"
# 下载模型
huggingface-cli download microsoft/DialoGPT-medium
```
**下载数据集**
```bash
# 下载数据集文件
wget https://xget.xi-xu.me/hf/datasets/rajpurkar/squad/resolve/main/plain_text/train-00000-of-00001.parquet
# 使用 datasets 库
pip install datasets
# 配置使用 Xget
export HF_ENDPOINT="https://xget.xi-xu.me/hf"
# 下载数据集
python -c "from datasets import load_dataset; ds = load_dataset('rajpurkar/squad')"
```
**Python 代码示例**
```python
from huggingface_hub import snapshot_download
# 配置使用 Xget
import os
os.environ['HF_ENDPOINT'] = 'https://xget.xi-xu.me/hf'
# 下载模型
model_path = snapshot_download(repo_id="microsoft/DialoGPT-medium")
```
### Civitai
**下载模型**
```bash
# 下载模型文件
wget https://xget.xi-xu.me/civitai/api/download/models/128713 -O model.safetensors
```
**使用 API**
```bash
# 获取模型信息
curl https://xget.xi-xu.me/civitai/api/v1/models/7240
# 获取模型版本信息
curl https://xget.xi-xu.me/civitai/api/v1/model-versions/128713
```
**Python 代码示例**
```python
import requests
# 配置使用 Xget
base_url = "https://xget.xi-xu.me/civitai/api"
# 获取模型信息
response = requests.get(f"{base_url}/v1/models/7240")
model_info = response.json()
# 下载模型
download_url = model_info['downloadUrl']
response = requests.get(download_url)
with open('model.safetensors', 'wb') as f:
f.write(response.content)
```
## 包管理平台
### npm
**配置 npm 使用 Xget**
```bash
# 设置 npm 注册表
npm config set registry https://xget.xi-xu.me/npm
# 验证配置
npm config get registry
```
**安装包**
```bash
# 安装包
npm install react
# 安装特定版本
npm install react@18.2.0
# 全局安装
npm install -g typescript
```
**下载包文件**
```bash
# 直接下载包文件
wget https://xget.xi-xu.me/npm/react/-/react-18.2.0.tgz
```
**使用 .npmrc**
在项目根目录创建 `.npmrc` 文件:
```
registry=https://xget.xi-xu.me/npm
```
### PyPI
**配置 pip 使用 Xget**
```bash
# 使用 Xget 作为索引 URL
pip install --index-url https://xget.xi-xu.me/pypi requests
# 额外索引 URL
pip install --extra-index-url https://xget.xi-xu.me/pypi requests
```
**使用 pip.conf**
创建或编辑 `~/.pip/pip.conf`:
```ini
[global]
index-url = https://xget.xi-xu.me/pypi
```
**下载包文件**
```bash
# 下载源码包
wget https://xget.xi-xu.me/pypi/packages/source/r/requests/requests-2.31.0.tar.gz
# 下载 Wheel 文件
wget https://xget.xi-xu.me/pypi/packages/py3/n/numpy/numpy-1.26.2-cp312-cp312-win_amd64.whl
```
**使用 pip download**
```bash
# 下载包及其依赖
pip download --index-url https://xget.xi-xu.me/pypi requests
# 下载到指定目录
pip download --index-url https://xget.xi-xu.me/pypi -d ./packages requests
```
### conda
**配置 conda 使用 Xget**
```bash
# 添加 Xget 作为频道
conda config --add channels https://xget.xi-xu.me/conda/pkgs/main
# 添加社区频道
conda config --add channels https://xget.xi-xu.me/conda/community/conda-forge
# 验证配置
conda config --show channels
```
**安装包**
```bash
# 安装包
conda install python=3.11
# 从特定频道安装
conda install -c https://xget.xi-xu.me/conda/community/conda-forge pytorch
```
**下载包文件**
```bash
# 下载包文件
wget https://xget.xi-xu.me/conda/pkgs/main/win-64/python-3.11.0-h955f1ad_0.conda
```
**使用 .condarc**
创建或编辑 `~/.condarc`:
```yaml
channels:
- https://xget.xi-xu.me/conda/pkgs/main
- https://xget.xi-xu.me/conda/community/conda-forge
- defaults
```
### Maven
**配置 Maven 使用 Xget**
编辑 `~/.m2/settings.xml`:
```xml
xget-maven
central
Xget Maven Mirror
https://xget.xi-xu.me/maven2
```
**下载依赖**
```bash
# 使用 Maven 下载依赖
mvn dependency:resolve
# 下载源码
mvn dependency:sources
```
**下载 JAR 文件**
```bash
# 直接下载 JAR 文件
wget https://xget.xi-xu.me/maven2/org/springframework/spring-core/6.1.1/spring-core-6.1.1.jar
```
### Gradle
**配置 Gradle 使用 Xget**
编辑 `build.gradle`:
```groovy
repositories {
maven { url 'https://xget.xi-xu.me/maven2' }
mavenCentral()
}
```
或编辑 `settings.gradle`:
```groovy
dependencyResolutionManagement {
repositories {
maven { url 'https://xget.xi-xu.me/maven2' }
mavenCentral()
}
}
```
**下载依赖**
```bash
# 下载依赖
./gradlew dependencies
# 下载源码
./gradlew downloadSources
```
**下载插件**
```bash
# 下载 Gradle 插件
wget https://xget.xi-xu.me/gradle/m2/com/github/ben-manes/gradle-caches-plugin/0.9.0/gradle-caches-plugin-0.9.0.pom
```
### Homebrew
**配置 Homebrew 使用 Xget**
```bash
# 设置 Homebrew 使用 Xget
export HOMEBREW_BREW_GIT_REMOTE="https://xget.xi-xu.me/homebrew/brew"
export HOMEBREW_CORE_GIT_REMOTE="https://xget.xi-xu.me/homebrew/homebrew-core"
# 更新 Homebrew
brew update
```
**安装软件**
```bash
# 安装软件
brew install python
# 安装 Cask
brew install --cask visual-studio-code
```
### RubyGems
**配置 gem 使用 Xget**
```bash
# 设置 gem 源
gem sources --add https://xget.xi-xu.me/rubygems
gem sources --remove https://rubygems.org/
# 验证配置
gem sources -l
```
**安装 gem**
```bash
# 安装 gem
gem install rails
# 安装特定版本
gem install rails -v 7.1.2
```
**下载 gem 文件**
```bash
# 下载 gem 文件
wget https://xget.xi-xu.me/rubygems/gems/rails-7.1.2.gem
```
### CRAN (R)
**配置 R 使用 Xget**
在 R 中执行:
```r
# 设置 CRAN 镜像
options(repos = c(CRAN = "https://xget.xi-xu.me/cran"))
# 验证配置
options()$repos
```
**安装包**
```r
# 安装包
install.packages("ggplot2")
# 安装特定版本
install.packages("https://xget.xi-xu.me/cran/src/contrib/Archive/ggplot2/ggplot2_3.4.4.tar.gz")
```
**下载包文件**
```bash
# 下载源码包
wget https://xget.xi-xu.me/cran/src/contrib/ggplot2_3.4.4.tar.gz
```
### CPAN (Perl)
**配置 CPAN 使用 Xget**
```bash
# 设置 CPAN 镜像
cpanm --mirror https://xget.xi-xu.me/cpan --mirror-only Module::Name
```
**安装模块**
```bash
# 安装模块
cpanm Plack
# 从 URL 安装
cpanm https://xget.xi-xu.me/cpan/authors/id/M/MI/MIYAGAWA/Plack-1.050.tar.gz
```
**下载模块文件**
```bash
# 下载模块文件
wget https://xget.xi-xu.me/cpan/authors/id/M/MI/MIYAGAWA/Plack-1.050.tar.gz
```
### CTAN (TeX/LaTeX)
**下载 TeX 包**
```bash
# 下载 TeX 包
wget https://xget.xi-xu.me/ctan/tex-archive/macros/latex/contrib/beamer.zip
# 使用 tlmgr 配置
tlmgr option repository https://xget.xi-xu.me/ctan/tex-archive/tlcontrib
```
### Go 模块
**配置 Go 使用 Xget**
```bash
# 设置 Go 代理
export GOPROXY=https://xget.xi-xu.me/golang
# 验证配置
go env GOPROXY
```
**下载模块**
```bash
# 下载模块
go mod download github.com/golang/go@v1.21.5
# 获取依赖
go get github.com/golang/go@v1.21.5
```
**下载模块文件**
```bash
# 下载模块文件
wget https://xget.xi-xu.me/golang/github.com/golang/go/@v/v1.21.5.zip
```
### NuGet (.NET)
**配置 NuGet 使用 Xget**
编辑 `NuGet.Config`:
```xml
```
**安装包**
```bash
# 使用 dotnet 安装包
dotnet add package Newtonsoft.Json --source https://xget.xi-xu.me/nuget
# 使用 NuGet CLI
nuget install Newtonsoft.Json -Source https://xget.xi-xu.me/nuget
```
**下载包文件**
```bash
# 下载 nupkg 文件
wget https://xget.xi-xu.me/nuget/v3-flatcontainer/newtonsoft.json/13.0.3/newtonsoft.json.13.0.3.nupkg
```
### Rust Crates
**配置 Cargo 使用 Xget**
编辑 `~/.cargo/config.toml`:
```toml
[source.xget]
registry = "https://xget.xi-xu.me/crates"
[registries.xget]
index = "https://xget.xi-xu.me/crates"
[crates-io]
replace-with = "xget"
```
**安装 crate**
```bash
# 安装 crate
cargo install ripgrep
# 添加依赖
cargo add serde
```
**下载 crate 文件**
```bash
# 下载 crate 文件
wget https://xget.xi-xu.me/crates/api/v1/crates/serde/1.0.195/download
```
### Packagist (PHP)
**配置 Composer 使用 Xget**
编辑 `composer.json`:
```json
{
"repositories": [
{
"type": "composer",
"url": "https://xget.xi-xu.me/packagist"
}
]
}
```
或编辑 `~/.composer/config.json`:
```json
{
"repositories": {
"packagist.org": {
"type": "composer",
"url": "https://xget.xi-xu.me/packagist"
}
}
}
```
**安装包**
```bash
# 安装包
composer require laravel/framework
# 更新依赖
composer update
```
## 系统包管理平台
### Debian/Ubuntu
**配置 apt 使用 Xget**
编辑 `/etc/apt/sources.list`:
```
deb https://xget.xi-xu.me/debian bookworm main contrib non-free
```
或编辑 `/etc/apt/sources.list.d/xget.list`:
```
deb https://xget.xi-xu.me/ubuntu jammy main restricted universe multiverse
```
**更新和安装**
```bash
# 更新包列表
sudo apt update
# 安装包
sudo apt install nginx
# 下载包文件
apt-get download nginx
```
### Fedora
**配置 dnf 使用 Xget**
编辑 `/etc/yum.repos.d/xget.repo`:
```ini
[xget]
name=Xget Fedora Mirror
baseurl=https://xget.xi-xu.me/fedora/linux/releases/$releasever/Everything/$basearch/os/
enabled=1
gpgcheck=0
```
**更新和安装**
```bash
# 更新包列表
sudo dnf makecache
# 安装包
sudo dnf install nginx
# 下载包文件
sudo dnf download nginx
```
### Rocky Linux
**配置 dnf 使用 Xget**
编辑 `/etc/yum.repos.d/xget.repo`:
```ini
[xget-baseos]
name=Xget Rocky Linux BaseOS
baseurl=https://xget.xi-xu.me/rocky/$releasever/BaseOS/$basearch/os/
enabled=1
gpgcheck=0
[xget-appstream]
name=Xget Rocky Linux AppStream
baseurl=https://xget.xi-xu.me/rocky/$releasever/AppStream/$basearch/os/
enabled=1
gpgcheck=0
```
**更新和安装**
```bash
# 更新包列表
sudo dnf makecache
# 安装包
sudo dnf install nginx
```
### openSUSE
**配置 zypper 使用 Xget**
```bash
# 添加仓库
sudo zypper ar -f https://xget.xi-xu.me/opensuse/tumbleweed/repo/oss xget-oss
# 刷新仓库
sudo zypper refresh
```
**更新和安装**
```bash
# 更新包列表
sudo zypper refresh
# 安装包
sudo zypper install nginx
# 下载包文件
sudo zypper download nginx
```
### Arch Linux
**配置 pacman 使用 Xget**
编辑 `/etc/pacman.conf`:
```ini
[xget]
Server = https://xget.xi-xu.me/arch/$repo/os/$arch
```
**更新和安装**
```bash
# 更新包列表
sudo pacman -Sy
# 安装包
sudo pacman -S nginx
# 下载包文件
sudo pacman -Sw nginx
```
## 其他平台
### arXiv
**下载论文**
```bash
# 下载 PDF
wget https://xget.xi-xu.me/arxiv/pdf/2312.12345.pdf
# 下载源码
wget https://xget.xi-xu.me/arxiv/e-print/2312.12345
```
### F-Droid
**下载应用**
```bash
# 下载 APK
wget https://xget.xi-xu.me/fdroid/repo/com.example.app_100.apk
# 配置 F-Droid 客户端
# 在 F-Droid 客户端中添加仓库:https://xget.xi-xu.me/fdroid/repo
```
### Jenkins 插件
**下载插件**
```bash
# 下载插件
wget https://xget.xi-xu.me/jenkins/latest/git.hpi
# 配置 Jenkins 使用 Xget
# 在 Jenkins 系统配置中设置更新站点:https://xget.xi-xu.me/jenkins/update-center.json
```
### Apache 软件下载
**下载软件**
```bash
# 下载软件
wget https://xget.xi-xu.me/apache/tomcat/tomcat-10/v10.1.15/bin/apache-tomcat-10.1.15.tar.gz
# 使用 aria2c 多线程下载
aria2c -x 16 -s 16 https://xget.xi-xu.me/apache/tomcat/tomcat-10/v10.1.15/bin/apache-tomcat-10.1.15.tar.gz
```
### 容器注册表
**配置 Docker 使用 Xget**
编辑 `/etc/docker/daemon.json`:
```json
{
"registry-mirrors": [
"https://xget.xi-xu.me/cr/registry-1.docker.io"
]
}
```
重启 Docker:
```bash
sudo systemctl restart docker
```
**拉取镜像**
```bash
# 拉取镜像
docker pull nginx:latest
# 拉取特定标签
docker pull nginx:1.25
# 拉取私有镜像
docker pull ghcr.io/user/image:tag
```
**使用 Podman**
```bash
# 配置 Podman 使用 Xget
podman pull docker.io/nginx:latest
# 拉取镜像
podman pull nginx:latest
```
### AI 推理提供商
**配置 OpenAI 使用 Xget**
```bash
# 使用 curl
curl https://xget.xi-xu.me/ip/api.openai.com/v1/chat/completions \
-H "Authorization: Bearer YOUR_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-4",
"messages": [{"role": "user", "content": "Hello!"}]
}'
```
**Python 代码示例**
```python
import openai
# 配置使用 Xget
openai.api_base = "https://xget.xi-xu.me/ip/api.openai.com/v1"
openai.api_key = "YOUR_API_KEY"
# 发送请求
response = openai.ChatCompletion.create(
model="gpt-4",
messages=[{"role": "user", "content": "Hello!"}]
)
```
**配置 Anthropic 使用 Xget**
```python
import anthropic
# 配置使用 Xget
client = anthropic.Anthropic(
api_key="YOUR_API_KEY",
base_url="https://xget.xi-xu.me/ip/api.anthropic.com"
)
# 发送请求
message = client.messages.create(
model="claude-3-opus-20240229",
max_tokens=1024,
messages=[{"role": "user", "content": "Hello!"}]
)
```
## 下载工具
### wget
**基本使用**
```bash
# 下载文件
wget https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
# 指定输出文件名
wget -O vscode.zip https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
# 断点续传
wget -c https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
```
### cURL
**基本使用**
```bash
# 下载文件
curl -o vscode.zip https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
# 显示进度条
curl -# -o vscode.zip https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
# 断点续传
curl -C - -o vscode.zip https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
```
### aria2
**多线程下载**
```bash
# 16 线程下载
aria2c -x 16 -s 16 https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
# 批量下载
aria2c -i urls.txt
# 断点续传
aria2c -c https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
```
### IDM (Internet Download Manager)
**使用方法**
1. 复制加速 URL
2. IDM 会自动捕获下载
3. 或手动添加到 IDM
**配置**
- 在 IDM 设置中配置最大连接数
- 启用分段下载
- 配置下载速度限制
## CI/CD 集成
### GitHub Actions
**配置示例**
```yaml
name: Build and Test
on: [push, pull_request]
jobs:
build:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- name: Setup Node.js
uses: actions/setup-node@v4
with:
node-version: '20'
registry-url: 'https://xget.xi-xu.me/npm'
- name: Install dependencies
run: npm ci
- name: Build
run: npm run build
- name: Test
run: npm test
```
### GitLab CI
**配置示例**
```yaml
image: node:20
variables:
NPM_CONFIG_REGISTRY: "https://xget.xi-xu.me/npm"
before_script:
- npm ci
stages:
- build
- test
build:
stage: build
script:
- npm run build
test:
stage: test
script:
- npm test
```
## 常见问题
### Q1: 如何验证 Xget 是否正常工作?
A: 下载一个小文件并检查速度:
```bash
time wget https://xget.xi-xu.me/gh/microsoft/vscode/archive/main.zip
```
### Q2: 如何切换回原始源?
A: 恢复原始配置:
```bash
# npm
npm config set registry https://registry.npmjs.org
# pip
pip install --index-url https://pypi.org requests
# apt
sudo sed -i 's/xget.xi-xu.me/deb.debian.org/g' /etc/apt/sources.list
```
### Q3: Xget 支持哪些协议?
A: Xget 支持 HTTP/HTTPS、Git、Docker、AI 推理等多种协议。
### Q4: 如何提高下载速度?
A: 使用多线程下载工具:
```bash
aria2c -x 16 -s 16 URL
```
### Q5: Xget 会缓存文件吗?
A: 是的,Xget 使用 Cloudflare Cache API 进行边缘缓存,默认缓存时长为 30 分钟。
## 总结
Xget 为 40+ 开发者常用平台提供了统一的加速服务。通过简单的 URL 转换或配置更改,即可享受极速下载体验。无论是代码托管、包管理、容器镜像还是 AI 模型,Xget 都能提供稳定、高效的加速服务。
---
# Xget 项目介绍与核心优势
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-introduction-and-core-advantages/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-introduction-and-core-advantages.md
- Published: 2025-12-27T15:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: 开发工具, Xget, 加速器
Xget是面向开发者资源的超高性能一体化加速引擎,覆盖代码仓库、模型数据集、包管理器、容器镜像和AI推理服务等场景。本文深入解析其Cloudflare边缘节点架构、HTTP/3协议优势、毫秒级响应能力以及相比传统加速器的核心优势,助力开发者提升工作效率
## 项目概述
Xget 是一个面向开发者资源的超高性能、安全、一体化加速引擎,其性能显著优于传统解决方案。它为代码存储库、模型和数据集中心、软件包注册表、容器注册表、AI 推理提供商等提供统一、高效的加速服务。
### 技术深度解析
项目的技术深度解析文章已发布:**[《深入剖析 Xget:一个高性能、多协议、高安全性的开发者资源加速引擎》](https://blog.xi-xu.me/2025/10/07/deep-dive-into-xget-technology.html)**。
## 快速开始
### 预部署实例
- **不保证可靠性的预部署实例**:`xget.xi-xu.me`
### URL 转换器
**[xuc.xi-xu.me](https://xuc.xi-xu.me)** - 一键转换任意支持平台的 URL 为 Xget 的加速格式!
## 核心优势
### 1. 极速性能 - 突破传统加速器瓶颈
#### 毫秒级响应
- Cloudflare 全球 330+ 边缘节点
- 平均响应时间 < 50ms
#### HTTP/3 极速协议
- 启用最新 HTTP/3 协议
- 连接延迟降低 40%
- 传输速度提升 30%
#### 智能多重压缩
- 支持 gzip、deflate、brotli 三重压缩算法
- 传输效率提升 60%
#### 零延迟预连接
- 连接预热和保持活跃
- 消除握手开销
- 实现秒级响应
#### 并行分片下载
- 完整支持 HTTP Range 请求
- 多线程下载速度倍增
#### 智能路由优化
- 自动选择最优传输路径
- 避开网络拥堵节点
### 2. 多平台深度集成
#### 一站式多平台支持
- 统一支持各种开发场景中的主流平台
- 覆盖代码托管、包管理、容器镜像等多个领域
#### 智能识别与转换
- 自动识别平台前缀并转换为目标平台的正确 URL 结构
- 无需手动记忆各平台的 URL 格式
#### 一致的加速体验
- 无论文件类型或来源,均可享受统一且稳定的极速下载体验
### 3. 企业级安全保障
#### 多层安全标头
**Strict-Transport-Security**
- 强制 HTTPS 传输
- 预防中间人攻击
**X-Frame-Options: DENY**
- 防止点击劫持攻击
**X-XSS-Protection**
- 内置 XSS 防护机制
**Content-Security-Policy**
- 严格的内容安全策略
**Referrer-Policy**
- 控制引用信息泄露
#### 请求验证机制
**HTTP 方法白名单**
- 常规请求限制为 GET/HEAD
- Git 操作动态允许 POST
**路径长度限制**
- 防止超长 URL 攻击(最大 2048 字符)
**输入清理**
- 防止路径遍历和注入攻击
#### 超时保护
- 30 秒请求超时
- 防止资源耗尽和恶意请求
### 4. 现代架构与可靠性
#### 智能重试机制
**重试策略**
- 最大 3 次重试
- 线性延迟策略(1000ms × 重试次数)
- 自动错误恢复,提高下载成功率
- 超时检测和中断处理
#### 高效缓存策略
**缓存配置**
- 1800 秒(30 分钟)默认缓存时长
- 显著减少源站压力
- Git 操作跳过缓存,确保实时性
- 基于 Cloudflare Cache API 的边缘缓存
#### 性能监控系统
**监控功能**
- 内置 `PerformanceMonitor` 类
- 实时追踪请求各阶段耗时
- 通过 `X-Performance-Metrics` 响应头提供详细性能数据
- 支持缓存命中率统计和优化建议
### 5. Git 协议完全兼容
#### 智能协议检测
**自动识别**
- 自动识别 Git 特定端点(`/info/refs`、`/git-upload-pack`、`/git-receive-pack`)
- 检测 Git 客户端 User-Agent 模式
- 支持 `service=git-upload-pack` 等查询参数
#### 完整操作支持
**支持的操作**
- `git clone`:完整存储库克隆,支持浅克隆和分支指定
- `git push`:代码推送和分支管理
- `git pull/fetch`:增量更新和远程同步
- `git submodule`:子模块递归克隆
#### 协议优化
**优化特性**
- 保持 Git 专用请求头和认证信息
- 智能 User-Agent 处理(默认 `git/2.34.1`)
- 支持 Git LFS 大文件传输
### 6. 生态系统集成
#### 专用浏览器扩展
**Xget Now**
- 提供无缝体验
- 自动 URL 重定向,无需手动修改 URL
- 支持自定义 Xget 实例域名
- 多平台偏好设置和黑白名单管理
- 本地处理,确保隐私安全
#### 下载工具兼容
- 完美支持 wget、cURL、aria2、IDM 等主流下载工具
#### CI/CD 集成
- 可直接在 GitHub Actions、GitLab CI 等环境中使用
## 支持的平台概览
Xget 支持以下主要平台:
### 代码托管平台
- GitHub
- GitHub Gist
- GitLab
- Gitea
- Codeberg
- SourceForge
- AOSP (Android 开源项目)
### AI/ML 平台
- Hugging Face (模型和数据集)
- Civitai (AI 模型平台)
- AI 推理提供商
### 包管理器
- npm (JavaScript)
- PyPI (Python)
- conda (Python)
- Maven (Java)
- Gradle (Java)
- Homebrew (macOS)
- RubyGems (Ruby)
- CRAN (R)
- CPAN (Perl)
- CTAN (TeX/LaTeX)
- Go 模块
- NuGet (.NET)
- Rust Crates
- Packagist (PHP)
### 系统包管理
- Debian/Ubuntu apt
- Fedora dnf
- Rocky Linux dnf
- openSUSE zypper
- Arch Linux pacman
### 其他平台
- arXiv (论文下载)
- F-Droid (Android 应用)
- Jenkins (插件下载)
- 容器注册表 (Docker Hub, GHCR, GCR 等)
- Apache 软件下载
## 技术亮点总结
1. **性能卓越**:基于 Cloudflare 边缘网络,HTTP/3 协议,智能压缩
2. **安全可靠**:多层安全防护,请求验证,超时保护
3. **架构现代**:智能重试,高效缓存,性能监控
4. **协议兼容**:完整支持 Git 协议,Docker 协议,AI 推理协议
5. **生态集成**:浏览器扩展,下载工具兼容,CI/CD 集成
6. **多平台支持**:覆盖 40+ 开发者常用平台
Xget 通过其卓越的性能、全面的安全性和广泛的平台支持,为开发者提供了一个统一、高效的资源加速解决方案。
---
# Xget 系统架构设计
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-system-architecture/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-system-architecture.md
- Published: 2025-12-27T15:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 架构设计, 系统设计
深入剖析Xget基于Cloudflare Workers的边缘计算系统架构,从请求识别、协议适配、缓存检查到上游获取的完整处理流程。本文展示其多协议适配器设计、Mermaid架构图解以及高可用高并发的系统设计理念,揭示现代边缘计算架构的精妙之处
## 概述
Xget 采用现代化的边缘计算架构,基于 Cloudflare Workers 构建,实现了高性能、高可用、高安全的开发者资源加速服务。本文档详细介绍了 Xget 的系统架构设计。
## 请求处理流程
### 完整流程图
```mermaid
graph TD
Request[用户请求 / User-Agent] --> Identify{识别平台}
Identify -->|无效| Error[返回错误]
Identify -->|有效| Transform[转换路径]
Transform --> CheckProtocol{检查协议}
CheckProtocol -->|Git| GitHandler[Git 协议适配器]
CheckProtocol -->|Docker| DockerHandler[Docker 协议适配器]
CheckProtocol -->|AI| AIHandler[AI 推理适配器]
CheckProtocol -->|标准| StdHandler[标准适配器]
GitHandler --> Upstream[获取上游]
DockerHandler --> Upstream
AIHandler --> Upstream
StdHandler --> CacheCheck{检查缓存}
CacheCheck -->|命中| ReturnCache[返回缓存响应]
CacheCheck -->|未命中| Upstream
Upstream -->|成功| ProcessResponse[处理响应]
Upstream -->|失败| Retry{重试?}
Retry -->|是| Wait["等待 (退避)"] --> Upstream
Retry -->|否| Error
ProcessResponse --> Finalize[添加标头并返回]
Finalize --> Response[响应]
```
### 流程详解
#### 1. 请求接收与识别
**输入阶段**
- 接收来自客户端的 HTTP 请求
- 解析请求路径,提取平台前缀和资源路径
- 验证请求格式和参数
**平台识别**
- 根据路径前缀识别目标平台(如 `gh` 代表 GitHub)
- 验证平台是否在支持列表中
- 无效平台返回 404 错误
#### 2. 路径转换
**转换逻辑**
- 移除平台前缀
- 根据平台规则构建上游 URL
- 处理特殊路径和查询参数
**示例**
```
输入: /gh/microsoft/vscode/archive/main.zip
转换: https://github.com/microsoft/vscode/archive/main.zip
```
#### 3. 协议检测
**协议类型**
- **Git 协议**:检测 Git 特定端点和 User-Agent
- **Docker 协议**:检测容器镜像拉取请求
- **AI 推理协议**:检测 AI 模型推理请求
- **标准协议**:常规 HTTP 请求
#### 4. 协议适配器处理
**Git 协议适配器**
- 配置 Git 专用请求头
- 处理 Git LFS 大文件传输
- 支持 Git 认证信息传递
**Docker 协议适配器**
- 处理 Docker Hub 认证
- 获取容器镜像 Token
- 支持多层镜像拉取
**AI 推理适配器**
- 配置 AI 服务专用请求头
- 处理流式响应
- 支持 API 密钥传递
**标准适配器**
- 处理常规 HTTP 请求
- 支持断点续传(Range 请求)
#### 5. 缓存检查(标准协议)
**缓存策略**
- 检查 Cloudflare Cache API
- 验证缓存有效性
- 命中缓存直接返回
**缓存规则**
- 默认缓存时长:1800 秒(30 分钟)
- Git 操作:跳过缓存
- 大文件:延长缓存时间
#### 6. 上游请求
**请求构建**
- 根据转换后的 URL 构建上游请求
- 添加必要的请求头
- 配置超时和重试参数
**请求发送**
- 使用 Cloudflare Workers 的 fetch API
- 支持 HTTP/3 协议
- 自动处理重定向
#### 7. 重试机制
**重试条件**
- 网络错误
- 超时错误
- 5xx 服务器错误
**重试策略**
- 最大重试次数:3 次
- 延迟策略:线性退避(1000ms × 重试次数)
- 指数退避备选方案
#### 8. 响应处理
**响应头处理**
- 添加安全标头
- 添加性能监控标头
- 移除敏感信息
**响应体处理**
- 支持流式传输
- 应用压缩算法
- 处理 Range 响应
#### 9. 性能监控
**监控指标**
- 请求总耗时
- 上游请求耗时
- 缓存命中率
- 错误率
**监控输出**
- 通过 `X-Performance-Metrics` 响应头返回
- JSON 格式数据
- 包含详细的性能指标
## 组件架构
### 类图
```mermaid
classDiagram
class Worker {
+handleRequest(request)
}
class Config {
+PLATFORMS
+transformPath()
}
class Validation {
+validateRequest()
+isDockerRequest()
}
class GitProtocol {
+configureGitHeaders()
+isGitRequest()
}
class DockerProtocol {
+handleDockerAuth()
+fetchToken()
}
class AIProtocol {
+configureAIHeaders()
}
class Security {
+addSecurityHeaders()
}
class Performance {
+monitor()
}
Worker --> Config
Worker --> Validation
Worker --> GitProtocol
Worker --> DockerProtocol
Worker --> AIProtocol
Worker --> Security
Worker --> Performance
```
### 组件详解
#### 1. Worker(主处理器)
**职责**
- 协调所有组件
- 管理请求生命周期
- 处理错误和异常
**核心方法**
```javascript
async handleRequest(request) {
// 1. 验证请求
// 2. 识别平台
// 3. 转换路径
// 4. 检测协议
// 5. 调用适配器
// 6. 处理响应
// 7. 返回结果
}
```
#### 2. Config(配置管理)
**职责**
- 存储平台配置
- 提供路径转换逻辑
- 管理环境变量
**配置结构**
```javascript
const PLATFORMS = {
gh: {
name: 'GitHub',
baseUrl: 'https://github.com',
supportsGit: true
},
// ... 其他平台
}
```
#### 3. Validation(请求验证)
**职责**
- 验证请求合法性
- 检查请求方法
- 验证路径长度
**验证规则**
- HTTP 方法白名单
- 路径长度限制(最大 2048 字符)
- 输入清理和过滤
#### 4. GitProtocol(Git 协议适配器)
**职责**
- 检测 Git 请求
- 配置 Git 请求头
- 处理 Git LFS
**关键方法**
```javascript
isGitRequest(request) {
// 检测 Git 特征
}
configureGitHeaders(request) {
// 添加 Git 专用头
}
```
#### 5. DockerProtocol(Docker 协议适配器)
**职责**
- 处理 Docker Hub 认证
- 获取镜像 Token
- 支持多层镜像
**认证流程**
1. 检测 Docker 请求
2. 获取认证 Token
3. 添加认证头
4. 转发请求
#### 6. AIProtocol(AI 推理适配器)
**职责**
- 配置 AI 服务请求头
- 处理流式响应
- 支持 API 密钥
**支持的 AI 提供商**
- OpenAI
- Anthropic
- Google AI
- 其他兼容 OpenAI API 的服务
#### 7. Security(安全组件)
**职责**
- 添加安全标头
- 验证请求合法性
- 防止攻击
**安全标头**
```javascript
const securityHeaders = {
'Strict-Transport-Security': 'max-age=31536000',
'X-Frame-Options': 'DENY',
'X-XSS-Protection': '1; mode=block',
'Content-Security-Policy': 'default-src \'self\'',
'Referrer-Policy': 'strict-origin-when-cross-origin'
}
```
#### 8. Performance(性能监控)
**职责**
- 追踪请求耗时
- 计算缓存命中率
- 生成性能报告
**监控指标**
```javascript
{
totalTime: 123, // 总耗时(毫秒)
upstreamTime: 98, // 上游请求耗时
cacheHit: true, // 缓存是否命中
retryCount: 0, // 重试次数
protocol: 'HTTP/3' // 使用的协议
}
```
## 数据流架构
### 请求流
```
客户端请求
↓
Cloudflare 边缘节点
↓
Worker 请求处理
↓
协议适配器
↓
缓存检查
↓
上游请求(如需要)
↓
响应处理
↓
安全标头添加
↓
性能监控记录
↓
返回客户端
```
### 缓存流
```
请求到达
↓
检查 Cloudflare Cache
↓
缓存命中?
├─ 是 → 返回缓存
└─ 否 → 请求上游
↓
获取响应
↓
存入缓存
↓
返回响应
```
## 性能优化策略
### 1. 边缘计算
**优势**
- 请求在最近的边缘节点处理
- 减少网络延迟
- 提高响应速度
**实现**
- Cloudflare Workers 部署
- 全球 330+ 边缘节点
- 自动路由优化
### 2. 协议优化
**HTTP/3**
- 基于 QUIC 协议
- 减少连接建立时间
- 提高传输效率
**HTTP/2**
- 多路复用
- 头部压缩
- 服务器推送
### 3. 缓存策略
**多层缓存**
- Cloudflare 边缘缓存
- 浏览器缓存
- CDN 缓存
**缓存规则**
- 静态资源:长期缓存
- API 响应:短期缓存
- Git 操作:不缓存
### 4. 压缩算法
**支持的压缩**
- gzip
- deflate
- brotli
**压缩策略**
- 根据客户端 Accept 头选择
- 自动选择最优压缩算法
- 压缩级别可配置
## 可靠性设计
### 1. 故障恢复
**重试机制**
- 自动重试失败请求
- 指数退避策略
- 最大重试次数限制
**降级策略**
- 缓存降级
- 超时降级
- 错误降级
### 2. 监控告警
**性能监控**
- 实时性能指标
- 错误率监控
- 缓存命中率统计
**告警机制**
- 错误率阈值告警
- 响应时间告警
- 可用性告警
### 3. 容量规划
**自动扩容**
- Cloudflare 自动扩容
- 无需手动配置
- 按需分配资源
**负载均衡**
- 全局负载均衡
- 智能路由
- 故障转移
## 安全架构
### 1. 网络安全
**HTTPS 强制**
- 所有请求强制 HTTPS
- HSTS 启用
- 证书自动更新
**DDoS 防护**
- Cloudflare DDoS 防护
- 流量清洗
- 攻击识别
### 2. 应用安全
**输入验证**
- 严格的输入验证
- 路径遍历防护
- 注入攻击防护
**请求限制**
- 速率限制
- IP 白名单
- 请求大小限制
### 3. 数据安全
**敏感信息保护**
- 不记录敏感数据
- API 密钥加密存储
- 日志脱敏
**访问控制**
- 基于角色的访问控制
- API 密钥认证
- IP 限制
## 扩展性设计
### 1. 平台扩展
**添加新平台**
- 在 Config 中添加平台配置
- 实现平台特定的转换逻辑
- 测试平台集成
**示例**
```javascript
const PLATFORMS = {
// ... 现有平台
newplatform: {
name: 'New Platform',
baseUrl: 'https://newplatform.com',
supportsGit: false
}
}
```
### 2. 协议扩展
**添加新协议**
- 创建新的协议适配器
- 实现协议特定的逻辑
- 在 Worker 中注册适配器
**适配器接口**
```javascript
class NewProtocol {
isRequest(request) { }
configureHeaders(request) { }
handleResponse(response) { }
}
```
### 3. 功能扩展
**插件系统**
- 支持自定义插件
- 插件生命周期管理
- 插件间通信
**中间件**
- 请求中间件
- 响应中间件
- 错误处理中间件
## 总结
Xget 的系统架构设计体现了现代云原生应用的最佳实践:
1. **边缘优先**:利用 Cloudflare 边缘网络实现低延迟
2. **协议适配**:支持多种协议的统一处理
3. **性能优化**:多层缓存、智能压缩、HTTP/3
4. **安全可靠**:多层安全防护、自动重试、监控告警
5. **易于扩展**:模块化设计、插件系统、配置驱动
这种架构设计使 Xget 能够提供高性能、高可用、高安全的开发者资源加速服务。
---
# Xget URL 转换规则详解
- Canonical: https://www.zeroxin.xin/2025/12/27/xget-url-conversion-rules/
- Markdown: https://www.zeroxin.xin/2025/12/27/xget-url-conversion-rules.md
- Published: 2025-12-27T15:00:00+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Categories: 技术文档
- Tags: Xget, 使用指南, URL转换
全面介绍Xget加速服务的URL转换规则和各平台语法格式,涵盖GitHub、GitLab、Docker Hub、PyPI、Hugging Face等主流平台的URL转换示例。本文提供详细的路径映射规则和参数说明,帮助开发者快速掌握将任意资源URL转换为Xget加速格式的方法
## 概述
Xget 使用简单直观的 URL 转换规则,只需替换域名并添加平台前缀即可实现加速。本文档详细介绍了所有支持平台的 URL 转换规则。
## 基本转换格式
### 转换公式
```
原始 URL: https://platform.com/path/to/resource
加速 URL: https://xget.xi-xu.me/{platform-prefix}/path/to/resource
```
### 转换步骤
1. **识别平台**:确定原始 URL 所属平台
2. **查找前缀**:找到对应的平台前缀
3. **替换域名**:将原始域名替换为 Xget 域名
4. **添加前缀**:在路径前添加平台前缀
## 平台前缀对照表
| 平台 | 平台前缀 | 原始域名 | 支持类型 |
|------|----------|----------|----------|
| GitHub | `gh` | `github.com` | 代码、Git |
| GitHub Gist | `gist` | `gist.github.com` | 代码片段 |
| GitLab | `gl` | `gitlab.com` | 代码、Git |
| Gitea | `gitea` | `gitea.com` | 代码、Git |
| Codeberg | `codeberg` | `codeberg.org` | 代码、Git |
| SourceForge | `sf` | `sourceforge.net` | 软件 |
| AOSP | `aosp` | `android.googlesource.com` | 代码、Git |
| Hugging Face | `hf` | `huggingface.co` | 模型、数据集 |
| Civitai | `civitai` | `civitai.com` | AI 模型 |
| npm | `npm` | `registry.npmjs.org` | 包管理 |
| PyPI | `pypi` | `pypi.org` | 包管理 |
| conda | `conda` | `repo.anaconda.com` | 包管理 |
| Maven | `maven` | `repo1.maven.org` | 包管理 |
| Apache | `apache` | `downloads.apache.org` | 软件 |
| Gradle | `gradle` | `plugins.gradle.org` | 包管理 |
| Homebrew | `homebrew` | `github.com/Homebrew` | 包管理 |
| RubyGems | `rubygems` | `rubygems.org` | 包管理 |
| CRAN | `cran` | `cran.r-project.org` | 包管理 |
| CPAN | `cpan` | `www.cpan.org` | 包管理 |
| CTAN | `ctan` | `tug.ctan.org` | 包管理 |
| Go 模块 | `golang` | `proxy.golang.org` | 包管理 |
| NuGet | `nuget` | `api.nuget.org` | 包管理 |
| Rust Crates | `crates` | `crates.io` | 包管理 |
| Packagist | `packagist` | `repo.packagist.org` | 包管理 |
| Debian | `debian` | `deb.debian.org` | 系统包 |
| Ubuntu | `ubuntu` | `archive.ubuntu.com` | 系统包 |
| Fedora | `fedora` | `dl.fedoraproject.org` | 系统包 |
| Rocky Linux | `rocky` | `download.rockylinux.org` | 系统包 |
| openSUSE | `opensuse` | `download.opensuse.org` | 系统包 |
| Arch Linux | `arch` | `geo.mirror.pkgbuild.com` | 系统包 |
| arXiv | `arxiv` | `arxiv.org` | 论文 |
| F-Droid | `fdroid` | `f-droid.org` | 应用 |
| Jenkins 插件 | `jenkins` | `updates.jenkins.io` | 插件 |
| 容器注册表 | `cr` | 多个 | 容器镜像 |
| AI 推理提供商 | `ip` | 多个 | AI 推理 |
## 各平台转换详解
### 代码托管平台
#### GitHub
**平台前缀**:`gh`
**原始 URL 格式**:
```
https://github.com/{owner}/{repo}/path/to/file
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/gh/{owner}/{repo}/path/to/file
```
**转换示例**:
1. **下载压缩包**
```
原始: https://github.com/microsoft/vscode/archive/refs/heads/main.zip
加速: https://xget.xi-xu.me/gh/microsoft/vscode/archive/refs/heads/main.zip
```
2. **下载 Release 文件**
```
原始: https://github.com/nodejs/node/releases/download/v20.10.0/node-v20.10.0-x64.msi
加速: https://xget.xi-xu.me/gh/nodejs/node/releases/download/v20.10.0/node-v20.10.0-x64.msi
```
3. **Git Clone**
```
原始: https://github.com/microsoft/vscode.git
加速: https://xget.xi-xu.me/gh/microsoft/vscode.git
```
**特殊说明**:
- 支持 Git 协议完整操作(clone、push、pull、fetch)
- 支持 Git LFS 大文件传输
- 自动识别 Git 端点并配置专用请求头
#### GitHub Gist
**平台前缀**:`gist`
**原始 URL 格式**:
```
https://gist.github.com/{username}/{gist-id}/path/to/file
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/gist/{username}/{gist-id}/path/to/file
```
**转换示例**:
```
原始: https://gist.github.com/xixu-me/e2ea9db6b1f143892495f796fef18631/raw/3b8807172ee492d0da3a7e370b0fb88fc97b53e6/Free-ChatGPT-Paid-Plan.md
加速: https://xget.xi-xu.me/gist/xixu-me/e2ea9db6b1f143892495f796fef18631/raw/3b8807172ee492d0da3a7e370b0fb88fc97b53e6/Free-ChatGPT-Paid-Plan.md
```
#### GitLab
**平台前缀**:`gl`
**原始 URL 格式**:
```
https://gitlab.com/{owner}/{repo}/path/to/file
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/gl/{owner}/{repo}/path/to/file
```
**转换示例**:
```
原始: https://gitlab.com/gitlab-org/gitlab/-/archive/master/gitlab-master.zip
加速: https://xget.xi-xu.me/gl/gitlab-org/gitlab/-/archive/master/gitlab-master.zip
```
**特殊说明**:
- GitLab 使用 `/-/` 分隔符,保持原样
- 支持 Git 协议完整操作
#### Gitea
**平台前缀**:`gitea`
**原始 URL 格式**:
```
https://gitea.com/{owner}/{repo}/path/to/file
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/gitea/{owner}/{repo}/path/to/file
```
**转换示例**:
```
原始: https://gitea.com/gitea/gitea/archive/master.zip
加速: https://xget.xi-xu.me/gitea/gitea/gitea/archive/master.zip
```
#### Codeberg
**平台前缀**:`codeberg`
**原始 URL 格式**:
```
https://codeberg.org/{owner}/{repo}/path/to/file
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/codeberg/{owner}/{repo}/path/to/file
```
**转换示例**:
```
原始: https://codeberg.org/forgejo/forgejo/archive/forgejo.zip
加速: https://xget.xi-xu.me/codeberg/forgejo/forgejo/archive/forgejo.zip
```
#### SourceForge
**平台前缀**:`sf`
**原始 URL 格式**:
```
https://sourceforge.net/projects/{project}/files/{path}/download
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/sf/projects/{project}/files/{path}/download
```
**转换示例**:
```
原始: https://sourceforge.net/projects/sevenzip/files/7-Zip/23.01/7z2301-x64.exe/download
加速: https://xget.xi-xu.me/sf/projects/sevenzip/files/7-Zip/23.01/7z2301-x64.exe/download
```
#### AOSP (Android 开源项目)
**平台前缀**:`aosp`
**原始 URL 格式**:
```
https://android.googlesource.com/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/aosp/{path}
```
**转换示例**:
1. **AOSP 项目**
```
原始: https://android.googlesource.com/platform/frameworks/base
加速: https://xget.xi-xu.me/aosp/platform/frameworks/base
```
2. **AOSP 设备树**
```
原始: https://android.googlesource.com/device/google/pixel
加速: https://xget.xi-xu.me/aosp/device/google/pixel
```
### AI/ML 平台
#### Hugging Face
**平台前缀**:`hf`
**原始 URL 格式**:
```
https://huggingface.co/{type}/{owner}/{model}/resolve/main/{file}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/hf/{type}/{owner}/{model}/resolve/main/{file}
```
**转换示例**:
1. **模型文件**
```
原始: https://huggingface.co/microsoft/DialoGPT-medium/resolve/main/pytorch_model.bin
加速: https://xget.xi-xu.me/hf/microsoft/DialoGPT-medium/resolve/main/pytorch_model.bin
```
2. **数据集文件**
```
原始: https://huggingface.co/datasets/rajpurkar/squad/resolve/main/plain_text/train-00000-of-00001.parquet
加速: https://xget.xi-xu.me/hf/datasets/rajpurkar/squad/resolve/main/plain_text/train-00000-of-00001.parquet
```
**特殊说明**:
- 支持 `models` 和 `datasets` 两种类型
- 支持大文件分片下载
- 自动处理 Hugging Face 的认证
#### Civitai
**平台前缀**:`civitai`
**原始 URL 格式**:
```
https://civitai.com/api/{version}/{endpoint}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/civitai/api/{version}/{endpoint}
```
**转换示例**:
1. **模型下载**
```
原始: https://civitai.com/api/download/models/128713
加速: https://xget.xi-xu.me/civitai/api/download/models/128713
```
2. **模型 API**
```
原始: https://civitai.com/api/v1/models/7240
加速: https://xget.xi-xu.me/civitai/api/v1/models/7240
```
3. **模型版本 API**
```
原始: https://civitai.com/api/v1/model-versions/128713
加速: https://xget.xi-xu.me/civitai/api/v1/model-versions/128713
```
### 包管理平台
#### npm
**平台前缀**:`npm`
**原始 URL 格式**:
```
https://registry.npmjs.org/{package}/-/{package}-{version}.tgz
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/npm/{package}/-/{package}-{version}.tgz
```
**转换示例**:
1. **包文件**
```
原始: https://registry.npmjs.org/react/-/react-18.2.0.tgz
加速: https://xget.xi-xu.me/npm/react/-/react-18.2.0.tgz
```
2. **包元数据**
```
原始: https://registry.npmjs.org/lodash
加速: https://xget.xi-xu.me/npm/lodash
```
#### PyPI
**平台前缀**:`pypi`
**原始 URL 格式**:
```
https://pypi.org/packages/{type}/{package[0]}/{package}/{package}-{version}.{ext}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/pypi/packages/{type}/{package[0]}/{package}/{package}-{version}.{ext}
```
**转换示例**:
1. **源码包**
```
原始: https://pypi.org/packages/source/r/requests/requests-2.31.0.tar.gz
加速: https://xget.xi-xu.me/pypi/packages/source/r/requests/requests-2.31.0.tar.gz
```
2. **Wheel 文件**
```
原始: https://pypi.org/packages/py3/n/numpy/numpy-1.26.2-cp312-cp312-win_amd64.whl
加速: https://xget.xi-xu.me/pypi/packages/py3/n/numpy/numpy-1.26.2-cp312-cp312-win_amd64.whl
```
#### conda
**平台前缀**:`conda`
**原始 URL 格式**:
```
https://repo.anaconda.com/pkgs/{channel}/{package}
https://conda.anaconda.org/{channel}/{package}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/conda/pkgs/{channel}/{package}
https://xget.xi-xu.me/conda/community/{channel}/{package}
```
**转换示例**:
1. **主仓库**
```
原始: https://repo.anaconda.com/pkgs/main/win-64/python-3.11.0-h955f1ad_0.conda
加速: https://xget.xi-xu.me/conda/pkgs/main/win-64/python-3.11.0-h955f1ad_0.conda
```
2. **社区仓库**
```
原始: https://conda.anaconda.org/conda-forge/win-64/pytorch-2.1.0-py311_cuda121_cudnn8_0.tar.bz2
加速: https://xget.xi-xu.me/conda/community/conda-forge/win-64/pytorch-2.1.0-py311_cuda121_cudnn8_0.tar.bz2
```
#### Maven
**平台前缀**:`maven`
**原始 URL 格式**:
```
https://repo1.maven.org/maven2/{group}/{artifact}/{version}/{artifact}-{version}.{ext}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/maven2/{group}/{artifact}/{version}/{artifact}-{version}.{ext}
```
**转换示例**:
```
原始: https://repo1.maven.org/maven2/org/springframework/spring-core/6.1.1/spring-core-6.1.1.jar
加速: https://xget.xi-xu.me/maven2/org/springframework/spring-core/6.1.1/spring-core-6.1.1.jar
```
#### Gradle
**平台前缀**:`gradle`
**原始 URL 格式**:
```
https://plugins.gradle.org/m2/{group}/{artifact}/{version}/{artifact}-{version}.{ext}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/gradle/m2/{group}/{artifact}/{version}/{artifact}-{version}.{ext}
```
**转换示例**:
```
原始: https://plugins.gradle.org/m2/com/github/ben-manes/gradle-caches-plugin/0.9.0/gradle-caches-plugin-0.9.0.pom
加速: https://xget.xi-xu.me/gradle/m2/com/github/ben-manes/gradle-caches-plugin/0.9.0/gradle-caches-plugin-0.9.0.pom
```
#### Homebrew
**平台前缀**:`homebrew`
**原始 URL 格式**:
```
https://github.com/Homebrew/{repo}/archive/refs/tags/{tag}.tar.gz
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/homebrew/{repo}/archive/refs/tags/{tag}.tar.gz
```
**转换示例**:
```
原始: https://github.com/Homebrew/brew/archive/refs/tags/4.2.0.tar.gz
加速: https://xget.xi-xu.me/homebrew/brew/archive/refs/tags/4.2.0.tar.gz
```
#### RubyGems
**平台前缀**:`rubygems`
**原始 URL 格式**:
```
https://rubygems.org/gems/{gem}-{version}.gem
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/rubygems/gems/{gem}-{version}.gem
```
**转换示例**:
```
原始: https://rubygems.org/gems/rails-7.1.2.gem
加速: https://xget.xi-xu.me/rubygems/gems/rails-7.1.2.gem
```
#### CRAN (R)
**平台前缀**:`cran`
**原始 URL 格式**:
```
https://cran.r-project.org/src/contrib/{package}_{version}.tar.gz
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/cran/src/contrib/{package}_{version}.tar.gz
```
**转换示例**:
```
原始: https://cran.r-project.org/src/contrib/ggplot2_3.4.4.tar.gz
加速: https://xget.xi-xu.me/cran/src/contrib/ggplot2_3.4.4.tar.gz
```
#### CPAN (Perl)
**平台前缀**:`cpan`
**原始 URL 格式**:
```
https://www.cpan.org/authors/id/{author}/{package}-{version}.tar.gz
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/cpan/authors/id/{author}/{package}-{version}.tar.gz
```
**转换示例**:
```
原始: https://www.cpan.org/authors/id/M/MI/MIYAGAWA/Plack-1.050.tar.gz
加速: https://xget.xi-xu.me/cpan/authors/id/M/MI/MIYAGAWA/Plack-1.050.tar.gz
```
#### CTAN (TeX/LaTeX)
**平台前缀**:`ctan`
**原始 URL 格式**:
```
https://tug.ctan.org/tex-archive/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/ctan/tex-archive/{path}
```
**转换示例**:
```
原始: https://tug.ctan.org/tex-archive/macros/latex/contrib/beamer.zip
加速: https://xget.xi-xu.me/ctan/tex-archive/macros/latex/contrib/beamer.zip
```
#### Go 模块
**平台前缀**:`golang`
**原始 URL 格式**:
```
https://proxy.golang.org/{module}/@v/{version}.zip
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/golang/{module}/@v/{version}.zip
```
**转换示例**:
```
原始: https://proxy.golang.org/github.com/golang/go/@v/v1.21.5.zip
加速: https://xget.xi-xu.me/golang/github.com/golang/go/@v/v1.21.5.zip
```
#### NuGet (.NET)
**平台前缀**:`nuget`
**原始 URL 格式**:
```
https://api.nuget.org/v3-flatcontainer/{package}/{version}/{package}.{version}.nupkg
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/nuget/v3-flatcontainer/{package}/{version}/{package}.{version}.nupkg
```
**转换示例**:
```
原始: https://api.nuget.org/v3-flatcontainer/newtonsoft.json/13.0.3/newtonsoft.json.13.0.3.nupkg
加速: https://xget.xi-xu.me/nuget/v3-flatcontainer/newtonsoft.json/13.0.3/newtonsoft.json.13.0.3.nupkg
```
#### Rust Crates
**平台前缀**:`crates`
**原始 URL 格式**:
```
https://crates.io/api/v1/crates/{crate}/{version}/download
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/crates/api/v1/crates/{crate}/{version}/download
```
**转换示例**:
```
原始: https://crates.io/api/v1/crates/serde/1.0.195/download
加速: https://xget.xi-xu.me/crates/api/v1/crates/serde/1.0.195/download
```
#### Packagist (PHP)
**平台前缀**:`packagist`
**原始 URL 格式**:
```
https://repo.packagist.org/p/{vendor}/{package}.json
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/packagist/p/{vendor}/{package}.json
```
**转换示例**:
```
原始: https://repo.packagist.org/p/laravel/framework.json
加速: https://xget.xi-xu.me/packagist/p/laravel/framework.json
```
### 系统包管理平台
#### Debian
**平台前缀**:`debian`
**原始 URL 格式**:
```
https://deb.debian.org/debian/{pool}/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/debian/{pool}/{path}
```
**转换示例**:
```
原始: https://deb.debian.org/debian/pool/main/n/nginx/nginx_1.25.3-1_amd64.deb
加速: https://xget.xi-xu.me/debian/pool/main/n/nginx/nginx_1.25.3-1_amd64.deb
```
#### Ubuntu
**平台前缀**:`ubuntu`
**原始 URL 格式**:
```
https://archive.ubuntu.com/ubuntu/{pool}/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/ubuntu/{pool}/{path}
```
**转换示例**:
```
原始: https://archive.ubuntu.com/ubuntu/pool/main/c/curl/curl_8.4.0-2ubuntu1_amd64.deb
加速: https://xget.xi-xu.me/ubuntu/pool/main/c/curl/curl_8.4.0-2ubuntu1_amd64.deb
```
#### Fedora
**平台前缀**:`fedora`
**原始 URL 格式**:
```
https://dl.fedoraproject.org/pub/fedora/linux/releases/{version}/Everything/{arch}/os/Packages/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/fedora/linux/releases/{version}/Everything/{arch}/os/Packages/{path}
```
**转换示例**:
```
原始: https://dl.fedoraproject.org/pub/fedora/linux/releases/39/Everything/x86_64/os/Packages/n/nginx-1.25.3-1.fc39.x86_64.rpm
加速: https://xget.xi-xu.me/fedora/linux/releases/39/Everything/x86_64/os/Packages/n/nginx-1.25.3-1.fc39.x86_64.rpm
```
#### Rocky Linux
**平台前缀**:`rocky`
**原始 URL 格式**:
```
https://download.rockylinux.org/pub/rocky/{version}/BaseOS/{arch}/os/Packages/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/rocky/{version}/BaseOS/{arch}/os/Packages/{path}
```
**转换示例**:
```
原始: https://download.rockylinux.org/pub/rocky/9/BaseOS/x86_64/os/Packages/n/nginx-1.20.1-14.el9_2.1.x86_64.rpm
加速: https://xget.xi-xu.me/rocky/9/BaseOS/x86_64/os/Packages/n/nginx-1.20.1-14.el9_2.1.x86_64.rpm
```
#### openSUSE
**平台前缀**:`opensuse`
**原始 URL 格式**:
```
https://download.opensuse.org/{distribution}/repo/{repo}/{arch}/{package}.rpm
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/opensuse/{distribution}/repo/{repo}/{arch}/{package}.rpm
```
**转换示例**:
```
原始: https://download.opensuse.org/tumbleweed/repo/oss/x86_64/nginx-1.25.3-1.1.x86_64.rpm
加速: https://xget.xi-xu.me/opensuse/tumbleweed/repo/oss/x86_64/nginx-1.25.3-1.1.x86_64.rpm
```
#### Arch Linux
**平台前缀**:`arch`
**原始 URL 格式**:
```
https://geo.mirror.pkgbuild.com/{repo}/os/{arch}/{package}.pkg.tar.zst
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/arch/{repo}/os/{arch}/{package}.pkg.tar.zst
```
**转换示例**:
```
原始: https://geo.mirror.pkgbuild.com/core/os/x86_64/nginx-1.25.3-1-x86_64.pkg.tar.zst
加速: https://xget.xi-xu.me/arch/core/os/x86_64/nginx-1.25.3-1-x86_64.pkg.tar.zst
```
### 其他平台
#### arXiv
**平台前缀**:`arxiv`
**原始 URL 格式**:
```
https://arxiv.org/pdf/{paper-id}.pdf
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/arxiv/pdf/{paper-id}.pdf
```
**转换示例**:
```
原始: https://arxiv.org/pdf/2312.12345.pdf
加速: https://xget.xi-xu.me/arxiv/pdf/2312.12345.pdf
```
#### F-Droid
**平台前缀**:`fdroid`
**原始 URL 格式**:
```
https://f-droid.org/repo/{path}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/fdroid/repo/{path}
```
**转换示例**:
```
原始: https://f-droid.org/repo/com.example.app_100.apk
加速: https://xget.xi-xu.me/fdroid/repo/com.example.app_100.apk
```
#### Jenkins 插件
**平台前缀**:`jenkins`
**原始 URL 格式**:
```
https://updates.jenkins.io/latest/{plugin}.hpi
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/jenkins/latest/{plugin}.hpi
```
**转换示例**:
```
原始: https://updates.jenkins.io/latest/git.hpi
加速: https://xget.xi-xu.me/jenkins/latest/git.hpi
```
#### Apache 软件下载
**平台前缀**:`apache`
**原始 URL 格式**:
```
https://downloads.apache.org/{project}/{file}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/apache/{project}/{file}
```
**转换示例**:
```
原始: https://downloads.apache.org/tomcat/tomcat-10/v10.1.15/bin/apache-tomcat-10.1.15.tar.gz
加速: https://xget.xi-xu.me/apache/tomcat/tomcat-10/v10.1.15/bin/apache-tomcat-10.1.15.tar.gz
```
### 容器注册表
**平台前缀**:`cr`
**支持的注册表**:
- Docker Hub (`docker.io`)
- GitHub Container Registry (`ghcr.io`)
- Google Container Registry (`gcr.io`)
- Azure Container Registry (`azurecr.io`)
- AWS Elastic Container Registry (`public.ecr.aws`)
- Quay.io (`quay.io`)
**原始 URL 格式**:
```
https://{registry}/v2/{image}/manifests/{tag}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/cr/{registry}/{image}/manifests/{tag}
```
**转换示例**:
1. **Docker Hub**
```
原始: https://registry-1.docker.io/v2/library/nginx/manifests/latest
加速: https://xget.xi-xu.me/cr/registry-1.docker.io/library/nginx/manifests/latest
```
2. **GitHub Container Registry**
```
原始: https://ghcr.io/v2/user/image/manifests/v1.0
加速: https://xget.xi-xu.me/cr/ghcr.io/user/image/manifests/v1.0
```
### AI 推理提供商
**平台前缀**:`ip`
**支持的提供商**:
- OpenAI (`api.openai.com`)
- Anthropic (`api.anthropic.com`)
- Google AI (`generativelanguage.googleapis.com`)
- 其他兼容 OpenAI API 的服务
**原始 URL 格式**:
```
https://{provider}/v1/{endpoint}
```
**加速 URL 格式**:
```
https://xget.xi-xu.me/ip/{provider}/v1/{endpoint}
```
**转换示例**:
1. **OpenAI**
```
原始: https://api.openai.com/v1/chat/completions
加速: https://xget.xi-xu.me/ip/api.openai.com/v1/chat/completions
```
2. **Anthropic**
```
原始: https://api.anthropic.com/v1/messages
加速: https://xget.xi-xu.me/ip/api.anthropic.com/v1/messages
```
## URL 转换器
为了简化 URL 转换过程,Xget 提供了在线 URL 转换器:
**[xuc.xi-xu.me](https://xuc.xi-xu.me)**
### 使用方法
1. 访问 [xuc.xi-xu.me](https://xuc.xi-xu.me)
2. 粘贴原始 URL
3. 点击转换按钮
4. 获取加速 URL
### 功能特性
- 自动识别平台
- 一键转换 URL
- 支持批量转换
- 复制到剪贴板
## 注意事项
### 1. 大小写敏感
- 平台前缀必须小写
- 路径保持原始大小写
### 2. 特殊字符
- URL 中的特殊字符需要正确编码
- 查询参数保持原样
### 3. Git 操作
- Git 操作使用相同的转换规则
- 自动识别 Git 端点
- 支持 `.git` 后缀
### 4. 认证信息
- 不支持在 URL 中传递认证信息
- 使用环境变量或配置文件
### 5. 自定义域名
- 可以使用自己部署的 Xget 实例
- 替换 `xget.xi-xu.me` 为你的域名
## 常见问题
### Q1: 如何验证转换后的 URL 是否正确?
A: 访问转换后的 URL,如果返回预期的内容,说明转换正确。
### Q2: 转换后的 URL 可以在浏览器中直接访问吗?
A: 可以,但某些平台可能需要特定的请求头,建议使用对应的工具。
### Q3: 支持自定义平台吗?
A: 可以通过修改配置文件添加自定义平台。
### Q4: 转换后的 URL 会失效吗?
A: 不会,只要 Xget 实例正常运行,转换后的 URL 持续有效。
### Q5: 如何批量转换多个 URL?
A: 使用在线转换器的批量转换功能,或编写脚本进行批量转换。
## 总结
Xget 的 URL 转换规则简单直观,只需:
1. 替换域名为 Xget 域名
2. 在路径前添加平台前缀
3. 保持原始路径不变
通过这种简单的转换规则,Xget 为 40+ 开发者常用平台提供了统一的加速服务。
---
# COSMIC:System76 打造的下一代 Linux 桌面环境
- Canonical: https://www.zeroxin.xin/2025/12/22/cosmic-desktop-introduction/
- Markdown: https://www.zeroxin.xin/2025/12/22/cosmic-desktop-introduction.md
- Published: 2025-12-22T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 系统技术
- Tags: 开源项目, Linux, 桌面环境, System76, Rust, Wayland
详细介绍System76公司使用Rust语言从零开发的COSMIC桌面环境,涵盖其在Pop!_OS 24.04 LTS中的首次亮相、Wayland协议支持、现代化UI设计以及为Linux桌面生态带来的技术创新与性能突破,探索Rust在系统编程中的广阔前景
在 Linux 桌面环境的激烈竞争中,System76 公司推出了一款革命性的新产品——COSMIC 桌面环境。这个全新的桌面环境不仅代表了技术上的重大突破,更是为 Linux 用户带来了前所未有的使用体验。
## 什么是 COSMIC?
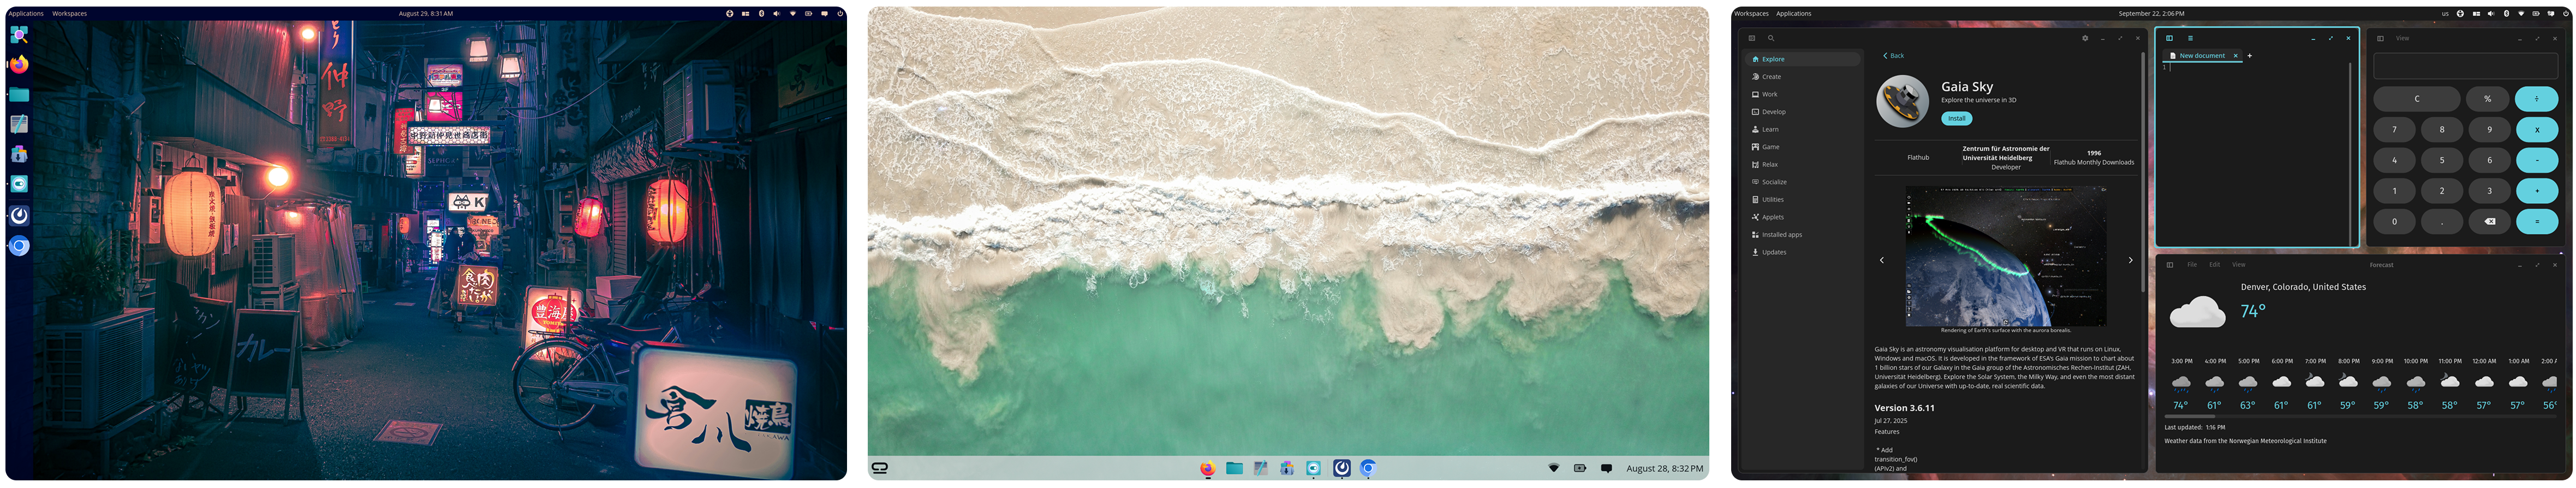
COSMIC 是 System76 公司自主研发的桌面环境,它标志着该公司从传统的 GNOME 桌面环境转向自主研发的里程碑。作为一个完全用 Rust 编程语言构建的桌面环境,COSMIC 展现了 System76 对创新和质量的执着追求。
COSMIC 已经在 Pop!_OS 24.04 LTS 中首次亮相,标志着 System76 在桌面环境领域的重大进展。这个全新的桌面环境不仅适用于 System76 的硬件产品,也为其他 Linux 发行版提供了一个优秀的选择。
## 技术特色
### 1. Rust 语言的力量
COSMIC 最引人注目的特点之一就是完全采用 Rust 语言开发。Rust 以其内存安全特性著称,能够有效防止常见的编程错误,如缓冲区溢出和空指针解引用。这不仅提高了系统的稳定性,还大大增强了安全性。
**内存安全保障**:
- 防止缓冲区溢出攻击
- 消除 use-after-free 漏洞
- 避免空指针解引用
- 减少竞态条件
### 2. Wayland 原生支持
作为 Wayland 原生桌面环境,COSMIC 充分利用了现代显示服务器的优势,提供了更好的图形性能和更流畅的用户体验。与传统的 X11 相比,Wayland 提供了更现代化的图形架构。
**Wayland 的优势**:
- 更好的图形性能
- 更低的延迟
- 更简洁的架构
- 更好的 HiDPI 支持
- 增强的安全性
### 3. 模块化设计
COSMIC 采用模块化架构,使得各个组件可以独立开发和维护。这种设计不仅提高了系统的可维护性,还为用户提供了更多的自定义可能性。
## 功能特性
### 个性化定制
#### 🔧 灵活的面板系统
- **自定义面板**:用户可以根据需要自定义面板的位置和样式
- **小程序支持**:支持各种小程序来扩展桌面功能
- **动态布局**:支持水平和垂直面板配置
#### 🎨 强大的主题系统
- **自定义主题**:提供强大的主题定制功能,可以根据品牌需求调整颜色方案
- **品牌适配**:轻松创建符合组织品牌形象的默认主题
- **可读性保证**:确保主题定制不影响文字可读性
#### 📱 现代窗口管理
- **平铺窗口**:支持高级的窗口管理功能
- **工作区管理**:支持动态和固定工作区
- **键盘快捷键**:丰富的键盘快捷键支持
#### 🚀 应用启动器
- **启动器**:提供直观的应用程序访问方式
- **应用库**:统一的应用管理界面
- **搜索功能**:快速定位和启动应用
### 开发者友好
COSMIC 为开发者提供了友好的开发环境:
- **统一开发栈**:使用相同的语言和工具包构建应用程序和小程序
- **模板支持**:提供有用的模板和开发工具
- **统一体验**:从应用到桌面组件的完整开发体验
- **模块化架构**:易于扩展和维护
## 安全与性能
### 🛡️ 内存安全
由于采用 Rust 语言,COSMIC 从根本上消除了许多传统桌面环境面临的安全隐患:
- **防止键盘记录器攻击**:Rust 的内存安全特性有效防止恶意代码注入
- **避免输入欺骗攻击**:增强的输入处理机制
- **减少缓冲区溢出风险**:编译时的安全检查
- **消除 use-after-free 漏洞**:自动内存管理
### ⚡ 性能优化
COSMIC 在设计时充分考虑了性能和效率:
- **启动速度优化**:快速的系统启动和应用加载
- **资源使用效率**:较低的内存和 CPU 占用
- **流畅的动画效果**:硬件加速的界面动画
- **响应式交互**:即时响应的用户操作
## 应用前景
### 在 Pop!_OS 中的应用
COSMIC 已经在 Pop!_OS 24.04 LTS 中正式亮相,为用户提供了全新的桌面体验:
- **默认桌面环境**:成为 Pop!_OS 的默认桌面环境
- **系统集成**:与 Pop!_OS 的其他组件深度集成
- **用户体验**:提供一致性和现代化的用户界面
### 跨发行版支持
虽然目前主要集成在 Pop!_OS 中,COSMIC 的设计也考虑到了跨发行版的兼容性:
- **独立部署**:可以作为独立的桌面环境部署到其他发行版
- **包管理器支持**:通过包管理器轻松安装
- **配置迁移**:支持配置和设置的迁移
## 社区与生态
### 开源社区
COSMIC 得到了活跃的开源社区支持:
- **开发者参与**:鼓励开发者参与项目贡献
- **社区驱动**:基于社区反馈持续改进
- **文档完善**:提供详细的开发和使用文档
### 生态系统
随着 COSMIC 的发展,相关的生态系统也在逐步建立:
- **应用开发**:专门为 COSMIC 开发的应用程序
- **主题生态**:丰富的第三方主题资源
- **扩展插件**:各种功能扩展和插件
## 与其他桌面环境的对比
### vs GNOME
| 特性 | COSMIC | GNOME |
|------|--------|-------|
| 开发语言 | Rust | C/Vala |
| 显示服务器 | Wayland 原生 | Wayland/X11 |
| 内存安全 | ✅ 编译时保证 | ❌ 运行时检查 |
| 模块化程度 | ✅ 高度模块化 | ⚠️ 适中 |
| 定制能力 | ✅ 强定制性 | ⚠️ 有限 |
### vs KDE Plasma
| 特性 | COSMIC | KDE Plasma |
|------|--------|------------|
| 资源占用 | ✅ 轻量级 | ⚠️ 较重 |
| 现代化程度 | ✅ 全新设计 | ⚠️ 传统架构 |
| 开发语言 | Rust | C++/QML |
| 学习曲线 | ✅ 简洁直观 | ⚠️ 功能复杂 |
## 总结
COSMIC 桌面环境代表了 Linux 桌面发展的新方向。通过采用现代编程语言、模块化设计和先进的安全特性,它为用户提供了一个稳定、安全且高度可定制的桌面体验。
### 主要优势
- **🔒 安全性**:Rust 语言带来的内存安全保障
- **⚡ 性能**:现代化的架构和优化设计
- **🎨 美观性**:Material Design 风格的现代界面
- **🔧 可定制性**:丰富的个性化选项
- **👥 开发者友好**:统一的开发体验
### 发展前景
随着 Pop!_OS 24.04 的正式发布和社区的持续贡献,我们有理由相信 COSMIC 将在 Linux 桌面环境中占据重要地位。它不仅展现了技术创新的力量,更为整个 Linux 桌面生态系统的发展指明了方向。
对于寻求创新桌面体验的 Linux 用户来说,COSMIC 无疑是一个值得期待的全新选择。它将 Rust 的安全特性、Wayland 的现代架构和用户友好的设计完美结合,为 Linux 桌面环境开启了新的篇章。
---
**参考资料**:
- [System76 COSMIC 官方页面](https://system76.com/cosmic)
- [Pop!_OS 24.04 发布公告](https://pop.system76.com/)
- [COSMIC GitHub 仓库](https://github.com/pop-os/cosmic-epoch)
---
# Tunnl.gg:零配置内网穿透服务 - 快速暴露本地服务到公网
- Canonical: https://www.zeroxin.xin/2025/12/15/tunnl-gg-introduction/
- Markdown: https://www.zeroxin.xin/2025/12/15/tunnl-gg-introduction.md
- Published: 2025-12-15T10:30:00+08:00
- Updated: 2026-06-18T17:21:22+08:00
- Language: zh-CN
- Tags: 安全测试, 网络技术, 开发工具, Web开发, 部署工具
Tunnl.gg是一个基于SSH的零配置内网穿透服务,无需安装任何软件即可将本地Web服务快速暴露到公网。本文介绍其工作原理、一条SSH命令启动服务的便捷使用方式、适用场景以及与ngrok等传统内网穿透工具的对比优势,为开发者提供最简洁高效的内网穿透解决方案
## 引言
在现代Web开发中,开发者经常需要将本地开发环境暴露给外部网络,用于测试、演示或协作。传统的内网穿透工具往往需要复杂的配置、安装过程,甚至需要付费订阅。**Tunnl.gg** 作为一个新兴的内网穿透服务,以其"零配置、零安装、即时可用"的特性,正在重新定义开发者的工作流程。
## 项目概述
### 什么是Tunnl.gg?
Tunnl.gg是一个基于SSH的内网穿透服务,它允许开发者通过简单的SSH命令将本地Web服务器暴露到公网,获得一个可访问的公共URL。这个服务的最大特点是:
- **无需安装**:不需要在本地安装任何软件
- **零配置**:无需复杂的配置文件或设置
- **即时可用**:一条SSH命令即可启动服务
- **自动HTTPS**:所有连接都自动提供TLS加密
- **无需注册**:随机子域名无需注册即可使用
### 核心优势
#### 1. 极简使用体验
Tunnl.gg的设计哲学是"简单至上"。开发者只需要执行一条SSH命令:
```bash
ssh -t -R 80:localhost:8080 proxy.tunnl.gg
```
这条命令就能将本地8080端口的服务通过SSH反向隧道暴露到公网,获得一个随机的公共URL。
#### 2. 安全可靠
- **自动HTTPS**:所有连接都自动提供TLS终止,确保数据传输安全
- **SSH加密**:基于SSH协议的加密通道,提供端到端的安全保障
- **临时访问**:随机子域名提供临时访问,不会长期暴露敏感服务
#### 3. 开发友好
- **零配置**:无需修改应用代码或配置文件
- **即时反馈**:启动后立即可用,无需等待
- **跨平台**:只要有SSH客户端,就能在任何平台上使用
## 技术原理
### SSH反向隧道技术
Tunnl.gg的核心技术基于SSH的反向隧道(Reverse Tunnel)功能。反向隧道允许将远程服务器的端口映射到本地机器的端口。
工作原理:
1. 客户端通过SSH连接到Tunnl.gg的代理服务器
2. 建立反向隧道,将本地端口映射到代理服务器的端口
3. 代理服务器为这个连接分配一个随机子域名
4. 外部用户通过这个子域名访问本地服务
### 架构设计
```
[本地开发服务器] ←→ [SSH反向隧道] ←→ [Tunnl.gg代理服务器] ←→ [公网用户]
(8080端口) (随机子域名)
```
## 使用场景
### 1. 本地开发测试
在开发Web应用时,经常需要在真实环境中测试功能。使用Tunnl.gg,可以快速将本地开发服务器暴露给测试人员或合作伙伴。
```bash
# 暴露本地的React开发服务器
ssh -t -R 80:localhost:3000 proxy.tunnl.gg
# 暴露本地的Node.js服务器
ssh -t -R 80:localhost:8080 proxy.tunnl.gg
# 暴露本地的Python Flask应用
ssh -t -R 80:localhost:5000 proxy.tunnl.gg
```
### 2. API调试与集成
在开发API时,第三方服务可能需要回调你的本地环境。Tunnl.gg提供了一个稳定的公网URL,方便进行Webhook测试和API集成。
### 3. 远程演示与协作
向客户或团队成员展示项目进展时,无需部署到生产环境,直接通过Tunnl.gg分享本地开发中的功能。
### 4. 移动端测试
在移动应用开发中,经常需要测试与后端API的交互。通过Tunnl.gg,可以将本地API服务暴露给移动设备使用。
## 常见问题解答
### Q: Tunnl.gg是否免费?
A: Tunnl.gg提供免费的基础服务,包括随机子域名和基本的隧道功能。对于需要自定义域名或高级功能的用户,可能需要付费订阅。
### Q: 有哪些使用限制?
A: 免费服务通常会有以下限制:
- 带宽限制
- 并发连接数限制
- 随机子域名的可用性
- 会话时长限制
### Q: 可以使用自定义域名吗?
A: 是的,Tunnl.gg支持自定义域名功能,但可能需要付费订阅或特殊配置。
### Q: 安全性如何?
A: Tunnl.gg采用多重安全措施:
- SSH加密通道
- 自动TLS/SSL证书
- 流量加密传输
- 临时访问控制
## 与其他工具对比
### vs Ngrok
| 特性 | Tunnl.gg | Ngrok |
|------|----------|-------|
| 安装要求 | 无需安装 | 需要下载客户端 |
| 配置复杂度 | 零配置 | 需要配置文件 |
| SSH支持 | 原生支持 | 需要额外配置 |
| 免费计划 | 有 | 有限制 |
| 自定义域名 | 支持 | 付费功能 |
### vs Localhost.run
| 特性 | Tunnl.gg | Localhost.run |
|------|----------|---------------|
| 协议支持 | SSH | SSH/HTTP |
| 安全性 | 高 | 中等 |
| 稳定性 | 高 | 一般 |
| 功能丰富度 | 适中 | 丰富 |
## 最佳实践
### 1. 安全使用建议
- 避免暴露敏感数据或管理接口
- 使用完毕后及时关闭隧道连接
- 定期检查访问日志
- 考虑使用防火墙限制访问
### 2. 性能优化
- 选择合适的本地端口
- 避免同时开启过多隧道
- 监控带宽使用情况
- 考虑使用压缩减少传输量
### 3. 开发集成
可以将Tunnl.gg集成到开发工作流中:
```bash
# package.json中的脚本
{
"scripts": {
"dev": "next dev",
"share": "ssh -t -R 80:localhost:3000 proxy.tunnl.gg"
}
}
```
## 总结
Tunnl.gg以其极简的设计理念和强大的功能,为开发者提供了一个高效、安全的内网穿透解决方案。无论是日常开发、测试协作,还是远程演示,Tunnl.gg都能显著提升工作效率。
**核心价值**:
- ✅ 零配置、零安装
- ✅ 即时可用
- ✅ 自动HTTPS
- ✅ SSH加密
- ✅ 开发友好
对于追求效率和简洁的开发者来说,Tunnl.gg无疑是一个值得尝试的工具。它不仅简化了内网穿透的复杂性,更为现代Web开发工作流注入了新的活力。
## 参考资料
- [Tunnl.gg官方网站](https://tunnl.gg/)
- [Tunnl.gg文档](https://tunnl.gg/docs)
- [SSH反向隧道技术文档](https://www.ssh.com/academy/ssh/tunneling/example)
- [Hacker News讨论](https://news.ycombinator.com/item?id=46145902)
---
# 深度解析KYC认证原理:数字时代的身份验证基石
- Canonical: https://www.zeroxin.xin/2025/12/04/kyc-authentication-principles/
- Markdown: https://www.zeroxin.xin/2025/12/04/kyc-authentication-principles.md
- Published: 2025-12-04T00:00:00+08:00
- Updated: 2026-07-13T22:34:18+08:00
- Language: zh-CN
- Tags: 安全测试, 认证, 数字身份, 合规, 金融科技
深入解析KYC(了解你的客户)认证的技术原理与实现机制,涵盖用户身份验证流程、风险评估模型、反洗钱合规要求以及在金融科技、区块链和数字生态系统中的实际应用场景,帮助开发者全面理解构建安全身份验证系统的核心要点与最佳实践经验
## 引言
在数字化浪潮席卷全球的今天,身份验证已成为金融科技、电子商务、区块链等领域的核心环节。KYC(Know Your Customer,了解你的客户)作为现代身份验证体系的重要组成部分,不仅关乎企业的合规要求,更是保障用户资产安全的重要屏障。本文将深入探讨KYC认证的技术原理、实现机制以及在现代数字生态中的应用。
## KYC认证的核心概念
### 什么是KYC?
KYC(Know Your Customer)是一种身份验证和尽职调查流程,旨在验证客户的真实身份,评估潜在风险,并确保符合反洗钱(AML)和反欺诈法规要求。KYC不仅是法律合规的要求,更是构建可信数字生态系统的基础。
### KYC的核心目标
1. **身份验证**:确认用户提供的身份信息真实有效
2. **风险评估**:根据用户信息评估潜在风险等级
3. **合规保障**:满足监管机构的法律法规要求
4. **欺诈预防**:识别和阻止恶意用户的注册和行为
5. **信任建立**:在用户和服务提供商之间建立信任关系
## KYC认证的技术原理
### 1. 身份文档验证
#### OCR文字识别技术
光学字符识别(OCR)是KYC系统的核心技术之一。通过OCR技术,系统可以自动提取身份证、护照、驾驶证等证件上的文字信息。
```python
# 简化的OCR身份证识别示例
import pytesseract
from PIL import Image
def extract_id_info(image_path):
"""
从身份证图片中提取关键信息
"""
image = Image.open(image_path)
# 使用Tesseract OCR提取文字
text = pytesseract.image_to_string(image, lang='chi_sim+eng')
# 解析身份证号码
id_pattern = r'[1-9]\d{5}(18|19|20)\d{2}(0[1-9]|1[0-2])(0[1-9]|[12]\d|3[01])\d{3}[\dXx]'
id_number = re.search(id_pattern, text)
# 解析姓名
name_pattern = r'姓名[::]\s*([^\s]+)'
name_match = re.search(name_pattern, text)
return {
'name': name_match.group(1) if name_match else None,
'id_number': id_number.group(0) if id_number else None
}
```
#### 证件真伪检测
现代KYC系统不仅识别证件信息,还要验证证件的真伪性:
1. **防伪特征检测**:检测水印、安全线、荧光反应等防伪元素
2. **图像质量分析**:通过图像清晰度、色彩饱和度等指标判断证件状态
3. **格式验证**:检查证件格式是否符合官方标准
### 2. 人脸识别与活体检测
#### 人脸识别技术
人脸识别是KYC认证的关键环节,通过比对用户自拍照片与证件照片来确认身份。
```python
# 人脸识别比对示例
import face_recognition
import cv2
def compare_faces(photo1_path, photo2_path, threshold=0.6):
"""
比对两张照片中的人脸相似度
"""
# 加载图片
image1 = face_recognition.load_image_file(photo1_path)
image2 = face_recognition.load_image_file(photo2_path)
# 检测人脸位置
face_locations1 = face_recognition.face_locations(image1)
face_locations2 = face_recognition.face_locations(image2)
if not face_locations1 or not face_locations2:
return False, "未检测到人脸"
# 提取人脸特征
face_encodings1 = face_recognition.face_encodings(image1, face_locations1)
face_encodings2 = face_recognition.face_encodings(image2, face_locations2)
# 计算相似度
face_distance = face_recognition.face_distance(
face_encodings1[0], face_encodings2[0]
)
similarity = 1 - face_distance
is_match = similarity < threshold
return is_match, similarity
```
#### 活体检测技术
活体检测是防止使用照片、视频等静态图像进行欺诈的重要技术:
1. **眨眼检测**:要求用户进行眨眼动作
2. **头部转动**:检测用户头部的自然转动
3. **随机动作**:要求用户执行随机的面部动作
4. **3D深度检测**:通过3D摄像头检测真实的三维人脸
### 3. 生物特征识别
#### 指纹识别
指纹识别是最成熟的生物特征识别技术之一:
```python
# 指纹识别示例
from fingerprint import FingerprintMatcher
def verify_fingerprint(template_path, input_path):
"""
验证指纹匹配
"""
matcher = FingerprintMatcher()
# 加载指纹模板
template = matcher.load_template(template_path)
# 提取输入指纹特征
input_features = matcher.extract_features(input_path)
# 计算匹配分数
match_score = matcher.match(template, input_features)
return match_score > 0.8 # 阈值判断
```
#### 声纹识别
声纹识别通过分析用户的声音特征进行身份验证:
1. **声音特征提取**:提取MFCC、频谱等声音特征
2. **动态时间规整**:处理不同语速和语调的变化
3. **模型训练**:使用机器学习算法训练声纹模型
### 4. 区块链与去中心化身份
#### DID(去中心化身份)
去中心化身份(DID)是基于区块链技术的新型身份验证方案:
```solidity
// 简化的DID合约示例
pragma solidity ^0.8.0;
contract DIDRegistry {
struct DIDDocument {
address owner;
string publicKey;
uint256 created;
bool active;
}
mapping(string => DIDDocument) public dids;
function registerDID(string memory did, string memory publicKey) public {
require(!dids[did].active, "DID already exists");
dids[did] = DIDDocument({
owner: msg.sender,
publicKey: publicKey,
created: block.timestamp,
active: true
});
}
function verifyDID(string memory did) public view returns (bool) {
return dids[did].active && dids[did].owner == msg.sender;
}
}
```
#### 零知识证明
零知识证明允许用户在不泄露敏感信息的情况下证明身份:
```python
# 简化的零知识证明示例
class ZKPAgeProof:
def __init__(self, age_threshold=18):
self.age_threshold = age_threshold
def generate_proof(self, actual_age, secret_key):
"""
生成年龄证明(不泄露实际年龄)
"""
# 生成随机挑战
challenge = hashlib.sha256(str(secret_key).encode()).digest()
# 生成证明
proof = {
'commitment': self.commit_to_age(actual_age, secret_key),
'challenge': challenge.hex(),
'response': self.generate_response(actual_age, secret_key, challenge)
}
return proof
def verify_proof(self, proof):
"""
验证年龄证明
"""
# 验证证明的有效性
return self.check_age_threshold(proof['commitment'], proof['response'])
```
## KYC认证的实现架构
### 1. 多层次验证体系
现代KYC系统通常采用多层次验证策略:
#### 第一层:基础信息验证
- 身份证件信息提取和验证
- 基本信息格式检查
- 重复注册检测
#### 第二层:生物特征验证
- 人脸识别比对
- 活体检测
- 指纹或声纹验证
#### 第三层:行为分析验证
- 设备指纹识别
- 操作行为模式分析
- 风险评分模型
### 2. 风险评估模型
#### 风险评分算法
```python
# 风险评分模型示例
import numpy as np
from sklearn.ensemble import RandomForestClassifier
class KYCRiskAssessment:
def __init__(self):
self.model = RandomForestClassifier(n_estimators=100)
self.feature_weights = {
'document_quality': 0.25,
'face_similarity': 0.30,
'device_trust': 0.15,
'behavior_score': 0.20,
'network_risk': 0.10
}
def calculate_risk_score(self, features):
"""
计算综合风险评分
"""
risk_score = 0
for feature, weight in self.feature_weights.items():
if feature in features:
risk_score += features[feature] * weight
# 转换为0-100的风险等级
return min(100, max(0, risk_score * 100))
def classify_risk_level(self, score):
"""
风险等级分类
"""
if score < 30:
return "低风险"
elif score < 60:
return "中风险"
elif score < 80:
return "高风险"
else:
return "极高风险"
```
### 3. 数据安全与隐私保护
#### 数据加密技术
```python
# 敏感数据加密示例
from cryptography.fernet import Fernet
import hashlib
class SecureDataHandler:
def __init__(self):
self.key = Fernet.generate_key()
self.cipher = Fernet(self.key)
def encrypt_pii(self, data):
"""
加密个人身份信息
"""
# 数据脱敏
masked_data = self.mask_sensitive_data(data)
# 加密处理
encrypted_data = self.cipher.encrypt(masked_data.encode())
return encrypted_data
def mask_sensitive_data(self, data):
"""
数据脱敏处理
"""
if 'id_number' in data:
id_num = data['id_number']
masked_id = id_num[:6] + '*' * (len(id_num) - 10) + id_num[-4:]
data['id_number'] = masked_id
if 'phone' in data:
phone = data['phone']
masked_phone = phone[:3] + '*' * 4 + phone[-4:]
data['phone'] = masked_phone
return data
```
## KYC在不同行业的应用
### 1. 金融科技
在金融科技领域,KYC是监管合规的核心要求:
- **数字银行**:远程开户身份验证
- **支付平台**:用户身份确认和反洗钱
- **借贷平台**:借款人资质评估
- **加密货币交易所**:数字资产交易合规
### 2. 电子商务
电商平台的KYC应用:
- **商家入驻**:验证商家身份和经营资质
- **高价值交易**:大额订单的身份确认
- **跨境电商**:国际交易的身份验证
### 3. 区块链与DeFi
去中心化金融中的KYC挑战:
- **隐私保护**:在去中心化环境中保护用户隐私
- **跨链验证**:多链环境下的身份统一
- **智能合约集成**:将KYC验证集成到DeFi协议中
## KYC技术的发展趋势
### 1. 人工智能增强
- **深度学习**:提升证件识别和人脸识别的准确率
- **异常检测**:通过AI算法识别欺诈行为
- **自动化决策**:减少人工审核的工作量
### 2. 隐私计算技术
- **联邦学习**:在不共享原始数据的情况下训练模型
- **同态加密**:在加密状态下进行计算
- **安全多方计算**:多方协作进行身份验证
### 3. 标准化与互操作性
- **全球统一标准**:建立国际通用的KYC标准
- **跨平台验证**:实现不同平台间的身份互认
- **API标准化**:提供统一的KYC服务接口
## 挑战与解决方案
### 1. 技术挑战
#### 准确性与效率的平衡
- **问题**:提高验证准确率往往需要更复杂的算法,影响处理速度
- **解决方案**:采用分层验证策略,平衡准确性和效率
#### 跨地域适应性
- **问题**:不同国家和地区的证件格式、验证标准差异很大
- **解决方案**:建立全球化的验证规则库,支持本地化配置
### 2. 合规挑战
#### 监管要求变化
- **问题**:各国监管政策不断变化,难以保持合规
- **解决方案**:建立灵活的合规框架,快速适应政策变化
#### 数据跨境传输
- **问题**:不同国家的数据保护法规限制数据跨境传输
- **解决方案**:采用数据本地化存储和边缘计算技术
### 3. 用户体验挑战
#### 验证流程复杂性
- **问题**:严格的验证流程可能影响用户体验
- **解决方案**:优化用户界面,提供清晰的验证指导
#### 移动端适配
- **问题**:移动设备上的身份验证体验需要优化
- **解决方案**:开发移动端专用的验证SDK和界面
## 最佳实践建议
### 1. 技术实施建议
1. **采用模块化架构**:便于系统维护和功能扩展
2. **实施多重验证**:结合多种验证技术提高安全性
3. **建立监控体系**:实时监控验证过程和结果
4. **定期更新模型**:根据新数据和威胁更新验证模型
### 2. 合规管理建议
1. **建立合规团队**:专门负责监管政策跟踪和合规管理
2. **制定应急预案**:应对监管政策变化的快速响应机制
3. **定期合规审计**:确保系统持续符合监管要求
4. **员工培训**:提高团队对合规要求的理解和执行能力
### 3. 用户体验优化
1. **简化验证流程**:减少不必要的验证步骤
2. **提供清晰指导**:帮助用户完成验证过程
3. **支持多语言**:适应不同地区用户的需求
4. **优化移动体验**:确保移动端验证的便捷性
## 结语
KYC认证作为数字时代身份验证的基石,其技术原理和实现方式正在不断演进。从传统的文档验证到现代的生物特征识别,从中心化验证到去中心化身份,KYC技术正在向着更安全、更便捷、更隐私保护的方向发展。
在数字化浪潮中,掌握KYC认证的核心原理和最佳实践,不仅是企业合规经营的需要,更是构建可信数字生态系统的关键。随着技术的不断进步和监管环境的日益完善,KYC认证将继续在保障数字经济健康发展方面发挥重要作用。
理解和应用KYC认证原理,将帮助我们在享受数字技术便利的同时,确保个人隐私和资产安全,实现技术发展与合规要求的完美平衡。
---
# How KYC Verification Works: The Foundation of Digital Identity
- Canonical: https://www.zeroxin.xin/en/kyc-authentication-principles/
- Markdown: https://www.zeroxin.xin/en/kyc-authentication-principles.md
- Published: 2025-12-04T00:00:00+08:00
- Updated: 2026-07-13T22:32:40+08:00
- Language: en
- Categories: Security
- Tags: Authentication, Security, Digital Identity, Compliance, Fintech
A deep dive into the technical principles and implementation of KYC (Know Your Customer) verification, covering identity verification workflows, risk assessment models, anti-money-laundering compliance, and real-world ap
## Introduction
As digitalization sweeps the globe, identity verification has become a core component of fintech, e-commerce, blockchain, and more. KYC (Know Your Customer), a key part of modern identity systems, is not only a compliance requirement for businesses but also an essential safeguard for user assets. This article explores the technical principles, implementation mechanisms, and applications of KYC in today's digital ecosystem.
## Core Concepts of KYC
### What Is KYC?
KYC (Know Your Customer) is an identity verification and due-diligence process designed to confirm a customer's real identity, assess potential risk, and ensure compliance with anti-money-laundering (AML) and anti-fraud regulations. KYC is not just a legal requirement — it is the foundation of a trustworthy digital ecosystem.
### The Core Goals of KYC
1. **Identity verification**: confirm that the identity information provided is genuine and valid
2. **Risk assessment**: evaluate the potential risk level based on user information
3. **Compliance**: meet the legal and regulatory requirements of authorities
4. **Fraud prevention**: identify and block malicious registrations and behavior
5. **Trust building**: establish trust between users and service providers
## Technical Principles of KYC
### 1. Identity Document Verification
#### OCR Text Recognition
Optical Character Recognition (OCR) is one of the core technologies in a KYC system. Through OCR, the system can automatically extract text from ID cards, passports, driver's licenses, and other documents.
```python
# Simplified OCR ID card extraction example
import pytesseract
from PIL import Image
def extract_id_info(image_path):
"""
Extract key information from an ID card image
"""
image = Image.open(image_path)
# Extract text with Tesseract OCR
text = pytesseract.image_to_string(image, lang='chi_sim+eng')
# Parse ID number
id_pattern = r'[1-9]\d{5}(18|19|20)\d{2}(0[1-9]|1[0-2])(0[1-9]|[12]\d|3[01])\d{3}[\dXx]'
id_number = re.search(id_pattern, text)
# Parse name
name_pattern = r'Name[::]\s*([^\s]+)'
name_match = re.search(name_pattern, text)
return {
'name': name_match.group(1) if name_match else None,
'id_number': id_number.group(0) if id_number else None
}
```
#### Document Authenticity Detection
Modern KYC systems not only read document information but also verify its authenticity:
1. **Anti-counterfeit feature detection**: detecting watermarks, security threads, fluorescent responses, and other security elements
2. **Image quality analysis**: judging document condition through metrics such as sharpness and color saturation
3. **Format validation**: checking whether the document matches official standards
### 2. Face Recognition and Liveness Detection
#### Face Recognition
Face recognition is a key step in KYC, confirming identity by comparing the user's selfie with the document photo.
```python
# Face comparison example
import face_recognition
import cv2
def compare_faces(photo1_path, photo2_path, threshold=0.6):
"""
Compare the face similarity between two photos
"""
# Load images
image1 = face_recognition.load_image_file(photo1_path)
image2 = face_recognition.load_image_file(photo2_path)
# Detect face locations
face_locations1 = face_recognition.face_locations(image1)
face_locations2 = face_recognition.face_locations(image2)
if not face_locations1 or not face_locations2:
return False, "No face detected"
# Extract facial features
face_encodings1 = face_recognition.face_encodings(image1, face_locations1)
face_encodings2 = face_recognition.face_encodings(image2, face_locations2)
# Compute similarity
face_distance = face_recognition.face_distance(
face_encodings1[0], face_encodings2[0]
)
similarity = 1 - face_distance
is_match = similarity < threshold
return is_match, similarity
```
#### Liveness Detection
Liveness detection is essential to prevent fraud using static images such as photos or videos:
1. **Blink detection**: asking the user to blink
2. **Head movement**: detecting natural head rotation
3. **Random actions**: asking the user to perform random facial movements
4. **3D depth detection**: detecting a real three-dimensional face with a 3D camera
### 3. Biometric Recognition
#### Fingerprint Recognition
Fingerprint recognition is one of the most mature biometric technologies:
```python
# Fingerprint verification example
from fingerprint import FingerprintMatcher
def verify_fingerprint(template_path, input_path):
"""
Verify a fingerprint match
"""
matcher = FingerprintMatcher()
# Load fingerprint template
template = matcher.load_template(template_path)
# Extract features from the input fingerprint
input_features = matcher.extract_features(input_path)
# Compute match score
match_score = matcher.match(template, input_features)
return match_score > 0.8 # threshold check
```
#### Voiceprint Recognition
Voiceprint recognition verifies identity by analyzing a user's vocal characteristics:
1. **Voice feature extraction**: extracting MFCC, spectral, and other features
2. **Dynamic time warping**: handling variations in speaking speed and intonation
3. **Model training**: training a voiceprint model with machine learning
### 4. Blockchain and Decentralized Identity
#### DID (Decentralized Identity)
Decentralized Identity (DID) is a new identity verification scheme based on blockchain:
```solidity
// Simplified DID contract example
pragma solidity ^0.8.0;
contract DIDRegistry {
struct DIDDocument {
address owner;
string publicKey;
uint256 created;
bool active;
}
mapping(string => DIDDocument) public dids;
function registerDID(string memory did, string memory publicKey) public {
require(!dids[did].active, "DID already exists");
dids[did] = DIDDocument({
owner: msg.sender,
publicKey: publicKey,
created: block.timestamp,
active: true
});
}
function verifyDID(string memory did) public view returns (bool) {
return dids[did].active && dids[did].owner == msg.sender;
}
}
```
#### Zero-Knowledge Proofs
Zero-knowledge proofs let a user prove their identity without revealing sensitive information:
```python
# Simplified zero-knowledge proof example
class ZKPAgeProof:
def __init__(self, age_threshold=18):
self.age_threshold = age_threshold
def generate_proof(self, actual_age, secret_key):
"""
Generate an age proof (without revealing the actual age)
"""
# Generate a random challenge
challenge = hashlib.sha256(str(secret_key).encode()).digest()
# Generate the proof
proof = {
'commitment': self.commit_to_age(actual_age, secret_key),
'challenge': challenge.hex(),
'response': self.generate_response(actual_age, secret_key, challenge)
}
return proof
def verify_proof(self, proof):
"""
Verify the age proof
"""
# Verify the validity of the proof
return self.check_age_threshold(proof['commitment'], proof['response'])
```
## KYC Implementation Architecture
### 1. Multi-Layered Verification
Modern KYC systems usually adopt a multi-layered strategy:
#### Layer 1: Basic Information Verification
- ID document extraction and verification
- Basic information format checks
- Duplicate registration detection
#### Layer 2: Biometric Verification
- Face recognition comparison
- Liveness detection
- Fingerprint or voiceprint verification
#### Layer 3: Behavioral Analysis
- Device fingerprinting
- Operational behavior pattern analysis
- Risk scoring model
### 2. Risk Assessment Model
#### Risk Scoring Algorithm
```python
# Risk scoring model example
import numpy as np
from sklearn.ensemble import RandomForestClassifier
class KYCRiskAssessment:
def __init__(self):
self.model = RandomForestClassifier(n_estimators=100)
self.feature_weights = {
'document_quality': 0.25,
'face_similarity': 0.30,
'device_trust': 0.15,
'behavior_score': 0.20,
'network_risk': 0.10
}
def calculate_risk_score(self, features):
"""
Calculate the composite risk score
"""
risk_score = 0
for feature, weight in self.feature_weights.items():
if feature in features:
risk_score += features[feature] * weight
# Convert to a 0-100 risk level
return min(100, max(0, risk_score * 100))
def classify_risk_level(self, score):
"""
Classify the risk level
"""
if score < 30:
return "Low risk"
elif score < 60:
return "Medium risk"
elif score < 80:
return "High risk"
else:
return "Very high risk"
```
### 3. Data Security and Privacy Protection
#### Data Encryption
```python
# Sensitive data encryption example
from cryptography.fernet import Fernet
import hashlib
class SecureDataHandler:
def __init__(self):
self.key = Fernet.generate_key()
self.cipher = Fernet(self.key)
def encrypt_pii(self, data):
"""
Encrypt personally identifiable information
"""
# Data masking
masked_data = self.mask_sensitive_data(data)
# Encryption
encrypted_data = self.cipher.encrypt(masked_data.encode())
return encrypted_data
def mask_sensitive_data(self, data):
"""
Data masking
"""
if 'id_number' in data:
id_num = data['id_number']
masked_id = id_num[:6] + '*' * (len(id_num) - 10) + id_num[-4:]
data['id_number'] = masked_id
if 'phone' in data:
phone = data['phone']
masked_phone = phone[:3] + '*' * 4 + phone[-4:]
data['phone'] = masked_phone
return data
```
## KYC Applications Across Industries
### 1. Fintech
In fintech, KYC is a core regulatory requirement:
- **Digital banking**: remote account-opening identity verification
- **Payment platforms**: user identity confirmation and anti-money-laundering
- **Lending platforms**: borrower eligibility assessment
- **Crypto exchanges**: compliance for digital asset trading
### 2. E-commerce
KYC in e-commerce platforms:
- **Merchant onboarding**: verifying merchant identity and business qualifications
- **High-value transactions**: identity confirmation for large orders
- **Cross-border e-commerce**: identity verification for international transactions
### 3. Blockchain and DeFi
KYC challenges in decentralized finance:
- **Privacy protection**: protecting user privacy in a decentralized environment
- **Cross-chain verification**: unified identity across multiple chains
- **Smart contract integration**: integrating KYC verification into DeFi protocols
## Trends in KYC Technology
### 1. AI Enhancement
- **Deep learning**: improving the accuracy of document and face recognition
- **Anomaly detection**: identifying fraud through AI algorithms
- **Automated decisions**: reducing manual review workload
### 2. Privacy-Preserving Computation
- **Federated learning**: training models without sharing raw data
- **Homomorphic encryption**: computing on encrypted data
- **Secure multi-party computation**: collaborative verification across parties
### 3. Standardization and Interoperability
- **Global unified standards**: establishing internationally common KYC standards
- **Cross-platform verification**: mutual identity recognition across platforms
- **API standardization**: providing a unified KYC service interface
## Challenges and Solutions
### 1. Technical Challenges
#### Balancing Accuracy and Efficiency
- **Problem**: higher verification accuracy often requires more complex algorithms, affecting speed
- **Solution**: adopt a layered verification strategy to balance accuracy and efficiency
#### Cross-Regional Adaptability
- **Problem**: document formats and verification standards vary widely across countries and regions
- **Solution**: build a global rule library that supports localized configuration
### 2. Compliance Challenges
#### Changing Regulatory Requirements
- **Problem**: regulatory policies change constantly, making compliance hard to maintain
- **Solution**: build a flexible compliance framework that adapts quickly
#### Cross-Border Data Transfer
- **Problem**: data protection laws in different countries restrict cross-border transfer
- **Solution**: use data localization storage and edge computing
### 3. User Experience Challenges
#### Verification Complexity
- **Problem**: strict verification flows can hurt user experience
- **Solution**: optimize the UI and provide clear guidance
#### Mobile Adaptation
- **Problem**: identity verification on mobile devices needs optimization
- **Solution**: develop mobile-specific verification SDKs and interfaces
## Best Practices
### 1. Technical Implementation
1. **Use a modular architecture**: for easier maintenance and extension
2. **Apply multi-factor verification**: combine multiple techniques for stronger security
3. **Build a monitoring system**: monitor verification processes and results in real time
4. **Update models regularly**: refresh models based on new data and threats
### 2. Compliance Management
1. **Set up a compliance team**: dedicated to tracking policy and managing compliance
2. **Prepare contingency plans**: rapid response to regulatory changes
3. **Conduct regular audits**: ensure the system stays compliant
4. **Train staff**: improve the team's understanding and execution of requirements
### 3. User Experience Optimization
1. **Simplify the flow**: remove unnecessary verification steps
2. **Provide clear guidance**: help users complete verification
3. **Support multiple languages**: adapt to users in different regions
4. **Optimize mobile experience**: ensure convenient verification on mobile
## Conclusion
As the foundation of digital-era identity verification, KYC's technical principles and implementation are constantly evolving. From traditional document checks to modern biometrics, from centralized verification to decentralized identity, KYC is moving toward greater security, convenience, and privacy protection.
In the wave of digitalization, mastering the core principles and best practices of KYC is not only necessary for compliant operations but also key to building a trustworthy digital ecosystem. As technology advances and regulation matures, KYC will continue to play a vital role in the healthy growth of the digital economy.
Understanding and applying KYC principles helps us enjoy the convenience of digital technology while safeguarding personal privacy and assets — striking a perfect balance between technological progress and compliance.
---
# DNS Benchmark Tool:专业的DNS性能测试工具
- Canonical: https://www.zeroxin.xin/2025/11/30/DNS-Benchmark-Tool%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D/
- Markdown: https://www.zeroxin.xin/2025/11/30/DNS-Benchmark-Tool%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D.md
- Published: 2025-11-30T10:30:00+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, 网络工具, DNS, 性能测试, Python
DNS-Benchmark-Tool是一款专业的DNS性能基准测试工具,支持对国内外主流DNS服务器进行延迟、丢包率、查询速度等多维度评测。本文介绍其测试原理、使用方法、结果解读以及在网络优化和DNS选型中的实际应用价值
## 项目概述
**DNS Benchmark Tool** 是由开发者 [frankovo](https://github.com/frankovo) 创建的一个专业的DNS性能测试工具。该项目旨在帮助用户快速、全面地测试DNS解析器的性能,支持DNSSEC验证、DoH/DoT等现代DNS安全特性,并提供企业级的功能特性。
### 项目亮点
- **GitHub地址**: [frankovo/dns-benchmark-tool](https://github.com/frankovo/dns-benchmark-tool)
- **当前版本**: v0.3.3
- **编程语言**: Python (97.5%)
- **许可证**: MIT License
- **社区活跃度**: 257个GitHub星标,5个分支,活跃开发中
## 核心功能特性
### 🚀 性能测试能力
- **异步查询**: 支持同时测试100+个DNS解析器
- **多轮测试**: 运行多轮基准测试以确保结果准确性
- **统计分析**: 提供均值、中位数、P95、P99、抖动、稳定性等详细统计
- **缓存控制**: 支持有/无DNS缓存的测试模式
- **高并发**: 支持大规模并发查询测试
### 🔒 安全与隐私特性
- **DNSSEC验证**: 内置DNSSEC信任链验证
- **DNS-over-HTTPS (DoH)**: 支持加密DNS基准测试
- **DNS-over-TLS (DoT)**: 安全传输测试
- **DNS-over-QUIC (DoQ)**: 实验性QUIC支持
### 📊 分析与导出功能
- **多格式输出**: CSV、Excel、PDF、JSON格式
- **可视化报告**: 图表和图形分析
- **域名统计**: 按域名的性能分析
- **错误分析**: 识别有问题的解析器
- **详细报告**: 包含执行摘要和技术深度分析
### 🏢 企业级功能
- **TSIG认证**: 安全的企业查询
- **区域传输**: AXFR/IXFR验证
- **动态更新**: 测试DNS写入操作
- **合规报告**: 审计就绪的文档
### 🌐 跨平台支持
- **多操作系统**: Linux、macOS、Windows全平台支持
- **CI/CD友好**: JSON输出、退出代码支持
- **IDNA支持**: 国际化域名支持
- **自动检测**: Windows WMI DNS发现
## 快速开始
### 安装方法
```bash
# 从PyPI安装
pip install dns-benchmark-tool
# 安装包含PDF支持的版本
pip install dns-benchmark-tool[pdf]
# 从源码安装
git clone https://github.com/frankovo/dns-benchmark-tool.git
cd dns-benchmark-tool
pip install -e .
```
### 基本使用
```bash
# 使用默认设置进行基准测试
dns-benchmark benchmark --use-defaults --formats csv,excel
# 快速排名解析器
dns-benchmark top
# 比较特定解析器
dns-benchmark compare Cloudflare Google Quad9
# 持续监控
dns-benchmark monitoring --use-defaults --interval 30 --duration 3600
```
## 实际应用场景
### 🔧 开发者:优化API性能
```bash
# 为API端点找到最快的DNS
dns-benchmark benchmark \
--domains api.myapp.com,cdn.myapp.com \
--record-types A,AAAA \
--resolvers production.json \
--iterations 10
```
### 🛡️ DevOps/SRE:迁移前验证
```bash
# 在切换前测试新的DNS提供商
dns-benchmark benchmark \
--resolvers current-dns.json,new-dns.json \
--use-defaults \
--output migration-report/ \
--formats csv,excel
```
### 🏠 自建用户:验证Pi-hole性能
```bash
# 比较Pi-hole与公共解析器
dns-benchmark compare \
--resolvers pihole.local,1.1.1.1,8.8.8.8,9.9.9.9 \
--domains common-sites.txt \
--rounds 10
```
### 📊 网络管理员:自动化健康检查
```bash
# 添加到crontab进行月度报告
0 0 1 * * dns-benchmark benchmark \
--use-defaults \
--output /var/reports/dns/ \
--formats excel,csv \
--domain-stats \
--error-breakdown
```
## 高级功能
### CLI命令详解
#### 🚀 Top命令 - 快速排名
```bash
# 基本排名(按延迟)
dns-benchmark top
# 限制显示数量
dns-benchmark top --limit 5
# 按成功率排名
dns-benchmark top --metric success
# 按可靠性排名
dns-benchmark top --metric reliability
# 按类别过滤
dns-benchmark top --category privacy
```
#### 📊 Compare命令 - 并排比较
```bash
# 比较指定解析器
dns-benchmark compare Cloudflare Google Quad9
# 显示详细域名分析
dns-benchmark compare Cloudflare Google --show-details
# 自定义域名列表
dns-benchmark compare Cloudflare Google -d ./domains.txt
```
#### 🔄 Monitoring命令 - 持续监控
```bash
# 持续监控默认解析器
dns-benchmark monitoring --use-defaults
# 自定义监控间隔和持续时间
dns-benchmark monitoring --use-defaults --interval 30 --duration 3600
# 设置告警阈值
dns-benchmark monitoring --use-defaults \
--alert-latency 150 --alert-failure-rate 5
```
### 配置管理
#### 解析器JSON格式
```json
{
"resolvers": [
{
"name": "Cloudflare",
"ip": "1.1.1.1",
"ipv6": "2606:4700:4700::1111"
},
{
"name": "Google DNS",
"ip": "8.8.8.8",
"ipv6": "2001:4860:4860::8888"
}
]
}
```
#### 域名列表格式
```
# 流行网站
google.com
github.com
stackoverflow.com
# 企业域名
microsoft.com
apple.com
amazon.com
# CDN和云服务
cloudflare.com
aws.amazon.com
```
## 输出格式详解
### CSV输出
- 原始数据:带时间戳和元数据的单个查询结果
- 汇总统计:每个解析器的聚合指标
- 域名统计:按域名的指标(使用--domain-stats时)
- 记录类型统计:按记录类型的指标(使用--record-type-stats时)
- 错误分析:按错误类型的计数(使用--error-breakdown时)
### Excel报告
- 原始数据表:所有查询结果及格式
- 解析器汇总:带条件格式的综合统计
- 域名统计:按域名性能(可选)
- 记录类型统计:按记录类型性能(可选)
- 错误分析:聚合错误计数(可选)
- 性能分析:图表和比较分析
### PDF报告
- 执行摘要:关键发现和建议
- 性能图表:延迟比较;可选的成功率图表
- 解析器排名:按平均延迟排序
- 详细分析:带百分位的技术深度分析
## 性能优化建议
### 快速运行
```bash
dns-benchmark benchmark --iterations 1 --timeout 1 --retries 0 --warmup-fast
```
适用于:快速反馈,最小重试,轻量级预热。适合快速检查。
### 彻底测试
```bash
dns-benchmark benchmark --iterations 3 --use-cache --warmup --timeout 5 --retries 2
```
适用于:多次运行,启用缓存,完全预热。适合详细基准测试。
### 调试模式
```bash
dns-benchmark benchmark --iterations 1 --timeout 10 --retries 0 --quiet
```
适用于:长超时,无重试,最小输出。适合诊断解析器问题。
### 平衡运行
```bash
dns-benchmark benchmark --iterations 2 --use-cache --warmup-fast --timeout 2 --retries 1
```
适用于:中等速度,一些重试,启用缓存,快速预热。平衡速度和准确性。
## 自动化与CI/CD
### Cron作业示例
```bash
# 每日监控
0 2 * * * /usr/local/bin/dns-benchmark benchmark --use-defaults --formats csv --quiet --output /var/log/dns_benchmark/daily_$(date +\%Y\%m\%d)
# 时间变化测试(每6小时)
0 */6 * * * /usr/local/bin/dns-benchmark benchmark --use-defaults --formats csv --quiet --output /var/log/dns_benchmark/$(date +\%Y\%m\%d_\%H)
```
### GitHub Actions集成
```yaml
- name: DNS Performance Test
run: |
pip install dns-benchmark-tool
dns-benchmark benchmark \
--resolvers "1.1.1.1,8.8.8.8" \
--domains "api.service.com,database.service.com" \
--formats csv \
--quiet
```
## 社区与反馈
### 社区亮点
- **星标增长**: 从7个增长到110+个,在Hacker News上发布后
- **下载量**: 最初停滞后反弹到200+/天
- **社区反馈**: HN社区的建设性意见直接影响了v0.3.0 → v0.3.1的补丁
### 反馈机制
项目提供智能反馈提示:
- 在第5次、第15次和第30次基准测试运行后出现
- 提示之间有24小时冷却时间
- 只有在尚未提供反馈时才显示
### 隐私保护
- 所有数据存储在本地机器上
- 无遥测或跟踪
- 无自动数据传输
- 反馈状态存储在 `~/.dns-benchmark/feedback.json`
## 未来发展路线图
### ✅ 当前版本(CLI版)
- 跨域和记录类型的DNS解析器基准测试
- 导出到CSV、Excel、PDF、JSON
- 统计分析(P95、P99、抖动、稳定性)
- 自动化支持(CI/CD、cron)
### 🚧 托管版本(2026年Q1)
CLI版本永久免费。托管版本增加:
- 🌍 多区域测试(美国、欧盟、亚洲、自定义)
- 📊 历史跟踪,带图表和趋势
- 🚨 告警(电子邮件、Slack、PagerDuty、webhooks)
- 👥 团队协作和分享
- 📈 SLA合规报告
- 🔌 API访问和集成
### 🔜 更多网络工具(2026年Q1-Q2)
作为BuildTools - 网络性能套件的一部分:
- 🔍 HTTP/HTTPS基准测试 - 测试API端点和CDN
- 🔒 SSL证书监控 - 永不错过续期
- 📡 正常运行时间监控 - 24/7可用性跟踪
- 🌐 API健康仪表板 - 完整的网络可观测性
## 项目统计
- **下载量**: 本周1,400+次下载
- **活跃用户**: 600+
- **贡献者**: 2名主要贡献者
- **语言分布**: Python 97.5%, Makefile 2.5%
- **发布版本**: 21个标签版本
## 总结
DNS Benchmark Tool是一个功能强大、文档完善的DNS性能测试工具,适合各种规模的用户使用。无论是开发者优化API性能、DevOps团队验证迁移方案,还是网络管理员进行合规检查,这个工具都能提供专业、准确的DNS性能分析。
其跨平台支持、丰富的输出格式、自动化集成能力,以及活跃的社区支持,使其成为DNS性能测试领域的优秀选择。随着托管版本的即将推出,该项目将继续为用户提供更全面的网络性能解决方案。
---
*该项目是[BuildTools](https://buildtools.net/) - 网络性能套件的一部分,致力于为用户提供全面的网络性能测试和监控解决方案。*
**项目地址**: [https://github.com/frankovo/dns-benchmark-tool](https://github.com/frankovo/dns-benchmark-tool)
**PyPI地址**: [https://pypi.org/project/dns-benchmark-tool/](https://pypi.org/project/dns-benchmark-tool/)
---
# 中国电信/中国联通/中国移动 国际互联全解析
- Canonical: https://www.zeroxin.xin/2025/11/25/china-isps-international-interconnection-analysis/
- Markdown: https://www.zeroxin.xin/2025/11/25/china-isps-international-interconnection-analysis.md
- Published: 2025-11-25T12:00:00+08:00
- Updated: 2026-06-18T17:21:27+08:00
- Language: zh-CN
- Categories: 网络技术
- Tags: 网络技术, 国际互联, BGP, 电信, 联通, 移动
深入解析中国三大运营商(电信、联通、移动)的国际互联架构,包括C-I-X-F四段骨干网划分、跨境数据安全网关部署机制、网间互联路由策略及BGP协议在中国国际出口中的应用原理与现实挑战,帮助网络从业者全面理解中国互联网基础设施的运行机制
> 本文转载自 [Misaka 博客](https://misaka.si/posts/12ctcucm/)。原文采用 CC BY-NC-SA 4.0 协议进行许可。
## 前置知识
由于国内政策和网络安全要求,中国国内运营商在处理公网跨境流量时对骨干设备进行了分类,一般包括 **C-I-X-F** 四段:
- **C 段**:中国大陆国内段(核心路由器)
- **I 段**:跨境段(国际出口路由器)
- **X 段**:运营商海外互联中继(国际网间互联路由)
- **F 段**:与海外其他运营商的互联路由(海外 POP 点)
一般而言,**C-I 段部署在国内,I-X-F 段则依据对端互联运营商所在地有所差异**。国家跨境数据安全网关部署在 C-I 段中间,三大运营商此段容量也因为安全设备容量原因而有所限制。
### 关于带宽成本
由于国内目前的销售策略(商宽补贴家宽等情况),商业用途的带宽比起家庭用户要昂贵许多。大家可能习惯了 99 元月付的千兆家宽,然而国内动态 BGP 带宽(仅国内穿透,不包括国际穿透)的价格就能达到至少 **100 CNY/Mbps/月**。这点在国际互联的带宽费用上也有所体现。
中国主流的三大运营商拥有超过数亿的用户群体,对于这样庞大的 Eyeball 网络,尤其是中国大陆这样的封闭市场,**用户群即是他们的核心竞争力和要价资本**(这一点可以参考中国移动近几年的宽带白送抢占客户群的操作)。因此对于服务商而言,越是想低延迟、高质量服务这类网络下的用户,所需要付出的成本越高。
### 地域与价格的反直觉关系
与许多人的直觉相反,在实际的报价和互联处理上,**离中国大陆越近,延迟越低,带宽互联越昂贵**。香港地区是三家运营商所需要的互联费用最高的地区,其次是日本、新加坡、韩国,然后是俄罗斯,最后是欧美地区。
至于原因,在中国大陆提供公开的互联网信息服务(例如传统网站服务)存在多样的问题,除了政策层面的需要提供 ICP 备案接入以外,对于非 BGP 接入的机房,**2024 年 7 月开始的网内跨省流量结算以及 PCDN 的打击和跨网调度应对**,导致情况愈加复杂。
在这样的策略影响下,因为成本等方面的原因没有在亚太地区购买三家运营商直连线路的服务提供商,将不得不通过 Tier 1 Transit 来将他们的流量传输至国内。而 Tier 1 Transit 的带宽也是有限的。例如,NTT 在亚太地区和中国电信 163 的互联仅有 **60G**(NTT 曾试图联系电信扩容但价格过于昂贵)。
而多数亚太的服务商(例如 Vultr/Linode/DO)由于 BGP 路径选择,默认情况下会优先这类网络,因此原本狭小的互联只会更加拥塞。而电信是没有意愿主动扩容的:**如果流量都走 Tier 1,那么作为他们营收的主要部分,付费互联(Paid Peer)就没法达到预定收益**。
基于这个原因,从逻辑互联来说,对于大多数服务提供商,**香港虽然是离大陆最近的地区,但却不一定是国内访问最快的地区**。
### 常见的海外访问问题
从网络拓扑来说,在中国大陆常见的遇到的海外访问问题包括:
#### 非三大运营商直连客户
- **经过 Tier 1 Transit**(比如 NTT、GTT、Level 3):由于运营商-Transit Provider 之间的容量原因以及普通网络跨境段(C-I)容量限制出现的高延迟、丢包和低速率
- 典型场景:电信-日本 NTT 长期高度拥塞导致的丢包和延迟上升,众多开源软件的源服务器(Ubuntu PPA/Debian Mirror 等)至国内低速率下载
- **非优化流量绕路**:例如新加坡 Singtel 至中国电信对非优化流量通过其他 Tier 1(i.e. AS6453 TATA)绕路美国导致高延迟
#### 三大运营商直连客户
- **普通网络跨境段(C-I)容量限制**出现的丢包问题
- 典型场景:国内电信访问微软国际版服务(比如 Office 365、OneDrive);Cloudflare 至中国电信用户的速率问题
- **商家或者提供商由于带宽没买够**跑爆了或者有 QoS 问题导致的速度问题
- 典型场景:腾讯云香港普通网络
---
## 中国电信
中国电信目前维护三张网络:
- **AS4134 ChinaNet (163)**
- **AS4809 ChinaNet Next Generation Carrier Network (CN2)**
- **AS23764 CTGNet**
### ChinaNet (163)
ChinaNet(a.k.a. 163),主要城市如 LAX、SJC、FRA、LON,**回国带宽大,但因电信超卖严重,因此尖峰时段较容易阻塞**,同时也常有来自中国境内的流量攻击将出口塞满。价格较低。
截至 2020 年 8 月,163 网国内至国际互联段(C-I 段)**容量拥塞**,因此访问国外一些服务商会出现严重的慢速、丢包、高延迟等现象。
**扩容历史:**
- **2021 年**:按照集团规划,163 国际出口国内段扩容预计在 2021 年 2 月底之前完成
- **2021 年 3-4 月**:中国电信和中国移动对 163 和 CMNet 的国际出口进行了扩容,据信总带宽约 1.2 Tbps 左右,国际段拥塞情况相对之前已缓解不少,但广州和上海出口的部分路由仍然存在丢包情况
- **2022 年 9 月**:163 国际出口扩容大约 1T 左右
- **2023 年 11 月**:电信于 8 月 15 日发布《中国电信 2022 年 ChinaNet 国际网络(国内段)流量综合管理系统扩容工程集成服务询价结果公示》,根据观察近期(12 月初)国际出口已有比较明显的好转。根据业界大佬的消息,中国电信此次广州出口扩容 1.8 Tbps
**价格信息:**
- **北美 163**:单价大约为 $0.6/Mbps
- **日本/新加坡**:单价为 ≤$20/Mbps
- **香港**:丧心病狂的 $50+/Mbps(2020 年左右的 IPT 合约价格)
需要说明的是,电信的标准付费互联并**不带任何质量保证,全是 Best Effort**。
如果是跨境段(C-I)高保障 QoS 的 163(质量参照上海电信家宽国际精品网,或者世纪互联版 Azure),香港地区的 IPT 单价则超过 **$75**,几乎快接近 CN2 GIA 的底线价格。
> 注:上述价格都是 commit 量比较大的情况下的折扣价格,一般在 8 折左右(甚至可以更低),因此实际在 commit 量少的情况下价格会更高
### CN2 GT (Global Transit)
CN2 GT,163 与 CN2 POP 之间统一在上海、广州、北京三个互连点,北京互连点为一年内所新增。由于两张网流量交换前也会经过 163 的汇聚点,因此也较容易因 163 汇聚点有大量攻击流量导致阻塞,同时因攻击塞满两张网之间的互连也时常发生。
对于跨境互联质量,电信官网承认 **CN2 GT 与 ChinaNet 质量无异**。换句话说就是,CN2 GT 集成了电信两张网各自最烂的部分:CN2 海外的骨干质量和 163 出口的跨境段质量。
欧美地区的 CN2 GT 或将在接下来规划下线,现有 CN2 GT 的客户(已知的包括 QuadraNet AS8100、俄罗斯 DataLine 等)将被切换至 163。但正如前文所述,在跨境质量上 CN2 GT 和 163 因为是共享 C-I 段,因此在质量上并不会有差别或者变化。
### CN2 GIA (Global Internet Access)
GIA 与 GT 之间所经过的跨境互联段不同(即 C-I 段),其中 **GIA 有单独的 C-I 段容量,而 GT 则与 163 共享 C-I 段**。因此基于目前的跨境互联质量而言,CN2 GT 和 163 几乎没有差异,但 GIA 与 GT/163 则会有明显体验上的差异。
该产品在 163 与 CN2 两张网之间互连有独立的端口进行互连,互连点也较多,采就近接入原则,但实际延迟不一定比较好。且因互连点不同关系,实际上有可能会出现某地至北美 GT 走上海出口,但 GIA 却走广东出口等等差异。另互连端口在有大量攻击时容易阻塞,特别是南京、北京互连点。
**价格与额度限制:**
- 电信报价依据所在地与中国大陆之间的延迟决定,延迟越高价格越低
- **北美**:大约 $6 USD/Mbps(目前可能已涨价)
- **香港**:单价最高则达到了 **$100 USD/Mbps**,底线价格也有接近 $80
- **2022 年 3 月**:CN2 的跨境段容量峰值使用率已超过 90%+,电信集团目前已经暂停了部分方向新接的 CN2 GIA 的订单(除非有释放的带宽资源)
**产品变化:**
- 与 AS4809 直接互联的 CN2 GIA 产品在亚太和欧洲地区已经下线,目前新接客户需要通过 CTGNet
### CTGNet (AS23764)
由于通过 CTG/CTA/CTE 购买 GIA 带宽需要中国电信集团级别审批合约,因此 CTG 自己搞了个 CTGNet(自卖自销系列)。据大佬介绍,CTGNet 订购的带宽合约目前暂不需要集团审批。
**发展趋势:**
- 在今年年底某个时间点以后新开的合约都需要走 CTGNet 签订
- 电信正在将已有的 AS4809 客户迁移到 CTGNet
- 亚太地区比如香港和新加坡已经迁移不少客户,包括阿里云香港、腾讯等
- 今后新开的大部分 CN2 合同都会变成 CTGNet 的合同
**产品特性:**
CTGNet 包含了之前的 163/CN2 GT 和 CN2 GIA 的接入,区别是根据合约报价来决定最终互联的质量:**钱给的多就给你 GIA,钱给的少那就是 GT 甚至 163**。
目前亚太和欧洲(除俄罗斯以外),原有的 CN2 AS4809 的客户大部分已经迁移至 CTGNet 下。
**网络识别:**
CTGNet 常见的骨干网 IP 开头为 **69.194** 和 **203.22**,均在 AS23764 下。
与过去直接和 AS4809 接入的 CN2 GIA 对比,从腾讯云新加坡订购的 CTGNet 的路由来看,除了中间多出来 CTGNet 的 2-3 跳左右路由以外,和之前 CN2 GIA 的路由看起来没多少差别了。但是 CTGNet 网内偶尔会出现莫名其妙的延迟增加情况,体现在香港地区 CTGNet 网内两跳路由之间延迟增加 15-20 ms,这个问题属于偶发。
> p.s. 中国电信澳门的 4G/5G 用户在访问中国内地的资源时,流量会通过 CTGNet 走 CN2 GIA 至国内
---
## 中国联通
中国联通目前有 3 个主要 ASN:
- **AS4837**:中国联通骨干网
- **AS10099**:中国联通国际(CUG)
- **AS9929**:中国联通工业互联网(CUII,以前的老网通的骨干,简称 A 网)
### 网络架构
一般家宽客户接入的是 **4837 网络**,与电信 4134 类似。国际出口分为北京、上海、广州三部分。比较常见的路由如下:
- **北京出口**:承载多数省份的跨境流量,包含日韩北美欧洲俄罗斯等地区
- **上海出口**:承载至东亚/东南亚以及北美圣何塞的跨境流量
- **广州出口**:承载至港澳/东南亚/北美(洛杉矶)/欧洲部分地区的流量
### 流量工程
联通对其上游宣告的 IP 段有一定倾向性调整(这实际上也是流量工程和 QoS 的一部分)。例如,对于部分 IP 段,联通在日本发给 NTT 的路由 prepend 了 AS PATH,造成的情况就是对于同时接了 NTT 和其他网络的服务商(比如甲骨文东京接了 NTT 和 TATA),由于 AS PATH 长度问题:
- 至联通部分 IP 段(例如 153.3.16.1)走 NTT 经由上海/北京互联回程
- 部分 IP 段(例如 27.11.128.1)则被送去了其他网络,出现绕美/高延迟的情况
这一点在联通至新加坡 Cogent 的互联也能看出来(部分段走新加坡的 Cogent 直接回到联通网内,部分则绕欧至联通与 Cogent 的欧洲互联)。
### CUG (AS10099)
**10099(CUG)与电信目前的 CTGNet 类似**,提供至大陆方向的差异化接入,包括:
- **CUG**(10099->4837)
- **CUG VIP**(10099->9929->4837)
其中,**CUVIP 属于 4837 上的优质服务**,与 9929 (CUII) 是不同的体系。
### CUII (AS9929)
9929 为老网通骨干网,现在的 CUII。其本身负载低,所以被用于为政企提供高质量网络访问。但是缺点在于:
- 这张网的跨境互联端点对比 4837 较少
- 多数互联的容量并不大
- 现在作为联通对标 CN2 GIA 的产品销售
### 价格信息
- **普通 4837**:报价依据互联地区不同而不同
- 日本/新加坡:可以做到 ≤$20/Mbps(但还是贵而且和电信一样是 Best Effort)
- 香港:比日本/新加坡略高一些,≤$25/Mbps
- 欧洲地区:≤$5/Mbps
- **香港 10099 CN Premium Route**(官方名称,实际上就是 9929):报价一般不低于 **$55/Mbps**
---
## 中国移动
> CMCC 这张几乎万物都要走香港出口,而且骨干都能疯狂丢包,广州到香港之间延迟能暴涨 114514 ms 的破网有什么记录的必要吗(半恼)
自己拉了根线测一下免得有人 BB,不过还是得说一句:**请不要用广东移动的质量假设其他省份移动的质量**。
### 出口分布
自 2022 年初开始,随着上海临港出口启用,在日韩购买了 CMI IP Transit 的 ISP/IDC 回到国内部分省份移动的流量会经由上海出口承载,延迟对比绕广东会有所降低(比如日本/韩国-上海 ~33 ms)。
移动近期扩容加上上海临港出口启用以后在跨境段(C-I 段)上容量有明显富余,部分方向也开始塞了,加上移动祖传负载不均衡,所以体验会有所波动。
目前的主要出口还是广州-香港段,IPv6 跨境流量路由大部分会出现绕行上海的情况(即使你处在广东)。
### 价格信息
- **亚太地区**(指香港/日本/新加坡)中国移动的 IPT 价格比较一致,约 **$30/Mbps**(2023 年至 2024 年 5 月)
- **中国移动 CMPremium** 的价格一般在 **$55-$60/Mbps** 左右(取决于 commit 的量)
### 质量问题
由于近期大批量的 CMI 带大陆路由的 IPT 开通,移动至联通/电信的晚高峰跨网质量相对之前明显有所降低。移动广州出口自 4 月开始已可见晚高峰时期网内有丢包情况出现,且有明显的负载不均衡的情况。
对来自 Free Peer(比如 PCCW/NTT/Telstra)至国内的流量会有 QoS,在量大的情况下,移动会根据来源流量的 ASN 进行 QoS,尖峰时可见在 P2P 跳路由(比如 NTT-移动的互联路由节点)开始出现高于 80% 的丢包。
**为什么市面上常见"移动优化线路"?**
正因为此类 QoS 策略,目前市面上常见的"移动优化线路"多数为通过 Lumen(f.a.k.a. Level 3, AS3356)所传输回移动。相对目前 C-I 直接 IPT 的价格,Lumen-CMI 的价格低了一个数量级,但什么时候会被移动橄榄仍是未知数。这类操作的前车之鉴是 NTT/PCCW,后者在早一两年前基本全被移动橄榄。(2024.9)
目前在亚太地区到移动有速度的 Tier 1 Transit 目前就剩下 **Lumen** 和最近移动在日本和新加坡新接的 **TATA(AS6453)** 了,通过这两个地区的这两家 Tier 1 至移动网内目前较少遇到限速或 QoS 拉黑的问题。PCCWG 依然比较灵车。
### CMI 流量处理
- **从 IX 强行从 CMI 送流量至国内网络**会被移动 QoS 至不超过 1 Mbps 的速度以及高强度丢包,但是某些情况下仍存在偷带宽的可能性
### CMI 穿透路由
- **CMI 日本地区**(2024.5):现在不提供至电信和联通的穿透,因为容量不够了
- **CMI 日本 POP**(最新):开始恢复提供至国内电信联通的回国方向流量穿透,根据 CMI 方面的说法,CMI Paid IPT 客户可以申请日本地区 CMI 回程国内电信联通的穿透路由
- **新加坡和香港**:也提供三网回国方向流量穿透
但是由于友商投诉和移动网内策略,所有经由 CMI 回程至电信联通方向的流量会通过上海出口处理,因此即使你在广东电信,流量还是得至少单向绕上海一圈。
### 跨境容量警告
**2024 年 11 月**:中国移动香港至国内方向跨境带宽利用率已达到 95%,由于跨境段容量拥塞问题移动目前对跨境流量存在高峰期 QoS 的情况,部分省份即便是访问购买了正价 CMI 带宽的用户也会遇到严重限速情况(晚高峰 10 Mbps 至 100 Mbps 均可见)。根据监控数据目前晚高峰时期 CMI 至国内方向可见大约 **5% 左右的丢包**。移动侧答复扩容需等待工信部批准,其他容量规划暂无更新。
**2024 年 11 月底**:由于 NCP 海缆故障影响中国移动至日本和北美方向链路(包括公网和专线传输),目前流量故障转移至经由香港返回国内。
### CMI N2 (AS58807)
和电信一样,移动也在搞 CMI N2(AS58807),此网络海外回程路由至国内电信部分会走 CTGNet。
**产品定位**:依据购买的产品类型,CMIN2 的挂牌单价为 **$45–55+/Mbps**(亚太地区),并且不同等级的产品有不同比例的回国带宽限制。例如,对于 Premium DIA 产品,部分地区至 CT/CU 方向至多允许 30% 的比例(即,如果你购买了 1 Gbps 的 Premium DIA,最多有 300 Mbps 的带宽可以用来传输至电信或者联通)。
**设计与部署**:CMI N2 的设计计划是独立的网络,与 CN2 GIA/CUII 9929 类似。但是目前从已购买的产品来看,CMIN2 目前只有海外段是在 AS58807 之下。例如从新加坡 CMIN2 至国内的流量会在新加坡-香港走 CMIN2,而到达香港之后走到 AS58453 的核心再路由至国内 9808。
**最新进展**(2023.11):N2 北美地区已上线,提供了到国内三网 IPv4 和 IPv6 双栈优化。根据多个商家和实际测试的结果来看,CMI N2 至电信联通甚至移动本网都还存在一定的缺路由的情况,表现为接了 N2 的网络回程至国内部分网络仍需绕行其他 transit。
---
## CTGNet (AS23764) / CUG (AS10099) 和 CMI (AS58453) 三张网的差异性
三家运营商目前都有趋势将国际客户的 IPT 业务转移至自身的国际网络下,但是三家的国际网络资源略有差异。
### 电信与联通
对于电信和联通,**CTGNet 和 CUG 提供的包括对客户的 IPT 接入以及差异化产品**:
- **普通 IPT**:CTGNet 给到 163,而 10099 给到 4837
- **精品 IPT(Premium IP Transit)**:CTGNet 给到的是原有的 CN2 GIA 产品,CUG 给到的则是联通 A 网 9929
这一点也可以从现有路由能看出来。
此外,CTGNet 和 CUG 也为两家运营商在海外的移动客户提供网络接入(例如 CUniq 回国主要走 4837,而 CTMO/CTexcel 则走 CTGNet/163)。两张网络同时也用于对应的国内 CN2/9929 精品网客户就近访问海外资源。
> 需要注意的是,CTGNet 和 CUG **目前并不接管两家运营商的全部出海流量**
### 中国移动
而对于移动,**AS58453 CMI 则是国内移动 AS9808 客户公网跨境的几乎唯一方向**,并且移动的海外精品网访问接入是由 AS58807 来负责的。与电信 CTGNet 和联通 CUG 的角色上有较大的区别。
### 2024 年政策变化
**2024.07**:中国电信国内 4134 大网于 7 月份开始停止接收来自联通方面的国际客户路由(即来自 10099 及其客户的路由)。此举导致原有通过只拉 CUG 便能做到联通电信都能直连的操作成为了不可能。除极少数路由以外,**4134-4837-10099** 和 **4134-9929-10099** 的走法成为了过去式,现在必须购买电信的互联才能使得国内电信流量去程拉直。
**2024.08**:联通也开始对等操作,拒收了来自电信 CTG 和 CN2 国际客户的路由。
**影响范围**:这次双方的"竞合"操作实际影响的还有双方香港的移动运营商业务(CUniq/CTHK)。由于双方国内拒收去程路由,中国电信香港(CTHK)访问国内联通网络,或者 CUniq 访问国内电信网络时,国内-香港方向的去程路由会绕行欧美,导致延迟大增。为什么不说移动呢,因为移动去 CTHK 的流量甚至会喜提绕南非环球游,而且电联不待见移动是早就已知的事情了。
---
## 一些题外话 / 小道消息
- **CN2 变成 CTGNet** 的一部分原因是,在 2020 年左右,北美的部分 CN2 GT/GIA 双持的客户,通过在 GIA 的端口上宣告 IP 段,回程走 CN2 GT 端口的方式,可以使得回程流量变为 CN2 GIA。这是因为电信 CN2 网内区分走 GT 和 GIA 路由的方式是根据 4809 收到的路由端口和类型决定的。当时这么做的商家包括 C3(Zenlayer)、Hostspace、Krypt(iON),因此这些商家后面看到的 ICMP CN2 GT 而 TCP/UDP 走 163 也是电信故意而为之
- **CTGNet 可能部分接管了 CN2 的跨境段**,目前可以观测到 CTGNet 的部分骨干 IP 出现在了国内部分。大佬的推测是可能在 CN2 的骨干上再跑了个 MPLS
- **CN2 (AS4809) 到 PCCW 的互联可能会被拔线**,转由经 CTGNet 至 PCCW,后者拥有 100G 互联
- **CUG 10099 在 HKIX 的端口曾被长时间"偷流量"**,即通过强制指定下一跳路由的形式,将国内流量经由 CUG 的路由器送至联通骨干再到国内。目前已有 QoS
- **CMI 有一位非常不负责任的销售**,只会推产品而不认真处理客户问题
- **CMI 对于没有购买其 IPT 业务但是通过其上游(比如 PCCW/NTT)送流量进来的网络**,在流量较大(数百 Mbps)的时候会触发 QoS。销售会先联系你让你购买 CMI 的 IPT 带宽业务,但如果你不买,你可能会被移动拉进黑名单(按 ASN),此时在互联点会出现严重丢包
---
## 许可证
本文原文采用 [CC BY-NC-SA 4.0](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.zh) 进行许可。转载请标注原作者和原文链接。
**原文链接**:https://misaka.si/posts/12ctcucm/
**原文作者**:Misaka
---
# Operit AI - Android端功能完备的智能助手应用
- Canonical: https://www.zeroxin.xin/2025/11/23/operit-ai-android-intelligent-assistant/
- Markdown: https://www.zeroxin.xin/2025/11/23/operit-ai-android-intelligent-assistant.md
- Published: 2025-11-23T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: 开源项目, Android, AI工具, 智能助手
Operit AI是Android端首个功能完备的开源AI智能助手应用,支持工具调用、深度搜索、智能记忆库和人设定制。本文介绍其核心功能、内置Ubuntu 24环境、角色卡系统以及如何将Android权限与AI能力深度融合,打造移动端的智能助手新范式
## 🌟 项目简介
Operit AI 是移动端首个功能完备的 AI 智能助手应用,完全独立运行于您的 Android 设备上(除API调用),拥有强大的工具调用能力、深度搜索、智能记忆库,并支持人设定制与角色卡等高度自定义功能。它不仅仅是聊天界面,更是与Android权限和各种工具深度融合的全能助手,内置Ubuntu 24 环境,提供前所未有的强大功能。
---
## ⚡ 核心亮点
### 🖥️ Ubuntu 24 环境
内置完整 Ubuntu 24 系统,支持 vim、MCP、Python等工具,在手机上运行复杂的Linux命令和自动化任务
### 🧠 智能记忆系统
AI自动分类管理记忆,智能搜索历史对话,记住您的偏好和习惯,提供个性化服务
### 🗣️ 语音交互
连续自然对话,支持本地/云端TTS,自定义音色,语音球悬浮窗随时唤醒
### 🤖 本地模型支持
支持MNN本地模型运行,保护隐私的同时提供流畅的AI体验
### 🎭 人设与角色卡系统
支持自定义人设和PNG角色卡导入,让AI助手更具个性化
## 🛠️ 功能速览
### 📦 内置工具系统
- **Web开发**: 在手机上设计网页并导出为独立应用
- **终端工具**: 完整的Ubuntu 24环境,支持复杂命令操作
- **MCP协议支持**: 丰富的插件生态系统
- **OCR识别**: 图片文字提取功能
- **悬浮窗工具**: 随时调用,便捷分享
### 🎨 界面定制
- **主题选择器**: 多种UI主题可选
- **自定义界面**: 个性化您的AI助手
- **DragonBones动画**: 流畅的动画效果
### 🔗 集成能力
- **Shizuku/Root集成**: 深度系统权限管理
- **Tasker集成**: 自动化工作流程
- **多模型支持**: OpenAI、Claude、Gemini等主流AI模型
## 📸 功能展示

Web开发
在手机上设计网页并导出为独立应用
|

悬浮窗 & 附件
随时调用,便捷分享
|

插件市场
丰富的MCP生态
|
---
## 🚀 快速开始
### 📋 系统要求
- Android 8.0+ (API 26+)
- 建议 4GB+ 内存
- 200MB+ 存储空间
### 📥 下载安装
1. 访问 [Release页面](https://github.com/AAswordman/Operit/releases) 下载最新APK
2. 或从 [官方网站](https://aaswordman.github.io/OperitWeb/) 获取安装包
> ⚠️ **安全提示**:为确保您的数据安全,请务必从官方Release页面或官方网站下载本应用。通过未知渠道下载的安装包可能被恶意修改,从而导致隐私泄露或设备被监听。
### 📖 使用指南
- 完整文档包含详细教程和示例
- 安装步骤:下载APK → 安装启动 → 按引导配置 → 开始使用 ✨
## 📅 版本更新历程
| 版本 | 发布日期 | 核心更新 |
|---|---|---|
| v1.6.2 最新 | 2025-11-22 | • 最新优化和bug修复 |
| v1.6.0 | 2025-10-21 | • MNN本地模型支持 • 记忆库大更新:AI自动分类、智能搜索、导入导出 • 终端优化:vim支持、进度条、自定义软件源 • Tasker集成、桌宠功能、故事线标签 |
| v1.5.2 | 2025-10-05 | • MCP增强:uvx/npx支持、启动加速 • 工作区Git ignore、语法检查 • 相机拍照、HTML渲染、正则过滤 |
| v1.5.0 | 2025-09 | • Ubuntu 24终端完整集成 • MCP市场上线 • 桌宠功能、深度搜索模式 |
| v1.4.0 | 2025-08 | • 多工具并行执行 • 人设卡系统、角色选择器 • PNG角色卡导入 |
| v1.3.0 | 2025-08 | • Web开发功能 • 主题选择器、自定义UI • Anthropic Claude支持 |
| v1.2.x | 2025-07 | • 语音对话系统 • 知识库功能 • DragonBones动画支持 |
| v1.1.x | 2025-06 | • MCP协议支持 • OCR识别、悬浮窗 • Gemini完整支持 |
| v1.0.0 | 2025-05 | • 首个正式版本 • 基础AI对话、工具调用 • Shizuku/Root集成 |
📝 完整更新日志:访问 [Releases 页面](https://github.com/AAswordman/Operit/releases) 查看每个版本的详细更新内容
## 👨💻 开源共创
Operit AI 是一个开源项目,欢迎加入 Operit 开源生态!我们欢迎各种贡献:第三方脚本、MCP插件、核心功能开发。
### 开发者须知
- 📚 [开源共创指南](https://github.com/AAswordman/Operit/blob/main/docs/CONTRIBUTING.md)
- 📦 [脚本开发指南](https://github.com/AAswordman/Operit/blob/main/docs/SCRIPT_DEV_GUIDE.md)
- 📦 构建项目需从 [Google Drive](https://drive.google.com/drive/folders/1g-Q_i7cf6Ua4KX9ZM6V282EEZvTVVfF7?usp=sharing) 下载依赖库
- 💬 加入社区讨论:[QQ群](https://qm.qq.com/q/Sa4fKEH7sO) | [Discord](https://discord.gg/YnV9MWurRF)
### 💖 贡献者
感谢所有为 Operit AI 做出贡献的开发者!项目目前已有8位贡献者,包括:
- [@AAswordman](https://github.com/AAswordman) - 项目创始人
- [@yizhen47](https://github.com/yizhen47)
- [@zhufengning](https://github.com/zhufengning)
- [@oopupdeep](https://github.com/oopupdeep)
- [@logos000](https://github.com/logos000)
- [@h4rm00n](https://github.com/h4rm00n)
- [@W1NDes](https://github.com/W1NDes)
- [@google-labs-jules[bot]](https://github.com/apps/google-labs-jules)
## 📄 许可证
本项目采用 [GNU LGPLv3](https://www.gnu.org/licenses/lgpl-3.0.html) 许可证。
简单来说,这意味着:
- 您可以自由地使用、修改和分发本项目的代码
- 如果您修改了代码并进行分发,您也必须以 LGPLv3 许可证开源您修改过的部分
- 详细信息请参阅 [LICENSE](https://github.com/AAswordman/Operit/blob/main/LICENSE) 文件
## 📝 问题反馈
遇到问题或有建议?欢迎 [提交 Issue](https://github.com/AAswordman/Operit/issues)!
提交指南:
- 📝 清晰描述问题/建议,提供复现步骤
- 📱 附上设备型号、系统版本等信息
- 📸 如有可能,提供截图或录屏
## 🌟 项目亮点总结
Operit AI 作为Android端目前能力最为完备的AI Agent,具有以下独特优势:
1. **完全独立运行**:除API调用外,所有功能均在本地运行
2. **强大的工具调用能力**:内置Ubuntu 24环境,支持复杂命令操作
3. **智能记忆系统**:AI自动分类管理,提供个性化服务
4. **丰富的自定义选项**:人设、角色卡、主题等多维度定制
5. **活跃的开源社区**:持续更新,功能不断迭代
6. **多模型支持**:兼容主流AI服务,灵活选择
## 🔗 相关链接
- **GitHub仓库**:https://github.com/AAswordman/Operit
- **官方网站**:https://aaswordman.github.io/OperitWeb/
- **下载页面**:https://github.com/AAswordman/Operit/releases
- **文档中心**:包含详细教程和API文档
- **社区讨论**:QQ群 | Discord
---
### ⭐ 如果觉得项目不错,请给项目一个 Star ⭐
🚀 帮助推广,让更多人了解 Operit AI 🚀
Made with ❤️ by the Operit Team
---
# LinuxMirrors.cn:一键更换Linux系统软件源的利器
- Canonical: https://www.zeroxin.xin/2025/11/20/LinuxMirrors-cn%EF%BC%9A%E4%B8%80%E9%94%AE%E6%9B%B4%E6%8D%A2Linux%E7%B3%BB%E7%BB%9F%E8%BD%AF%E4%BB%B6%E6%BA%90%E7%9A%84%E5%88%A9%E5%99%A8/
- Markdown: https://www.zeroxin.xin/2025/11/20/LinuxMirrors-cn%EF%BC%9A%E4%B8%80%E9%94%AE%E6%9B%B4%E6%8D%A2Linux%E7%B3%BB%E7%BB%9F%E8%BD%AF%E4%BB%B6%E6%BA%90%E7%9A%84%E5%88%A9%E5%99%A8.md
- Published: 2025-11-20T22:45:34+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Tags: 开源项目, Linux, 系统工具, 软件源
LinuxMirrors-cn是一个专为中国用户设计的Linux系统软件源一键更换工具,支持Ubuntu、Debian、CentOS、Arch等主流发行版。本文介绍其核心功能、支持的镜像站列表、自动化配置脚本以及如何通过更换国内镜像源大幅提升软件包下载速度和系统更新效率
在日常使用 Linux 系统的过程中,软件源的选择对系统更新速度和稳定性有着直接影响。尤其是对于国内用户,使用官方源往往下载速度缓慢,而手动更换软件源又需要一定的技术知识。今天要介绍的 [LinuxMirrors.cn](https://linuxmirrors.cn/) 项目,正是为了解决这一痛点而生的优秀开源工具。
## 项目概述
LinuxMirrors.cn 是一个专为 GNU/Linux 系统设计的一键更换软件源脚本项目,同时也提供了 Docker 安装与换源功能。该项目由 SuperManito 开发并维护,已获得 GitHub 上超过 6.4k 的 Star,充分说明了其在 Linux 社区中的受欢迎程度。

## 核心特点
### 1. 零技术门槛,一键执行
使用 LinuxMirrors.cn 脚本极其简单,只需要一行命令即可完成软件源的更换:
```bash
bash <(curl -sSL https://linuxmirrors.cn/main.sh)
```
无需安装任何依赖,无需了解复杂的配置文件结构,脚本会自动识别系统类型并引导用户完成换源过程。
### 2. 广泛的系统支持
该项目已适配高达 25+ 种操作系统,涵盖了各类主流发行版及其不同版本:
| 操作系统 | 支持版本 |
|---------|---------|
| Debian | 8~13 |
| Ubuntu | 14~25 |
| Kali Linux | 全部版本 |
| Linux Mint | 17~22 / LMDE 2~7 |
| Deepin(深度) | 全部版本 |
| Red Hat Enterprise Linux | 7~10 |
| Fedora | 30~42 |
| CentOS | 7~8 / Stream 8~10 |
| Rocky Linux | 8~10 |
| AlmaLinux | 8~10 |
| openEuler(开源欧拉) | 20~25 |
| OpenCloudOS(鸥栖) | 8.6~9 / Stream 23 |
| openKylin(开放麒麟) | 全部版本 |
| Arch Linux | 全部版本 |
| openSUSE | Leap 15 ~ 16 / Tumbleweed |
| Alpine Linux | v3 / edge |
### 3. 丰富的镜像站选择
项目深入考察了国内镜像站的系统适配情况,专为中国用户打造。支持的镜像站包括:
**中国大陆地区:**
- 阿里云(兼容性高、可用性强)
- 腾讯云
- 华为云
- 清华大学
- 中国科学技术大学(速度快)
- 北京大学
- 浙江大学
- 南京大学
- 上海交通大学
- 等多家知名高校和企业镜像站
**境外及海外地区:**
- 亚洲:香港、新加坡、台湾、日本、韩国、马来西亚等地的镜像站
- 欧洲、北美、南美、大洋洲、非洲等全球多个地区的镜像站
### 4. 高效且安全的操作体验
- **快速执行**:最快仅需 10 秒即可完成软件源的更换
- **自动备份**:脚本会自动备份原有软件源配置文件,备份路径为原文件加 `.bak` 后缀
- **交互式界面**:通过方向键交互逐步引导用户选择软件源配置,使换源过程更加直观
- **多语言支持**:内置简体中文、繁體中文、English 三种显示语言
## 高级功能
### 1. 命令行选项支持
对于高级用户和自动化场景,脚本提供了丰富的命令选项:
```bash
# 指定软件源地址
bash <(curl -sSL https://linuxmirrors.cn/main.sh) --source mirrors.aliyun.com
# 指定软件源仓库目录
bash <(curl -sSL https://linuxmirrors.cn/main.sh) --source mirrors.aliyun.com --branch rockylinux
# 仅更换 EPEL 源
bash <(curl -sSL https://linuxmirrors.cn/main.sh) --only-epel
# 恢复使用官方源
bash <(curl -sSL https://linuxmirrors.cn/main.sh) --use-official-source true
```
### 2. 无人值守模式
支持完全自动化的换源操作,适合 CI/CD 集成与批量服务器管理:
```bash
bash <(curl -sSL https://linuxmirrors.cn/main.sh) \
--source mirror.example.com \
--protocol http \
--use-intranet-source false \
--install-epel true \
--backup true \
--upgrade-software false \
--clean-cache false \
--ignore-backup-tips
```
### 3. 特殊场景支持
- **CentOS 停服问题**:对已经 EOL 的 CentOS 7/8、CentOS Stream 8 进行了适配
- **Ubuntu EOL 版本**:支持使用镜像站的 Ubuntu Old Releases 仓库
- **Debian Security 源**:可指定使用官方 Security 源提高服务器安全性
- **版本升级**:支持指定版本代号,便于系统升级
## 使用建议
1. **镜像站选择**:如果不了解这些镜像站,建议使用阿里云(兼容性高、可用性强)或中国科学技术大学(速度快)
2. **网络环境**:境外及海外用户建议使用腾讯云或阿里云镜像站
3. **权限要求**:需要 root 权限运行,可使用 `sudo -i` 或 `su root` 切换
4. **依赖问题**:如果报错 `Command not found`,需要先安装 `curl` 软件包
## 项目价值
LinuxMirrors.cn 项目不仅仅是一个简单的换源脚本,它体现了开源社区的力量:
1. **降低使用门槛**:让 Linux 新手也能轻松更换软件源,提升使用体验
2. **提高运维效率**:为系统管理员提供批量、自动化的软件源管理方案
3. **促进开源生态**:通过 MIT 开源许可,允许自由使用、修改和分发
4. **社区驱动**:项目持续接受社区贡献,不断完善和扩展功能
## 总结
LinuxMirrors.cn 是一个设计精良、功能全面的 Linux 软件源管理工具。它不仅解决了国内用户使用 Linux 时面临的软件源下载速度问题,还通过丰富的功能和选项满足了从新手到专业用户的不同需求。无论你是个人 Linux 爱好者,还是需要管理大量服务器的系统管理员,这个项目都值得尝试和推荐。
项目的成功也反映了开源社区的价值:通过共享和协作,创造出能够解决实际问题的优质工具,让更多人能够享受到技术带来的便利。
---
**项目地址**:[https://linuxmirrors.cn/](https://linuxmirrors.cn/)
**GitHub 仓库**:[https://github.com/SuperManito/LinuxMirrors](https://github.com/SuperManito/LinuxMirrors)
---
# 全球路由表查询完全指南:从入门到精通的网络探索之旅
- Canonical: https://www.zeroxin.xin/2025/11/19/global-routing-table-query-guide/
- Markdown: https://www.zeroxin.xin/2025/11/19/global-routing-table-query-guide.md
- Published: 2025-11-19T00:00:00+08:00
- Updated: 2026-06-18T17:21:03+08:00
- Language: zh-CN
- Tags: 网络工具, 网络技术, BGP, 路由查询, 系统技术
全面介绍四种全球BGP路由表查询方法,从Hurricane Electric网页工具到RouteViews、RIPE RIS以及命令行bgpq4等方案,帮助网络工程师和安全专家快速掌握互联网路由拓扑分析与故障排查技能,深入了解全球IPv4/IPv6路由表的动态变化趋势
## 引言
在互联网的庞大架构中,全球路由表(BGP Full Routing Table)是整个网络运行的"地图"。它包含了超过95万条IPv4路由和20万条IPv6路由,这些路由信息实时变化,指导着全球数据包的传输路径。无论是网络工程师排查故障,还是安全专家分析攻击源,都需要掌握查询全球路由表的方法。
本文将详细介绍四种不同的路由查询方法,从简单的网页工具到专业的命令行操作,帮助你全面了解全球互联网的路由状态。
## 方法一:使用网页图形化工具(最推荐,最直观)
对于大多数用户来说,网页图形化工具是查询路由信息最便捷的方式。这些工具提供了直观的界面,让你能够轻松查看IP地址、ASN(自治系统号)以及路由关系。
### 1. Hurricane Electric BGP Toolkit (bgp.he.net)
**特点**:这是网络工程师最常用的工具,被誉为"网络工程师的瑞士军刀"。它提供了非常清晰的图表,显示AS之间的连接关系(Peering)、上游、下游以及宣告的IP段。
**主要功能**:
- ASN查询:查看自治系统的详细信息
- IP查询:确定IP地址的归属和路由路径
- 可视化图表:直观展示网络拓扑关系
- 历史数据:查看路由变化历史
**使用方法**:
1. 访问 [https://bgp.he.net/](https://bgp.he.net/)
2. 在搜索框输入IP地址或ASN(如AS15169代表Google)
3. 查看详细的路由信息和网络关系图
**实用技巧**:
- 使用"Report"功能查看特定AS的完整路由宣告
- 通过"Graph"功能可视化网络连接关系
- 查看某个AS的"Upstream"和"Downstream"连接
### 2. RIPEstat
**特点**:由欧洲网络协调中心(RIPE NCC)维护,数据非常权威且全面。可以查看路由历史变化、地理位置、黑名单情况等。
**主要功能**:
- 路由历史分析:追踪路由变化趋势
- 地理位置信息:查看IP地址的物理位置
- 网络性能监控:分析延迟和丢包情况
- 安全事件追踪:查看恶意活动报告
**使用方法**:
1. 访问 [https://stat.ripe.net/](https://stat.ripe.net/)
2. 输入要查询的IP、ASN或域名
3. 选择相应的分析工具
**高级功能**:
- 使用"Routing History"查看路由变化
- 通过"Network Performance"分析网络质量
- 查看"Abuse Contact"获取网络 abuse 联系方式
### 3. CIDR Report
**特点**:主要用于查看全球路由表的统计数据,如当前路由表大小、哪些AS宣告了最多的路由等。
**主要功能**:
- 全球路由统计:实时路由表大小和增长趋势
- AS排名:按路由数量排序的自治系统列表
- 路由聚合分析:查看CIDR块的聚合情况
- 垃圾路由识别:标识可能的问题路由
**使用方法**:
1. 访问 [https://www.cidr-report.org/as2.0/](https://www.cidr-report.org/as2.0/)
2. 浏览各种统计报告和排名
3. 下载原始数据进行分析
## 方法二:使用 Looking Glass (窥镜)(查看实时路由)
如果你想知道"从世界的某个角落看,我的IP是如何被路由的",Looking Glass是最佳选择。这是各大ISP和服务商提供的公开路由器接口。
### 什么是 Looking Glass (LG)
Looking Glass允许你在远程路由器上执行网络诊断命令,包括:
- `ping`:测试网络连通性
- `traceroute`:追踪数据包路径
- `show ip bgp`:查看BGP路由信息
- `show route`:显示路由表条目
### 如何查找 Looking Glass
**LG 集合站**:
- [Looking Glass Database](https://www.lookingglass.org/):收集全球LG站点
- [PeeringDB](https://www.peeringdb.com/):专业的网络互联信息库
- [LG Looking Glass](https://lg.lg/):多个LG站点的聚合
**搜索技巧**:
- 在Google搜索"运营商名 + Looking Glass"
- 例如:"China Telecom Looking Glass"、"Level3 Looking Glass"
- 查找知名云服务商的LG:AWS、Google Cloud、Azure等
### 典型操作流程
1. **选择LG站点**:选择地理位置或网络路径上相关的节点
2. **输入目标**:输入要查询的IP地址或ASN
3. **选择命令**:选择要执行的网络诊断命令
4. **分析结果**:解读返回的路由信息
**常用命令示例**:
```
# 查看特定IP的BGP路由
show ip bgp 8.8.8.8
# 追踪到目标的路径
traceroute 8.8.8.8
# 测试连通性
ping 8.8.8.8
# 查看路由表摘要
show ip bgp summary
```
### 实际应用场景
**网络故障排查**:
- 从多个LG站点测试同一目标,确定问题范围
- 比较不同运营商的路由路径,优化网络选择
**性能优化**:
- 分析不同路径的延迟和丢包情况
- 选择最佳的网络服务提供商
**安全分析**:
- 追踪攻击流量的来源路径
- 分析DDoS攻击的传播模式
## 方法三:通过 Telnet/SSH 访问公共路由服务器(硬核方式)
对于习惯命令行操作的网络工程师,直接登录公共路由服务器是最直接的方式。
### University of Oregon Route Views
这是最著名的公共路由服务器项目,提供全球路由表的实时访问。
**连接方法**:
```bash
# 使用Telnet连接
telnet route-views.route-views.org
# 或者使用SSH(推荐)
ssh rviews@route-views.route-views.org
```
**常用查询命令**:
```bash
# 查看特定IP的路由信息
show ip bgp 8.8.8.8
# 查看特定ASN的路由信息
show ip bgp regexp _15169$
# 查看路由表统计信息
show ip bgp summary
# 查看特定前缀的详细信息
show ip bgp 203.0.113.0/24
# 查看路由的AS路径
show ip bgp 8.8.8.8 | include Path
```
**高级查询技巧**:
```bash
# 查看宣告特定前缀的AS
show ip bgp regexp ^15169_
# 查看经过特定AS的所有路由
show ip bgp regexp _15169_
# 查看路由的社区属性
show ip bgp 8.8.8.8 | include Community
# 查看路由的MED值
show ip bgp 8.8.8.8 | include MED
```
### RIPE RIS (Routing Information Service)
RIPE的另一个重要路由信息收集项目,提供全球多个采集点的数据。
**连接方法**:
```bash
# 连接到RIPE RIS
telnet route-views.ripe.net
```
**特色功能**:
- 多采集点数据:可以比较不同地区的路由视图
- 历史数据查询:支持查询历史路由信息
- 原始数据下载:提供MRT格式的原始路由数据
### 命令行操作最佳实践
**连接优化**:
```bash
# 使用SSH而非Telnet,更安全稳定
ssh -C rviews@route-views.route-views.org
# 设置终端类型,优化显示
export TERM=xterm
```
**查询优化**:
```bash
# 使用管道过滤输出
show ip bgp | include 8.8.8.8
# 使用正则表达式精确匹配
show ip bgp regexp ^15169_[0-9]*$
# 限制输出行数,避免信息过载
show ip bgp | head -20
```
## 方法四:下载原始数据(用于科研/大数据分析)
对于需要进行大规模数据分析、学术研究或机器学习项目的用户,下载原始路由数据是最佳选择。
### Route Views Archive
提供每2小时一次的全球路由表快照(RIB)和实时的更新日志(Updates)。
**数据类型**:
- **RIB (Routing Information Base)**:完整的路由表快照
- **Updates**:实时的路由变化日志
- **MRT格式**:标准的路由数据交换格式
**下载方法**:
```bash
# 使用wget下载特定日期的路由表
wget http://archive.routeviews.org/bgpdata/2025.11/RIBS/rib.20251119.0800.bz2
# 使用rsync同步大量数据
rsync -avz rsync://archive.routeviews.org/bgpdata/ /local/path/
```
**数据处理**:
```python
# 使用Python解析MRT格式数据
import pybgpstream
# 创建BGP流
stream = pybgpstream.BGPStream(
from_time="2025-11-19 00:00:00",
until_time="2025-11-19 23:59:59",
collectors=["route-views2"],
record_type="updates"
)
# 处理路由更新
for elem in stream:
print(f"Time: {elem.time}, Prefix: {elem.prefix}, AS: {elem.as_path}")
```
### RIPE RIS Raw Data
RIPE的另一个重要数据源,包含来自全球多个采集点的数据。
**特色功能**:
- 多采集点数据:覆盖全球主要网络节点
- 长期历史数据:支持回溯分析
- 实时数据流:支持实时监控
**访问方法**:
```bash
# 使用FTP下载
ftp ftp.ripe.net
# 或使用HTTP下载
wget https://www.ripe.net/analyse/internet-measurements/routing-information-service-ris/ris-raw-data
```
### 大数据分析应用
**数据预处理**:
```python
# 使用Pandas处理大规模路由数据
import pandas as pd
import pybgpstream
def process_bgp_data(date_range):
data = []
for date in date_range:
stream = pybgpstream.BGPStream(
from_time=f"{date} 00:00:00",
until_time=f"{date} 23:59:59",
record_type="ribs"
)
for elem in stream:
data.append({
'timestamp': elem.time,
'prefix': elem.prefix,
'as_path': elem.as_path,
'origin_as': elem.as_path[-1] if elem.as_path else None
})
return pd.DataFrame(data)
# 分析路由变化趋势
df = process_bgp_data(['2025-11-17', '2025-11-18', '2025-11-19'])
route_changes = df.groupby('timestamp').size()
```
**可视化分析**:
```python
# 使用Matplotlib可视化路由变化
import matplotlib.pyplot as plt
def plot_route_trends(df):
plt.figure(figsize=(12, 6))
# 按小时统计路由数量
hourly_routes = df.groupby(df['timestamp'].dt.hour).size()
plt.plot(hourly_routes.index, hourly_routes.values, marker='o')
plt.title('路由数量随时间变化')
plt.xlabel('小时')
plt.ylabel('路由数量')
plt.grid(True)
plt.show()
plot_route_trends(df)
```
## 实战案例:综合应用多种查询方法
### 案例1:网站访问异常排查
**场景**:用户报告无法访问某个网站,需要确定问题所在。
**解决步骤**:
1. **使用bgp.he.net初步诊断**:
- 查询目标网站的IP地址和ASN
- 检查是否有路由宣告异常
2. **通过多个Looking Glass验证**:
- 从不同地理位置测试连通性
- 比较路由路径差异
3. **使用Route Views深入分析**:
- 查看历史路由变化
- 确定问题发生的时间点
```bash
# 在Route Views中查询历史路由
show ip bgp 203.0.113.0/24 | include Path
```
### 案例2:网络性能优化
**场景**:企业需要选择最佳的网络服务提供商。
**解决步骤**:
1. **收集路由信息**:
- 使用RIPEstat分析不同ISP的路由质量
- 查看历史性能数据
2. **实际测试**:
- 通过多个LG站点进行延迟测试
- 分析不同路径的网络质量
3. **数据驱动决策**:
- 下载历史数据进行分析
- 建立网络质量评估模型
### 案例3:安全事件响应
**场景**:检测到来自特定IP的攻击,需要追踪攻击源。
**解决步骤**:
1. **快速定位**:
- 使用bgp.he.net查询IP归属
- 查看ASN的信誉记录
2. **路径追踪**:
- 通过Looking Glass追踪攻击路径
- 确定攻击流量的入口点
3. **深度分析**:
- 使用Route Views分析攻击模式
- 查看是否有路由劫持迹象
## 工具选择指南
### 根据需求选择合适的方法
| 使用场景 | 推荐工具 | 难度等级 | 实时性 |
|---------|---------|---------|--------|
| 日常查询 | bgp.he.net | 初级 | 实时 |
| 网络故障排查 | Looking Glass | 中级 | 实时 |
| 深度分析 | Route Views | 高级 | 近实时 |
| 大数据分析 | 原始数据下载 | 高级 | 延迟 |
### 学习路径建议
**初学者**:
1. 熟练使用bgp.he.net进行基本查询
2. 学习理解BGP基础概念
3. 掌握IP地址和ASN的基本知识
**进阶用户**:
1. 学习使用Looking Glass进行网络诊断
2. 掌握基本的路由分析命令
3. 理解AS路径和路由策略
**专家用户**:
1. 熟练使用Route Views进行深度分析
2. 掌握MRT格式数据处理
3. 能够进行大规模路由数据分析
## 常见问题与解决方案
### Q1: 为什么不同工具显示的路由信息不一致?
**原因**:
- 不同采集点的地理位置差异
- 数据更新时间不同步
- 路由策略导致的视图差异
**解决方案**:
- 使用多个数据源进行交叉验证
- 注意数据的时间戳
- 理解BGP的路由传播机制
### Q2: 如何处理查询超时或连接失败?
**原因**:
- 网络连接问题
- 服务器负载过高
- 防火墙阻止连接
**解决方案**:
```bash
# 尝试不同的连接方式
telnet route-views.route-views.org
ssh rviews@route-views.route-views.org
# 使用代理或VPN
ssh -D 8080 rviews@route-views.route-views.org
```
### Q3: 大规模数据下载如何优化?
**优化策略**:
```bash
# 使用rsync增量同步
rsync -avz --partial --progress rsync://archive.routeviews.org/bgpdata/ /local/path/
# 并行下载多个文件
wget -c -i download_list.txt -P ./data/
# 使用压缩减少传输量
wget http://archive.routeviews.org/bgpdata/2025.11/RIBS/rib.20251119.0800.bz2
```
## 未来发展趋势
### 技术演进
**BGP安全增强**:
- RPKI(Resource Public Key Infrastructure)的普及
- BGPsec的逐步部署
- 路由安全监测系统的完善
**数据分析技术**:
- 机器学习在路由异常检测中的应用
- 实时大数据处理技术的发展
- 可视化技术的进步
**工具发展**:
- 更友好的Web界面
- 自动化分析工具
- API接口的标准化
### 挑战与机遇
**挑战**:
- 路由表规模持续增长
- 网络复杂度不断提高
- 安全威胁日益严峻
**机遇**:
- AI技术在网络管理中的应用
- 边缘计算的发展
- 5G/6G网络带来的新需求
## 结语
掌握全球路由表查询方法是网络工程师和安全专家的重要技能。从简单的网页工具到复杂的命令行操作,每种方法都有其适用场景。通过本文的介绍,你应该能够:
1. 根据需求选择合适的查询工具
2. 理解不同查询方法的优缺点
3. 掌握基本的路由分析技巧
4. 处理常见的查询问题
记住,网络世界在不断变化,持续学习和实践是保持技能更新的关键。希望本文能够成为你探索全球网络世界的有力工具。
---
## 参考资料
1. [Hurricane Electric BGP Toolkit](https://bgp.he.net/)
2. [RIPEstat Data Analysis](https://stat.ripe.net/)
3. [University of Oregon Route Views Project](http://archive.routeviews.org/)
4. [CIDR Report](https://www.cidr-report.org/)
5. [BGP Protocol RFC 4271](https://tools.ietf.org/html/rfc4271)
---
*本文基于公开的网络工具和技术文档整理,旨在帮助读者全面了解全球路由表查询方法。如有错误或疏漏,欢迎指正。*
---
# PinMe - 一键部署静态网站到IPFS的神奇工具
- Canonical: https://www.zeroxin.xin/2025/11/18/pinme-introduction/
- Markdown: https://www.zeroxin.xin/2025/11/18/pinme-introduction.md
- Published: 2025-11-18T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: 开源项目, Web3, IPFS, 部署工具, 去中心化, ENS
PinMe是由Glitter Protocol团队开发的一键IPFS静态网站部署工具,支持自动关联ENS子域名实现去中心化托管。本文介绍其核心架构、IPFS永久存储机制、eth.limo网关加速以及与传统中心化部署方案的对比优势,体验Web3时代的去中心化Web托管
## 项目简介
[PinMe](https://github.com/glitternetwork/pinme) 是一个革命性的一键部署工具,由 Glitter Protocol 团队开发维护,旨在将静态网站永久、可验证地部署到 IPFS 网络。与传统的中心化服务器部署不同,PinMe 提供了一个更加开放、去中心化的托管解决方案。
**核心特点:**
- ✨ 一键部署:简单的命令即可完成部署
- 🌐 IPFS 永存:内容通过 IPFS 网络永久存储
- 🔗 ENS 集成:自动关联 ENS 子域名实现内容验证
- 🚀 网关加速:通过 eth.limo 等网关快速访问
- ✅ 无服务器:无需配置 DNS,无需租赁服务器
**项目信息:**
- 📦 主要语言:TypeScript (59.4%)、HTML (34.2%)、CSS (3.8%)
- ⭐ GitHub Stars:924+(持续增长)
- 🔄 最新版本:v1.1.5
- 📄 开源协议:MIT License
---
## 工作原理
PinMe 通过三个关键步骤完成网站部署:
```
用户输入 → 上传到IPFS → 写入ENS子域名 → 通过网关访问
```
1. **IPFS 上传**:将网站文件上传到分布式存储网络,获得内容哈希(Content Hash)
2. **ENS 绑定**:将内容哈希写入 ENS 子域名记录,实现内容可验证性
3. **网关访问**:用户可以通过多个网关(如 eth.limo)访问已部署的网站,无需依赖单一服务商
这种设计完全消除了中心化服务提供商的依赖,真正实现了互联网的去中心化托管。
---
## 安装方法
### 使用 npm
```bash
npm install -g pinme
```
### 使用 yarn
```bash
yarn global add pinme
```
安装完成后,你就可以在全局环境中使用 `pinme` 命令了。
---
## 核心功能使用指南
### 1. 上传文件或目录
**交互式上传(推荐新手使用):**
```bash
pinme upload
```
**直接指定路径上传:**
```bash
pinme upload /path/to/file-or-directory
```
**上传整个网站目录:**
```bash
pinme upload ./my-website
```
#### 上传限制
- 单个文件最大:**20MB**
- 目录总大小最大:**500MB**
### 2. 从 IPFS 移除文件
**交互式删除:**
```bash
pinme rm
```
**按哈希删除:**
```bash
pinme rm bafybeifdwyoz66u5czbbjvmmais5fzrzrolxbyiydqsbrxessndt3s6zdi
```
> ⚠️ 注意:此操作会从 Glitter Protocol 的 IPFS 节点中取消固定(unpin)文件并删除 ENS 子域名记录,但不保证文件从整个 IPFS 网络中被完全删除。
### 3. 查看上传历史
**显示最近 10 条上传记录:**
```bash
pinme list
```
**显示最近 5 条记录:**
```bash
pinme ls -l 5
```
**清空所有历史记录:**
```bash
pinme list -c
```
### 4. 获取帮助
```bash
pinme help
pinme help upload # 查看特定命令帮助
```
---
## 实战场景:部署 Vite 项目
如果你使用 **Vite** 构建你的前端项目,需要做一个简单的配置:
在 `vite.config.js` 中添加 `base: "./"` 配置:
```javascript
// vite.config.js
export default {
base: "./",
// 其他配置...
}
```
这样可以确保资源路径在 IPFS 网关上正确解析。
完整的部署流程:
```bash
# 1. 构建项目
npm run build
# 2. 上传到 IPFS
pinme upload ./dist
# 3. 获得 IPFS 哈希和 ENS 域名
# 完成!你的网站现在永久存在于去中心化网络上
```
---
## 文件存储与日志
### 访问已上传的内容
成功上传后,你会获得:
1. **IPFS 内容哈希** - 用于 IPFS 网络访问
2. **可访问 URL** - 通过 eth.limo 网关直接访问
### 本地日志和配置位置
- **Linux/macOS**: `~/.pinme/`
- **Windows**: `%USERPROFILE%\.pinme\`
所有上传历史和配置信息存储在这些目录中,便于管理和调试。
---
## 使用场景与优势
### 1. **个人博客与作品集**
使用 PinMe 部署你的 Hexo、Hugo 或 Next.js 博客,获得永久的、去中心化的托管。无论何时何地,只要 IPFS 网络存在,你的内容就不会消失。
### 2. **开源项目文档**
为开源项目部署官方文档网站,免去服务器维护成本。文档的永久性和可验证性非常重要。
### 3. **NFT 元数据托管**
存储 NFT 项目的元数据和媒体资源,确保 NFT 关联的内容永久可用。
### 4. **Web3 产品前端**
部署 DApp、钱包或其他 Web3 产品的前端,真正实现去中心化应用的完整体验。
### 5. **内容抵抗审查**
对于需要抵抗审查的内容,IPFS 的分布式特性提供了天然的保护。
---
## 与传统部署方案的对比
| 特性 | PinMe (IPFS+ENS) | 传统服务器 | GitHub Pages |
|------|------------------|----------|-------------|
| **成本** | 免费/低成本 | 每月需付费 | 免费 |
| **所有权** | 完全去中心化 | 依赖服务商 | 依赖 GitHub |
| **可用性** | 分布式网络 | 单点故障风险 | 依赖 GitHub 可用性 |
| **永久性** | 内容哈希保证 | 服务商决定 | 可能被删除 |
| **可验证性** | ENS 绑定验证 | 无 | 无 |
| **学习曲线** | 简单易用 | 需要运维知识 | 简单易用 |
---
## 项目亮点分析
### 🎯 解决的核心问题
传统部署方案存在以下问题:
- **中心化风险**:服务商可随时关闭服务或审查内容
- **成本压力**:持续的服务器费用
- **内容丢失**:依赖单一平台的长期存在
PinMe 通过 IPFS + ENS 的组合完美解决了这些问题。
### 🚀 技术创新
1. **简化体验**:一键部署,无需学习复杂的 IPFS、ENS 操作
2. **自动化处理**:自动生成 ENS 记录,管理上传历史
3. **用户友好**:提供交互式命令和直观的命令行接口
4. **社区支持**:活跃的开发团队,定期更新和改进
### 📊 发展现状
- GitHub 上有 924+ Stars,体现了社区认可
- 51 个 Forks 说明有不少开发者基于此进行定制
- 最新版本 v1.1.5 持续活跃更新(3周前发布)
- 完善的文档和示例,降低上手难度
---
## 快速开始示例
### 完整的部署流程
```bash
# 1. 全局安装 PinMe
npm install -g pinme
# 2. 创建一个简单的静态网站
mkdir my-website
echo "Hello IPFS!" > my-website/index.html
# 3. 上传到 IPFS
pinme upload ./my-website
# 4. 获得输出结果
# IPFS Hash: QmXxxx...
# ENS URL: my-pinme.eth
# Access via: https://my-pinme.eth.limo
# 5. 查看历史记录
pinme list
```
---
## 常见问题解答
**Q: 上传的文件会永远存在吗?**
A: 文件存储在 IPFS 网络上。只要有节点持有这些数据,内容就会存在。Glitter Protocol 提供了固定服务,确保已上传的文件不会轻易被清除。
**Q: 能否更新已上传的网站?**
A: 可以。每次上传会生成新的内容哈希和 ENS 记录。如果需要更新,上传新版本的网站即可。
**Q: 如何确保安全性?**
A: PinMe 不需要密钥或私密信息,上传过程完全安全。所有记录存储在本地 `~/.pinme` 目录中。
**Q: 支持哪些文件类型?**
A: PinMe 支持所有文件类型。只要遵守大小限制(单文件 20MB,目录 500MB)即可。
---
## 社区与反馈
### 获取帮助
如有问题或建议,可以通过以下方式联系:
- **GitHub Issues**: [https://github.com/glitternetwork/pinme/issues](https://github.com/glitternetwork/pinme/issues)
- **Email**: [pinme@glitterprotocol.io](mailto:pinme@glitterprotocol.io)
### 贡献代码
PinMe 欢迎社区贡献。主要贡献者包括:
- [@Chi111](https://github.com/Chi111) - 项目创意与开发
- [@rrbin666](https://github.com/rrbin666) - 主要维护者
---
## 展望与意义
PinMe 代表了 Web3 时代对托管方案的重新思考。它证明了:
1. **去中心化可以很简单** - 用户无需理解 IPFS 内部工作原理,就能享受去中心化的好处
2. **成本可以显著降低** - 免除了服务器租赁费用
3. **互联网的未来方向** - 内容寻址、用户自主、隐私保护
无论你是想要部署个人博客、开源项目文档,还是探索 Web3 技术,PinMe 都是一个值得尝试的工具。
---
## 总结
PinMe 是一个优雅而强大的工具,它将复杂的去中心化技术(IPFS、ENS)封装成简单易用的命令行接口。通过 `pinme upload` 一条命令,你就能将网站部署到全球分布式网络中,获得永久、可验证、无审查的托管。
如果你关心内容自主性、成本控制或对 Web3 充满好奇,PinMe 绝对值得一试!
**快去试试吧:**
```bash
npm install -g pinme
pinme upload ./your-website
```
立即开启你的去中心化托管之旅!🚀
---
## 相关资源
- 🌐 项目官网:[https://pinme.eth.limo/](https://pinme.eth.limo/)
- 📦 GitHub 仓库:[https://github.com/glitternetwork/pinme](https://github.com/glitternetwork/pinme)
- 🔗 Glitter Protocol:[https://glitterprotocol.io/](https://glitterprotocol.io/)
- 📚 IPFS 官方:[https://ipfs.tech/](https://ipfs.tech/)
- 🆔 ENS 官方:[https://ens.domains/](https://ens.domains/)
---
**更新时间**: 2025年11月18日
**作者**: ZeroXin
**许可证**: 本文采用 CC BY-SA 4.0 许可
---
# AI驱动的安全测试工具:Strix
- Canonical: https://www.zeroxin.xin/2025/11/13/AI%E9%A9%B1%E5%8A%A8%E7%9A%84%E5%AE%89%E5%85%A8%E6%B5%8B%E8%AF%95%E5%B7%A5%E5%85%B7%EF%BC%9AStrix/
- Markdown: https://www.zeroxin.xin/2025/11/13/AI%E9%A9%B1%E5%8A%A8%E7%9A%84%E5%AE%89%E5%85%A8%E6%B5%8B%E8%AF%95%E5%B7%A5%E5%85%B7%EF%BC%9AStrix.md
- Published: 2025-11-13T19:29:32+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Tags: AI, 安全测试, 开源项目, 渗透测试
Strix是一款AI驱动的自动化安全测试工具,利用大语言模型和机器学习技术实现智能渗透测试、漏洞扫描与安全审计。本文介绍其核心架构、AI辅助测试流程、支持的测试场景以及如何将Strix集成到DevSecOps流水线中,为企业安全团队提供高效的自动化安全验证方案
在应用开发流程中,安全测试是一个经常被忽视但至关重要的环节。传统的静态分析工具误报率高,而人工渗透测试又耗时耗力。Strix作为一个由AI驱动的开源安全测试工具,为这一问题提供了创新的解决方案。

Strix是一个能够自主运行的智能体,它的行为模式就像真正的黑客一样。它不仅能够动态运行代码、发现安全漏洞,还能通过实际的攻击进行验证,大大减少了误报问题。
以往需要人工数周完成的渗透测试,它可以在数小时内完成,提速30倍,显著提高了安全测试效率。
Strix专门为需要快速、准确安全测试的开发人员和安全测试团队打造,目标是在无需人工渗透测试的情况下实现快速精准的安全检测,避免传统手动测试的麻烦,并杜绝静态分析工具频发误报。
项目地址:https://github.com/usestrix/strix
# 一、Strix 详细介绍
## 核心亮点
Strix 开箱即用,提供完整的黑客工具包,包含 HTTP 代理、浏览器自动化等工具。
它运行真实的攻击、查找漏洞,编写详细报告,甚至能自动编写修复代码,7×24 小时监控保护用户的应用程序。
它还对每一个 finding 都要求包含 PoC (概念验证)和漏洞处理证据,从根本上避免误报的情况。
此外,它采用分布式代理协作,使用多个专业代理并行工作来提高测试效率。
同时容器化隔离环境也确保测试过程的安全性和可控性。
## 使用场景
Strix 可以应用在多种场景中:
- 检测和验证应用程序中的关键漏洞。
- 在数小时内快速完成渗透测试并生成合规性报告。
- 自动执行漏洞赏金任务并生成 PoC 为报告生成提速。
- 集成进 CI/CD 流程,在上线前就发现并阻止漏洞。
## 覆盖的漏洞检测
Strix 能够检测到的漏洞种类非常全面,包括:
- 访问控制:IDOR 、权限提升、身份验证绕过
- 注入攻击:SQL 、NoSQL 、命令注入
- 服务器端:SSRF 、XXE 、反序列化缺陷
- 客户端:XSS 、原型污染、DOM 漏洞
- 业务逻辑:竞争条件、工作流作
- 身份验证:JWT 漏洞、会话管理
- 基础架构:配置错误、服务暴露
# 二、快速上手
## 本地使用
一些准备:
- Docker
- Python 版本需要在 3.12+
- 有 API 可以调用 LLM ,或者本地有 LLM
克隆存储库:
```bash
git clone https://github.com/usestrix/strix.git
cd strix
```
安装开发依赖项:
```bash
make setup-dev
# or manually:
poetry install --with=dev
poetry run pre-commit install
```
配置 LLM 提供程序:
```bash
export STRIX_LLM="openai/gpt-5"
export LLM_API_KEY="your-api-key"
```
在开发模式下运行 Strix:
```bash
poetry run strix --target https://example.com
```
第一次运行拉取沙盒 Docker image ,结果保存在 `agent_runs/` 下。
## 云托管版本
如果想要更省事的方式,可以先试用一下 Strix 官方的云托管版本。
它还支持预订 demo 展示,更多信息请移步:https://usestrix.com/
## 使用示例
### 默认用法
```bash
# Local codebase analysis
strix --target ./app-directory
# Repository security review
strix --target https://github.com/org/repo
# Black-Box Web application assessment
strix --target https://your-app.com
# Grey-Box Security Assesment
strix --target https://your-app.com --instructions "Perform authenticated testing using the following credentials user:pass"
# Multi-target white-box testing (source code + deployed app)
strix -t https://github.com/org/app -t https://your-app.com
# Focused testing with instructions
strix --target api.your-app.com --instruction "Focus on business logic flaws and IDOR vulnerabilities"
```
### Headless Mode
使用 `-n/--non-interactive` 标志通过编程方式运行 Strix ,无需交互式 UI ,非常适合服务器和自动化作业。CLI 在退出之前会打印出实时的漏洞发现和最终报告。发现漏洞时会以非零代码退出。
```bash
strix -n --target https://your-app.com
```
### CI/CD
可以将 Strix 添加到管道中,然后使用轻量级 GitHub Actions 工作流程对拉取请求运行安全测试:
```yaml
name: strix-penetration-test
on:
pull_request:
jobs:
security-scan:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- name: Install Strix
run: pipx install strix-agent
- name: Run Strix
env:
STRIX_LLM: ${{ secrets.STRIX_LLM }}
LLM_API_KEY: ${{ secrets.LLM_API_KEY }}
run: strix -n -t ./
```
# 三、总结
从安装到运行,整个过程非常轻量化,通过 `pipx` 安装并配置 LLM 密钥即可使用。
对于开发者和安全测试相关人员,可以体验这个工具。对于项目,上线前都可以接入这个工具做一个快速的渗透测试,提高应用的安全性。
---
# Algorithm Visualizer:算法可视化学习平台
- Canonical: https://www.zeroxin.xin/2025/11/13/Algorithm-Visualizer%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D/
- Markdown: https://www.zeroxin.xin/2025/11/13/Algorithm-Visualizer%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D.md
- Published: 2025-11-13T00:00:00+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, 算法可视化, 学习工具, 教育技术, JavaScript
Algorithm-Visualizer是一个开源的算法可视化学习平台,通过图形化的交互界面直观展示各类数据结构和算法的运行过程。本文介绍其支持的算法库、可视化引擎设计、交互式学习模式以及如何帮助编程学习者深入理解排序、搜索、图算法等核心计算机科学概念
## 前言
在计算机科学领域,算法和数据结构的学习一直是一个既重要又具有挑战性的过程。传统的学习方式往往依赖于抽象的理论讲解和静态的代码示例,这使得学习者难以直观理解算法的执行过程和内部逻辑。今天,我要向大家介绍一个创新的开源项目——**Algorithm Visualizer**,它通过交互式可视化的方式,让算法学习变得更加直观和有趣。
## 项目概述
**Algorithm Visualizer** 是一个基于Web的算法可视化学习平台,它允许用户在线可视化、动画化和播放算法的执行过程。该项目为学习者提供了一个交互式环境,可以直观地观察算法每一步的执行状态,从而更好地理解算法的工作原理。
### 项目亮点数据
- **GitHub Stars**: 25k+ ⭐
- **Forks**: 4k+
- **贡献者**: 100+ 开发者
- **技术栈**: JavaScript, React, Webpack
- **功能**: 近百种算法的可视化展示
## 核心功能特性
### 1. 🎯 交互式算法可视化
Algorithm Visualizer最大的特色是提供交互式的算法执行过程可视化:
- **逐步执行**: 可以逐行查看算法的执行过程
- **暂停/继续**: 支持暂停和继续算法执行
- **速度调节**: 可以调整算法执行速度
- **参数设置**: 自定义算法输入参数
### 2. 📚 丰富的算法库
平台涵盖了计算机科学中的多种经典算法:
**排序算法**:
- 冒泡排序 (Bubble Sort)
- 选择排序 (Selection Sort)
- 插入排序 (Insertion Sort)
- 快速排序 (Quick Sort)
- 归并排序 (Merge Sort)
- 堆排序 (Heap Sort)
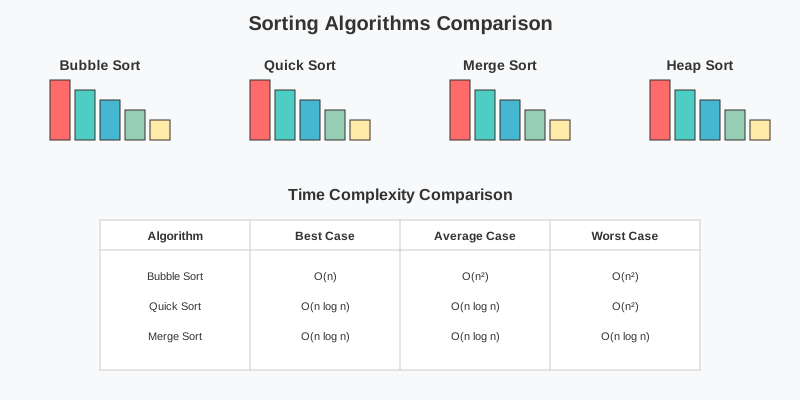
**搜索算法**:
- 线性搜索 (Linear Search)
- 二分搜索 (Binary Search)
- 深度优先搜索 (DFS)
- 广度优先搜索 (BFS)
**图算法**:
- Dijkstra最短路径算法
- A*寻路算法
- 拓扑排序
- 最小生成树
**数据结构**:
- 栈 (Stack)
- 队列 (Queue)
- 链表 (Linked List)
- 树 (Tree)
- 二叉搜索树 (BST)
### 3. 🔧 自定义算法支持
除了内置的算法库,平台还支持用户自定义算法:
- **算法编辑器**: 提供语法高亮的代码编辑器
- **可视化配置**: 自定义视觉效果和动画
- **分享功能**: 生成链接分享自定义算法
## 技术架构深度解析
### 核心技术栈
1. **前端框架**:
- **React**: 构建用户界面
- **Webpack**: 模块打包工具
- **Babel**: JavaScript转译器
- **ES6+**: 现代JavaScript语法
2. **可视化引擎**:
- **Canvas API**: 2D图形渲染
- **CSS3动画**: 流畅的动画效果
- **SVG**: 矢量图形支持
3. **状态管理**:
- **React State**: 组件状态管理
- **算法状态跟踪**: 算法执行状态管理
### 工作流程
1. **算法选择**: 用户从算法库中选择要可视化的算法
2. **参数配置**: 设置输入参数和可视化选项
3. **算法执行**: 后台执行算法并记录每一步状态
4. **动画渲染**: 将算法状态转换为可视化动画
5. **用户交互**: 响应用户控制操作(暂停、继续、速度等)
## 高级功能特性
### 1. 多视图展示
```javascript
// 代码视图:显示当前执行的代码行
// 数据视图:显示数据结构的实时状态
// 动画视图:展示算法执行过程的图形化表示
```
### 2. 深度调试功能
- **断点设置**: 在代码中设置断点暂停执行
- **变量监控**: 实时监控算法执行过程中的变量值
- **执行路径**: 跟踪算法执行路径和分支选择
### 3. 学习辅助功能
- **步骤说明**: 每个执行步骤的详细说明
- **复杂度分析**: 显示时间复杂度和空间复杂度
- **注释系统**: 支持添加学习注释
## 实际应用场景
### 1. 教育场景
- **课堂教学**: 帮助教师直观展示算法执行过程
- **自主学习**: 学生可以按自己的节奏学习算法
- **编程竞赛**: 算法竞赛选手的训练工具
### 2. 专业开发
- **算法验证**: 验证自定义算法的正确性
- **性能对比**: 比较不同算法的执行效率
- **教学开发**: 作为算法教学应用的参考实现
### 3. 招聘面试
- **面试准备**: 帮助求职者复习常用算法
- **面试演示**: 在面试过程中展示算法理解
## 项目生态与发展
### 社区贡献
- **开源贡献**: 活跃的开源社区
- **多语言支持**: 国际化界面支持
- **持续维护**: 定期更新和bug修复
### 教育影响
- **广泛采用**: 全球多所高校使用
- **学术认可**: 被多项教育研究引用
- **社区驱动**: 基于用户反馈持续改进
### 未来发展
项目正在持续演进,计划包括:
- **AI辅助学习**: 基于学习行为推荐算法
- **VR支持**: 虚拟现实算法可视化
- **移动端优化**: 更好的移动端体验
- **协作功能**: 多人实时协作算法学习
## 使用指南
### 快速开始
1. **访问网站**
```bash
# 访问在线版本
https://algorithm-visualizer.org/
```
2. **选择算法**
- 浏览算法库
- 选择感兴趣的算法类型
- 点击具体算法进入可视化界面
3. **自定义参数**
- 修改输入数据
- 调整执行速度
- 设置其他可视化选项
4. **开始可视化**
- 点击"Run"按钮开始执行
- 使用控制按钮进行交互
- 观察算法执行的每一步
### 高级用法
1. **自定义算法**
```javascript
// 在算法编辑器中编写自定义算法
function customAlgorithm(array) {
// 算法逻辑
for (let i = 0; i < array.length; i++) {
// 可视化步骤
visualizeStep(i, array[i]);
}
}
```
2. **导出功能**
- 导出算法执行记录
- 生成学习笔记
- 分享算法链接
## 技术亮点详解
### 1. 算法执行追踪
Algorithm Visualizer的核心在于对算法执行过程的精确追踪:
```javascript
// 算法执行器
class AlgorithmExecutor {
constructor(algorithm) {
this.algorithm = algorithm;
this.stateHistory = [];
this.currentStep = 0;
}
execute() {
// 执行算法并记录每一步的状态
this.stateHistory.push(this.saveState());
}
saveState() {
// 保存当前算法执行状态
return {
variables: { ...this.variables },
codePosition: this.codePosition,
visualization: this.getVisualizationData()
};
}
}
```
### 2. 可视化引擎
可视化引擎负责将算法状态转换为图形化展示:
- **Canvas渲染**: 高性能的2D图形渲染
- **动画缓动**: 使动画更加自然流畅
- **交互处理**: 响应用户操作
### 3. 响应式设计
平台采用响应式设计,适配各种设备:
- **桌面端**: 完整功能和大屏幕展示
- **平板端**: 优化触控操作体验
- **移动端**: 简化界面,重点突出
## 项目影响与价值
### 教育价值
- **直观学习**: 让抽象的算法概念变得具体
- **互动体验**: 提高学习兴趣和参与度
- **深度理解**: 帮助理解算法内部机制
### 技术贡献
- **可视化技术**: 推动算法可视化技术发展
- **开源精神**: 为社区提供高质量的开源项目
- **教育工具**: 丰富计算机科学教育工具
### 社区建设
- **知识共享**: 促进算法知识的传播
- **协作学习**: 建立算法学习社区
- **持续改进**: 基于用户反馈持续优化
## 成功案例与用户反馈
### 1. 教育机构采用
多所大学将Algorithm Visualizer作为算法课程的教学辅助工具,教师反馈:
> "使用Algorithm Visualizer后,学生对算法的理解明显提升,课堂互动性也大大增强。"
### 2. 程序员职业发展
许多程序员利用该平台复习和学习算法,为面试做准备:
> "这个工具帮我重新理解了很多遗忘的算法,面试准备效率大大提高。"
### 3. 编程竞赛选手
算法竞赛选手使用该平台训练和验证算法实现:
> "通过可视化验证,我能够快速发现算法实现中的问题。"
## 技术挑战与解决方案
### 1. 性能优化
- **挑战**: 大规模数据集的算法可视化可能导致性能问题
- **解决方案**: 使用虚拟化技术,仅渲染可见部分
### 2. 代码执行沙箱
- **挑战**: 安全执行用户自定义的算法代码
- **解决方案**: 使用沙箱环境隔离用户代码
### 3. 响应式动画
- **挑战**: 在不同设备上提供一致的动画体验
- **解决方案**: 自适应动画参数,基于设备性能调整
## 与其他工具对比
| 特性 | Algorithm Visualizer | 其他可视化工具 |
|------|---------------------|----------------|
| 算法种类 | 100+ | 50左右 |
| 交互性 | 高 | 中等 |
| 自定义算法 | 支持 | 有限 |
| 用户界面 | 现代化 | 传统 |
| 社区支持 | 活跃 | 有限 |
| 免费使用 | 完全免费 | 部分收费 |
## 开发者资源
### 贡献指南
如果想为项目贡献,可以:
1. **报告问题**: 在GitHub上提交bug报告
2. **提交修复**: Fork项目并提交Pull Request
3. **添加算法**: 贡献新的算法可视化
4. **文档完善**: 改进项目文档和使用说明
### API接口
项目提供API支持自定义集成:
```javascript
// 使用API集成到其他应用
const visualizer = new AlgorithmVisualizer({
container: '#visualizer-container',
algorithm: 'bubble-sort',
data: [64, 34, 25, 12, 22, 11, 90]
});
visualizer.execute();
```
## 总结
Algorithm Visualizer作为一个创新的算法可视化学习平台,成功地将抽象的算法概念转化为直观的视觉体验。它不仅为学生和开发者提供了一个强大的学习工具,也为计算机科学教育带来了新的可能性。
通过交互式可视化,用户可以深入理解算法的内部工作机制,这是传统学习方式难以实现的。项目采用现代化的Web技术栈,提供了流畅的用户体验和丰富的功能特性。
无论你是计算机科学专业的学生、正在准备技术面试的程序员,还是希望深入了解算法的自学者,Algorithm Visualizer都是一个值得尝试的优秀工具。它将复杂的算法概念变得简单易懂,让算法学习变得更加高效和有趣。
---
**相关链接**:
- GitHub仓库: [https://github.com/algorithm-visualizer/algorithm-visualizer](https://github.com/algorithm-visualizer/algorithm-visualizer)
- 在线演示: [https://algorithm-visualizer.org/](https://algorithm-visualizer.org/)
- 项目文档: [https://github.com/algorithm-visualizer/algorithm-visualizer/wiki](https://github.com/algorithm-visualizer/algorithm-visualizer/wiki)
**标签**: #算法可视化 #学习工具 #开源项目 #教育技术 #JavaScript #React #算法学习
---
# Snippai:AI驱动的智能截图工具 - 重新定义你的截图体验
- Canonical: https://www.zeroxin.xin/2025/11/09/Snippai%EF%BC%9AAI%E9%A9%B1%E5%8A%A8%E7%9A%84%E6%99%BA%E8%83%BD%E6%88%AA%E5%9B%BE%E5%B7%A5%E5%85%B7/
- Markdown: https://www.zeroxin.xin/2025/11/09/Snippai%EF%BC%9AAI%E9%A9%B1%E5%8A%A8%E7%9A%84%E6%99%BA%E8%83%BD%E6%88%AA%E5%9B%BE%E5%B7%A5%E5%85%B7.md
- Published: 2025-11-09T15:18:04+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Tags: 开源项目, AI工具, 截图工具, 图像识别, 人工智能
Snippai是一款AI驱动的智能截图与代码片段管理工具,支持截图识别、代码自动提取、智能分类和快速检索。本文介绍其核心技术包括OCR识别、代码语法分析、标签自动生成以及如何帮助开发者高效管理和复用代码片段
## 引言
在数字化的日常工作生活中,截图工具已经成为我们不可或缺的伙伴。从简单的屏幕捕获到复杂的图像分析,传统的截图工具虽然能满足基本需求,但在AI时代,我们需要更智能、更强大的解决方案。
**Snippai** 正是这样一个革命性的AI驱动截图工具,它将人工智能的强大能力与传统截图工具的便捷性完美结合,为用户带来了全新的"**Snip Anything, Solve Everything**"(截图一切,解决一切)体验。
## 项目背景与愿景
### 开源精神的力量
Snippai是由开源社区开发者 [xyTom](https://github.com/xyTom) 主导开发的开源项目,目前已经在GitHub上获得了1.4k+的star数和77个fork,充分体现了社区对这一创新工具的认可和喜爱。
作为一款开源项目,Snippai不仅代码透明可审查,更重要的是它汇聚了全球开发者的智慧和贡献。项目目前已有3位核心贡献者,包括PinkGlove和xuanji86等开发者共同推动项目发展。
### 技术架构概览
Snippai采用现代化的技术栈构建:
- **TypeScript (49.3%)** - 主要开发语言,确保代码的类型安全和可维护性
- **HTML (38.1%)** - 现代化的Web界面框架
- **JavaScript (11.0%)** - 交互逻辑处理
- **CSS (1.6%)** - 精美的界面样式
项目基于Vite构建系统,配置了完整的前端开发环境,包括ESLint代码规范检查、PostCSS和Tailwind CSS样式处理等现代化工具链。
## 核心功能深度解析
### 1. 公式识别 - 学术研究的得力助手
**特色功能**:
- 智能识别图片中的数学公式
- 自动转换为LaTeX格式
- 支持复杂数学表达式解析
- 便于在文档、论文中复用
**应用场景**:
- 学术论文中的公式编辑
- 在线教育内容的公式提取
- 技术文档中的数学表达式处理
- 教育工作者制作教学材料
### 2. 文本提取 - 精准OCR识别
**技术特点**:
- 高精度OCR文字识别
- 支持多语言文本检测
- 智能文本排版保持
- 一键复制到剪贴板
**实际价值**:
- 快速提取PDF、图像中的文字内容
- 避免手动输入的繁琐和错误
- 支持多语言混合识别
- 大幅提升信息处理效率
### 3. 表格转换 - 数据处理神器
**核心能力**:
- 自动识别图像中的表格结构
- 转换为Markdown格式
- 保持原有的行列关系
- 支持复杂表格布局
**商业应用**:
- 财务报表数据分析
- 调研数据快速整理
- 技术文档表格提取
- 数据库导入预处理
### 4. 图像分析 - 智能视觉理解
**分析维度**:
- 图像内容智能描述
- 关键元素识别和标注
- 场景和物体检测
- 颜色和风格分析
**使用价值**:
- 产品设计灵感收集
- 竞品分析报告制作
- 艺术作品风格研究
- 技术文档图像说明
### 5. 问题求解 - AI智能助手
**智能能力**:
- 复杂问题模式识别
- 多步骤推理分析
- 解决方案生成
- 最佳实践建议
**适用领域**:
- 数学、物理题目解答
- 逻辑推理问题分析
- 编程题目思路梳理
- 日常生活问题解决
### 6. 代码理解 - 开发者的福音
**核心功能**:
- 多语言代码片段识别
- 代码逻辑自动解释
- 函数和变量分析
- 代码优化建议
**开发者价值**:
- 快速理解陌生代码逻辑
- 代码审查和调试辅助
- 学习和研究代码示例
- 技术分享内容制作
### 7. 颜色检测 - 设计与开发的桥梁
**技术实现**:
- 提取图像主要颜色
- 生成色彩调色板
- RGB/HEX值精确输出
- 颜色搭配建议
**应用场景**:
- UI/UX设计颜色分析
- 品牌色彩研究
- 艺术作品色彩提取
- 配色方案设计参考
### 8. 语言翻译 - 打破语言壁垒
**翻译特性**:
- 多语言自动检测
- 实时翻译显示
- 保持原文格式
- 上下文理解准确
**实用价值**:
- 外文文档快速理解
- 多语言界面翻译
- 学术论文跨语言处理
- 国际交流辅助工具
## 技术创新与优势
### 1. AI算法集成
Snippai集成了多种先进的AI算法:
- **计算机视觉**:用于图像分析和内容识别
- **自然语言处理**:实现文本提取和理解
- **机器学习**:提供智能问题求解能力
- **深度学习**:支持复杂模式识别
### 2. 用户体验设计
- **一键操作**:简单直观的截图到分析流程
- **实时处理**:快速响应用户操作需求
- **多格式支持**:输出多种常用格式
- **界面友好**:现代化的设计语言
### 3. 性能优化
- **本地处理**:保护用户隐私安全
- **高效算法**:优化的AI模型推理
- **内存管理**:轻量级资源占用
- **跨平台兼容**:支持多种操作系统
## 应用场景与案例
### 学术研究领域
**论文写作**:
- 快速提取文献中的数学公式
- 识别和转换图表数据
- 提取参考文献表格信息
- 分析图表中的关键信息
**教学辅助**:
- 制作教学PPT的素材提取
- 学生作业中的图表分析
- 在线课程的视觉内容处理
- 学术会议的图片资料整理
### 商业应用场景
**市场分析**:
- 竞品功能截图分析
- 用户界面设计研究
- 行业报告图表提取
- 商业模式画布分析
**内容创作**:
- 社交媒体内容制作
- 博客文章的配图处理
- 视频制作中的素材提取
- 营销材料的视觉分析
### 日常使用价值
**信息处理**:
- PDF文档文字提取
- 网页截图内容分析
- 会议记录图片处理
- 学习资料整理
**效率提升**:
- 减少重复性输入工作
- 提高信息获取速度
- 简化复杂操作流程
- 增强工作流自动化
## 安装与使用指南
### 系统要求
- **操作系统**:Windows 10/11, macOS 10.15+, Linux
- **内存**:建议4GB以上
- **存储**:500MB可用空间
- **网络**:首次使用需要网络连接
### 下载安装
1. **访问GitHub releases页面**:[https://github.com/xyTom/snippai/releases](https://github.com/xyTom/snippai/releases)
2. **选择适合的系统版本**
3. **下载对应安装包**
4. **按照安装向导完成安装**
### 基本使用
1. **启动应用**:双击Snippai图标
2. **选择截图区域**:拖拽选择屏幕区域
3. **选择分析功能**:根据需求选择对应AI功能
4. **获取结果**:查看AI分析结果并可选择导出
### 高级功能
- **批量处理**:支持多张图片连续处理
- **结果导出**:支持多种格式导出
- **历史记录**:保存处理历史便于查找
- **快捷键设置**:自定义常用操作快捷键
## 未来发展路线图
### 短期计划 (3-6个月)
**功能增强**:
- 提升OCR识别准确率
- 增加更多语言支持
- 优化用户体验界面
- 增强错误处理机制
**性能优化**:
- 加速AI模型推理速度
- 减少内存和CPU占用
- 改善启动和响应时间
- 提升大批量处理能力
### 中期目标 (6-12个月)
**新功能开发**:
- 手写文字识别
- 语音转文字功能
- 多文件格式支持
- 云端同步服务
**平台扩展**:
- 移动端应用开发
- 浏览器插件版本
- API服务开放
- 第三方集成支持
### 长期愿景 (1-2年)
**生态系统建设**:
- 开发者社区平台
- 插件市场机制
- 企业版服务
- 教育机构合作
**技术前沿探索**:
- 多模态AI能力增强
- 实时协作功能
- 私有化部署方案
- 行业定制化解决方案
## 结语:AI时代的截图革命
Snippai不仅仅是一个截图工具,更是AI技术在日常工作中应用的一个成功范例。它展示了如何将复杂的人工智能能力包装成简单易用的产品,让每个普通用户都能享受到AI技术带来的便利和效率提升。
正如项目的口号"**Snip Anything, Solve Everything**"所表达的愿景,Snippai正在重新定义我们对截图工具的认知,从简单的图像捕获工具进化为智能的解决方案平台。
在开源精神的推动下,Snippai汇聚了全球开发者的智慧和贡献,创造了一个真正有价值的AI工具。它不仅解决了用户的实际需求,更为AI技术的普及和应用树立了典范。
展望未来,Snippai还有巨大的发展潜力。随着AI技术的不断进步和社区的持续贡献,我们有理由相信,这个项目将继续引领智能截图工具的发展方向,为更多的用户带来价值。
让我们一起期待Snippai的下一个版本,也欢迎更多的开发者加入这个激动人心的开源项目,共同创造AI驱动的美好未来!
---
## 相关链接
- **项目地址**:[https://github.com/xyTom/snippai](https://github.com/xyTom/snippai)
- **官方网站**:[https://snippai.de/](https://snippai.de/)
- **下载页面**:[https://github.com/xyTom/snippai/releases](https://github.com/xyTom/snippai/releases)
- **问题反馈**:[https://github.com/xyTom/snippai/issues](https://github.com/xyTom/snippai/issues)
---
*本文旨在全面介绍Snippai项目的功能特点和技术优势,如果您对项目有任何问题或建议,欢迎通过GitHub参与讨论和贡献。让我们一起推动开源AI工具的发展!*
# Snippai:AI驱动的智能截图工具 - 重新定义你的截图体验
---
# TinyAuth - 简单易用的应用认证中间件
- Canonical: https://www.zeroxin.xin/2025/11/09/tinyauth-introduction/
- Markdown: https://www.zeroxin.xin/2025/11/09/tinyauth-introduction.md
- Published: 2025-11-09T09:00:00+08:00
- Updated: 2026-06-18T17:17:25+08:00
- Language: zh-CN
- Categories: 网络技术
- Tags: 开源项目, 认证, 中间件, OAuth
TinyAuth是一个轻量级的Go语言认证中间件,只需配置环境变量即可为任何Web应用添加登录保护。本文介绍其支持的认证方式(用户名密码、OAuth、LDAP)、兼容的代理服务器(Traefik、Nginx、Caddy)以及5分钟快速部署流程
在当今数字化时代,应用程序的安全性变得越来越重要。无论是个人自建的服务还是企业应用,都需要适当的身份验证机制来保护敏感数据。但是,传统的认证系统往往配置复杂、部署困难。今天,我要向大家介绍一个名为 **TinyAuth** 的开源项目,它以极简的设计理念,为我们提供了最简单的应用保护方案。
## 项目简介
TinyAuth 是一个轻量级的身份验证中间件,由 Go 语言开发。它最大的特点就是**简单** - 只需要环境变量配置,就能为你的应用添加登录保护。支持主流的代理服务器如 Traefik、Nginx 和 Caddy,让你可以轻松保护任何 Web 应用。
### 项目亮点
- **⭐ 5.8k+ GitHub Stars** - 社区认可度高
- **📦 极简设计** - 单文件静态链接,无额外依赖
- **🚀 快速部署** - 5分钟即可完成安装配置
- **🔒 多重认证** - 支持用户名密码、OAuth、LDAP
- **📱 现代化界面** - 响应式设计,支持深色模式
## 核心功能特性
### 1. 简单易用
TinyAuth 遵循"配置优于代码"的理念,通过环境变量即可完成所有配置。无需复杂的配置文件或数据库设置,开箱即用。
### 2. 轻量高效
- 单个静态链接二进制文件
- 内存占用极低
- 启动速度快
- 支持高并发
### 3. 灵活的认证方式
- **用户名密码认证** - 最基础的认证方式
- **OAuth 支持** - 可集成 Google、GitHub 等第三方登录
- **LDAP 集成** - 支持企业级目录服务
- **TOTP 两步验证** - 提供额外的安全层
### 4. 强大的代理服务器支持
- **Traefik** - 原生支持,自动集成
- **Nginx** - 通过中间件配置
- **Caddy** - 支持反向代理场景
- **Kubernetes** - 提供 Helm Chart
### 5. 多域名支持
支持主域名cookies设置,让认证状态在所有子域名间共享,非常适合多应用场景。
## 技术架构
### 后端技术栈
- **Go** (64.6%) - 高性能后端服务
- **SQLite** - 轻量级数据库,用于会话存储
- **GORM** - Go语言 ORM 框架
### 前端技术栈
- **TypeScript** (32.1%) - 类型安全的前端开发
- **React** - 现代化用户界面
- **响应式设计** - 适配各种设备
### 部署方式
- **Docker** - 容器化部署
- **Docker Compose** - 多服务编排
- **原生二进制** - 直接运行可执行文件
## 快速开始
### 在线演示
在深入了解之前,你可以先体验一下在线演示:
- **地址**: [demo.tinyauth.app](https://demo.tinyauth.app/)
- **用户名**: `user`
- **密码**: `password`
### Docker 部署示例
```yaml
version: '3.8'
services:
traefik:
image: traefik:v3.3
container_name: traefik
command: --api.insecure=true --providers.docker
restart: unless-stopped
ports:
- "80:80"
volumes:
- /var/run/docker.sock:/var/run/docker.sock
whoami:
image: traefik/whoami:latest
container_name: whoami
restart: unless-stopped
labels:
traefik.enable: true
traefik.http.routers.whoami.rule: Host(`whoami.example.com`)
traefik.http.routers.whoami.middlewares: tinyauth
tinyauth:
image: ghcr.io/steveiliop56/tinyauth:v4
container_name: tinyauth
restart: unless-stopped
environment:
- APP_URL=https://tinyauth.example.com
- USERS=user:$$2a$$10$$UdLYoJ5lgPsC0RKqYH/jMua7zIn0g9kPqWmhYayJYLaZQ/FTmH2/u
labels:
traefik.enable: true
traefik.http.routers.tinyauth.rule: Host(`tinyauth.example.com`)
traefik.http.middlewares.tinyauth.forwardauth.address: http://tinyauth:3000/api/auth/traefik
```
### 创建用户
使用 Docker CLI 创建用户:
```bash
docker run -i -t --rm ghcr.io/steveiliop56/tinyauth:v4 user create --interactive
```
这个命令会交互式地创建用户名和密码,并生成相应的配置。
## 配置选项
### 基础环境变量
| 变量名 | 描述 | 默认值 |
|--------|------|--------|
| `APP_URL` | 应用程序的完整URL | - |
| `USERS` | 用户配置(格式:用户名:bcrypt密码哈希) | - |
| `JWT_SECRET` | JWT签名密钥 | - |
| `SESSION_TIMEOUT` | 会话超时时间 | 24h |
### OAuth 配置
```bash
# Google OAuth
GOOGLE_CLIENT_ID=your_google_client_id
GOOGLE_CLIENT_SECRET=your_google_client_secret
# GitHub OAuth
GITHUB_CLIENT_ID=your_github_client_id
GITHUB_CLIENT_SECRET=your_github_client_secret
```
### LDAP 配置
```bash
LDAP_URL=ldap://your-ldap-server
LDAP_BASE_DN=dc=example,dc=com
LDAP_BIND_DN=cn=admin,dc=example,dc=com
LDAP_BIND_PASSWORD=your_bind_password
```
## 应用场景
### 1. 个人自建服务保护
如果你运行着各种个人服务(文件管理器、监控面板、开发工具等),TinyAuth可以快速为它们添加统一的认证保护。
### 2. 小团队内部工具
对于小团队来说,部署复杂的身份认证系统成本过高。TinyAuth提供了轻量级的解决方案。
### 3. 开发环境保护
在开发过程中,经常需要保护一些内部使用的工具和面板,避免意外暴露。
### 4. IoT 设备管理界面
为IoT设备的管理界面提供简单的身份验证,增强安全性。
## 社区与支持
### 官方资源
- **官网**: [tinyauth.app](https://tinyauth.app/)
- **文档**: [tinyauth.app/docs](https://tinyauth.app/docs/)
- **GitHub**: [steveiliop56/tinyauth](https://github.com/steveiliop56/tinyauth)
### 社区支持
- **Discord**: [官方Discord服务器](https://discord.gg/eHzVaCzRRd) - 活跃的社区讨论
- **社区教程**: Jim's Garage 提供了详细的使用教程
- **贡献指南**: 欢迎各种形式的贡献,包括代码、文档、翻译等
### 国际化支持
TinyAuth 支持多种语言,包括:
- 英语(默认)
- 芬兰语
- 中文
- 其他语言正在持续添加中
## 版本更新与维护
### 最新版本
- **当前版本**: v4.0.1
- **更新频率**: 活跃开发,频繁更新
- **版本管理**: 提供详细的变更日志
### 安全性
- 定期安全更新
- 活跃的漏洞修复
- 详细的安全策略文档
- 依赖项安全扫描
## 优缺点分析
### 优点
✅ **极简配置** - 只需环境变量,无需复杂配置
✅ **轻量级** - 资源消耗极低,适合边缘设备
✅ **多代理支持** - 兼容主流代理服务器
✅ **现代化UI** - 响应式设计,用户体验好
✅ **活跃社区** - 社区支持活跃,持续维护
✅ **多认证方式** - 支持本地、OAuth、LDAP等多种认证
### 限制
⚠️ **功能相对简单** - 不适合需要复杂权限管理的场景
⚠️ **单点故障** - 作为认证中心,需要保证高可用
⚠️ **域名要求** - 对域名配置有一定要求(需要使用子域名)
## 总结
TinyAuth 是一个设计精良的开源项目,它成功地将复杂的身份认证功能简化为几个环境变量的配置。无论是个人用户还是小团队,都能从中受益。
如果你正在寻找一个简单、轻量、易部署的身份认证解决方案,TinyAuth 绝对值得一试。它的开源特性、活跃的社区以及持续的维护更新,为用户提供了一个可靠的选择。
从 5.8k+ 的 GitHub Stars 和 178+ 的 forks 可以看出,TinyAuth 已经获得了广泛的社区认可。项目的持续活跃和频繁更新,也保证了其长期的可维护性。
---
**参考资料**:
- [TinyAuth 官方文档](https://tinyauth.app/docs)
- [GitHub 仓库](https://github.com/steveiliop56/tinyauth)
- [在线演示](https://demo.tinyauth.app/)
- [Docker Hub 镜像](https://hub.docker.com/r/steveiliop56/tinyauth)
---
# PDFMathTranslate:完整保留排版的专业PDF文档翻译工具
- Canonical: https://www.zeroxin.xin/2025/11/09/PDFMathTranslate%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D/
- Markdown: https://www.zeroxin.xin/2025/11/09/PDFMathTranslate%E9%A1%B9%E7%9B%AE%E4%BB%8B%E7%BB%8D.md
- Published: 2025-11-09T00:00:00+08:00
- Updated: 2026-06-18T17:21:44+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, AI工具, 人工智能, 文档翻译, PDF处理
PDFMathTranslate是一个专注于数学和科学文档的PDF翻译工具,能够精准识别和处理LaTeX公式、数学符号、图表等复杂排版元素。本文介绍其OCR识别引擎、公式保持翻译技术、多语言支持以及为学术研究者提供的跨语言文献阅读解决方案
## 前言
在全球化科研环境中,语言障碍往往成为科学知识传播的重要阻碍。传统的PDF文档翻译工具在处理科技文献时,常常无法保持原始的版式布局、公式格式和图表结构,这在很大程度上影响了翻译文档的可用性和专业性。今天,我将为大家介绍一个革命性的开源项目——**PDFMathTranslate**,它完美解决了这一痛点。
## 项目概述
**PDFMathTranslate** 是由Byaidu团队开发的世界上第一个能在翻译科学文档的同时完整保留版式布局的开源软件。该项目已在2025年EMNLP(自然语言处理实证方法会议)系统演示论文中被正式接收,展现了其在学术界的认可度。
### 项目亮点数据
- **GitHub Stars**: 29.7k ⭐
- **Forks**: 2.6k
- **下载量**: 超过22万次
- **贡献者**: 52位开发者
- **支持语言**: 多语言界面(中文、英文、日文、韩文等)
- **技术栈**: 98.8% Python开发
## 核心功能特性
### 1. 🏗️ 完整的版式保留
PDFMathTranslate最大的特色就是能够在翻译过程中完整保留原始文档的版式结构:
- **数学公式完整保留**: LaTeX公式无缝翻译,保持数学表达式的准确性
- **图表和表格**: 图表、表格、目录结构完全保持原样
- **注释和标记**: 保持原文的注释、高亮等标记信息
- **跨栏布局**: 专业的多栏文档布局得到完美保持
### 2. 🌍 多语言多服务支持
项目支持多种翻译服务和语言组合:
**翻译服务**:
- Google Translate(默认)
- DeepL
- OpenAI GPT系列
- Ollama本地模型
- 其他主流翻译API
**目标语言**:
- 中文(简体/繁体)
- 英语
- 日语
- 韩语
- 俄语
- 其他主要语言
### 3. 🚀 多种使用方式
#### 在线服务(推荐)
- **官方网站**: [pdf2zh.com](https://pdf2zh.com/) - 免费在线使用
- **HuggingFace演示**: 无需安装即可体验
- **ModelScope平台**: 阿里云机器学习平台托管版本
#### 本地部署
```bash
# 使用pip安装
pip install uv
uv tool install --python 3.12 pdf2zh
# 翻译文档
pdf2zh document.pdf
```
#### 图形化界面
```bash
# 启动GUI模式
pdf2zh -i
```
#### Docker部署
```bash
# 使用Docker运行
docker run -p 7860:7860 byaidu/pdf2zh
```
#### Zotero插件
作为文献管理工具Zotero的插件,无缝集成学术工作流。
## 技术架构深度解析
### 核心技术栈
1. **文档解析**:
- Pdfminer.six: PDF内容提取
- PyMuPDF: 文档处理和合并
- MinerU: 高级文档提取
2. **布局检测**:
- DocLayout-YOLO: 精确的文档布局识别
- 自定义布局分析算法
3. **翻译引擎**:
- 大语言模型集成
- 多线程翻译处理
- 缓存机制优化
4. **用户界面**:
- Gradio: 现代化Web界面
- CLI: 命令行工具
- MCP协议支持
### 工作流程
1. **文档解析**: 使用Pdfminer.six和PyMuPDF提取PDF内容和结构
2. **布局分析**: DocLayout-YOLO识别页面布局、表格、图表位置
3. **内容分类**: 区分文本、公式、图表等不同类型内容
4. **智能翻译**: 根据内容类型选择最适合的翻译策略
5. **版式重建**: 在目标语言中重新构建与原文相同的布局
6. **质量优化**: 多线程处理和缓存机制提升效率
## 高级功能特性
### 批量处理
```bash
# 批量翻译目录
pdf2zh --dir /path/to/documents/
```
### 自定义配置
```bash
# 使用配置文件
pdf2zh --config config.json document.pdf
# 自定义翻译提示
pdf2zh --prompt custom_prompt.txt document.pdf
```
### API接口支持
项目提供完整的API接口,支持二次开发:
- **Python API**: 在其他Python程序中调用
- **HTTP API**: 远程服务器调用
- **MCP协议**: 标准化通信协议
### 实验性功能
1. **BabelDOC后端**: 集成最新的BabelDOC翻译引擎
2. **ONNX模型支持**: 自定义DocLayout-YOLO模型
3. **双语文档生成**: 同时生成原文和译文对照版本
## 实际应用场景
### 1. 学术研究
- **文献翻译**: 快速理解外语科研论文
- **跨语言合作**: 促进国际学术交流
- **知识传播**: 让先进科研成果跨越语言障碍
### 2. 教育领域
- **教材本地化**: 将国外优秀教材翻译为中文
- **学术资源**: 为学生提供多语言学习材料
- **课程国际化**: 支持多语言教学环境
### 3. 企业应用
- **技术文档**: 翻译产品技术文档
- **研究报告**: 翻译市场研究和分析报告
- **合规文档**: 处理多语言合规要求
## 项目生态与发展
### 社区贡献
- **52位贡献者**: 来自全球的开发者和研究者
- **开源协议**: AGPL-3.0开源协议
- **多语言支持**: 完善的国际化支持
### 技术创新
- **首次实现**: 世界首个保留版式的PDF翻译工具
- **学术认可**: EMNLP 2025会议论文接收
- **社区驱动**: 基于社区反馈持续改进
### 未来发展
项目正在开发2.0版本,将包含:
- **性能优化**: 更快的处理速度
- **功能增强**: 更多高级特性
- **用户体验**: 更友好的界面设计
- **平台扩展**: 支持更多操作系统和平台
## 性能与质量保证
### 处理效率
- **多线程翻译**: 显著提升翻译速度
- **智能缓存**: 避免重复翻译相同内容
- **内存优化**: 支持大文档处理
### 翻译质量
- **上下文理解**: 保持翻译的上下文连贯性
- **术语一致性**: 专业术语翻译的一致性保证
- **格式保持**: 100%保持原始格式
## 安装与使用指南
### 系统要求
- **Python版本**: 3.10 - 3.12
- **操作系统**: Windows, macOS, Linux
- **内存建议**: 4GB以上
- **存储空间**: 2GB可用空间
### 快速开始
1. **安装Python环境**
```bash
# 推荐使用uv包管理器
pip install uv
```
2. **安装PDFMathTranslate**
```bash
uv tool install --python 3.12 pdf2zh
```
3. **开始翻译**
```bash
# 基本翻译
pdf2zh your_document.pdf
# 图形界面
pdf2zh -i
# 指定翻译服务
pdf2zh -s deepl your_document.pdf
```
### 常用参数
| 参数 | 说明 | 示例 |
|------|------|------|
| `-i` | 启动GUI界面 | `pdf2zh -i` |
| `-s` | 选择翻译服务 | `pdf2zh -s openai` |
| `-t` | 设置线程数 | `pdf2zh -t 4` |
| `-o` | 指定输出目录 | `pdf2zh -o output/` |
| `-li` | 源语言 | `pdf2zh -li en` |
| `-lo` | 目标语言 | `pdf2zh -lo zh` |
| `--dir` | 批量翻译目录 | `pdf2zh --dir ./docs/` |
## 项目影响力
### 学术界影响
- **论文发表**: EMNLP 2025系统演示论文
- **研究引用**: 被多个研究项目引用
- **学术合作**: 与多所大学和研究机构合作
### 产业应用
- **企业采用**: 多家科技公司内部使用
- **创业项目**: 催生了多个相关创业项目
- **技术标准**: 推动了PDF翻译工具的技术标准
### 社区建设
- **开源贡献**: 积极的开源社区生态
- **文档完善**: 详细的使用文档和API文档
- **技术支持**: 活跃的技术交流群组
## 总结
PDFMathTranslate作为一个革命性的开源项目,成功解决了科学文档翻译中长期存在的版式保持问题。它不仅在技术上实现了重大突破,更为全球科研工作者和教育工作者提供了强有力的工具。
该项目的成功体现了开源社区的创新力量,通过52位贡献者的共同努力,创造了超过22万次下载的成果。其在EMNLP 2025的正式接收,更是对项目技术价值和应用前景的权威认可。
随着AI技术的不断发展和全球科研合作的日益深入,PDFMathTranslate将继续发挥重要作用,帮助更多的知识跨越语言障碍,促进全球科学技术的交流与发展。
对于科研工作者、学生、技术人员来说,这无疑是一个值得收藏和使用的强大工具。无论是进行学术研究、教育教学,还是企业文档处理,PDFMathTranslate都能提供专业、高效、可靠的解决方案。
---
**相关链接**:
- GitHub仓库: [https://github.com/Byaidu/PDFMathTranslate](https://github.com/Byaidu/PDFMathTranslate)
- 在线服务: [https://pdf2zh.com](https://pdf2zh.com)
- EMNLP 2025论文: [https://aclanthology.org/2025.emnlp-demos.71/](https://aclanthology.org/2025.emnlp-demos.71/)
**标签**: #PDF翻译 #开源项目 #人工智能 #科研工具 #文档处理 #EMNLP2025
---
# Linux启动过程:从电源按钮到内核
- Canonical: https://www.zeroxin.xin/2025/11/09/linux-boot-process/
- Markdown: https://www.zeroxin.xin/2025/11/09/linux-boot-process.md
- Published: 2025-11-09T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Categories: 系统技术
- Tags: Linux, 系统, 启动过程, 操作系统, 内核
完整解析Linux系统从按下电源按钮到内核初始化的全过程,涵盖BIOS/UEFI引导流程、Bootloader(GRUB)工作原理、内核解压与初始化、根文件系统挂载以及systemd启动第一个用户空间进程的技术细节,深入理解操作系统启动的每一个关键环节
> 原文地址:[The Linux Boot Process: From Power Button to Kernel](https://www.0xkato.xyz/linux-boot/)
>
> 作者:0xkato
> 本文为中文翻译版本,旨在分享这篇优秀的Linux启动过程技术文章。
## 引言
你按下电源按钮。一秒钟后,一墙文本滚过,或是一个logo淡入,最终Linux出现了。其间发生的事情并非魔法。这是tiny程序和一个非常 literal 的CPU之间的精心握手。这部分将追踪这个握手过程,直到Linux内核内部的第一行C代码运行。
## 第一部分 — 从电源按钮到内核的第一次呼吸
### 最早的指令
当电源稳定时,CPU将自己重置为一个称为实模式的小型、老式的模式。实模式可以追溯到最初的8086芯片。规则设计得很简单。内存地址由CPU保存在称为寄存器的特殊快速存储中的两个值构建。你这样组合段和偏移量:
```
physical_address = (segment << 4) + offset
```
如果你看到像`0xFFFFFFF0`这样的数字,那是十六进制。Hex是16进制。我们写`0x`在前面来明确这一点。`0x10`是日常计数中的16。`0x100000`是1兆字节。十六进制与硬件如何存储位很好地对齐,这就是为什么你在低级代码中到处看到它的原因。
复位后,CPU跳转到称为复位向量的特殊地址`0xFFFFFFF0`。把它想象成一个永久书签,说"从这里开始"。在那个地址几乎没有空间,所以制造商在那里放了一个远(长)跳转,将控制权传递给主板上的固件。
小解释:寄存器
寄存器是CPU内部的一个小槽。它保存CPU正在使用的数字。像CS和IP这样的名称是寄存器名称。CS意思是"代码段",标记指令的当前邻域。IP意思是"指令指针",标记接下来要执行哪条指令。
### BIOS和UEFI
固件是烘焙在你主板上的一个小启动程序。
BIOS代表基本输入输出系统。它是较旧的样式。BIOS执行一个称为POST的快速健康检查,查看启动顺序,并尝试每个设备。如果它找到其第一个512字节扇区以标记字节`0x55`和`0xAA`结尾的磁盘,它将该设备视为可启动。BIOS将该扇区复制到内存中`0x7C00`并跳转到那里。那个扇区很小,所以它通常只知道如何加载下一个更大的片段。
UEFI是现代替代品。它仍然启动机器,但直接理解文件系统,并可以加载更大的引导程序,而不需要旧的"第一扇区"舞蹈。UEFI还向操作系统传递更丰富的信息。不同的路径,相同的目标:将控制权交给能够加载Linux的引导程序。
### 认识引导加载程序
引导加载程序是让操作系统就位的引导员。GRUB是PC上的流行选择。它读取其配置,如果你安装了一个会显示菜单,并将Linux内核加载到内存中。Linux内核文件实际上包含两样东西:
• 一个仍然在实模式下运行的小设置程序
• 稍后将被解压缩的较大的压缩内核
GRUB还填充了一个称为设置头的小结构,包含有用的事实:
它将内核放在哪里,命令行在哪里,如果有initrd的话它在哪里。然后它跳转到设置程序。
### 设置程序创建一个安全的空间
在任何Linux可以做任何有趣的事情之前,设置代码创建一个可预测的工作空间。
它对齐段寄存器,使得内存复制每次都以相同的方式进行。你在这里会看到的名称是CS表示代码,DS表示数据,SS表示栈。它还清除一个称为"方向标志"的单个CPU位,以便复制指令向前通过内存移动。
它创建一个栈。栈是一个后进先出的工作台,函数在其中存储临时值。SS表示栈使用哪个段。SP是栈当前顶部的指针。
它清除一个称为BSS的区域。BSS是必须以零开始的全局变量所在的地方。C代码假设BSS为零。设置程序将零写入整个跨度以保持这个承诺。
如果你在内核命令行上传入了`earlyprintk`,设置代码还会对串行端口进行编程,这样它就可以打印非常早期的消息。这在图形尚未准备就绪时很有用。
最后,设置程序询问固件"我们实际上有多少可用RAM以及空洞在哪里。"在旧BIOS上,这是一个人们经常昵称为e820的调用,它返回一个简单的可用和保留范围列表。内核将使用该列表避免踩到固界的脚趾。
完成后,设置代码调用其第一个C函数 literally 名为`main`。我们仍然在小的旧实模式中。下一步工作是离开它。
小解释:中断
中断是硬件或软件的"打扰一下",暂停CPU正在做的事情并为紧急事情运行一个小处理程序。定时器tick是一个中断。键击是一个中断。这里有两种风格。可屏蔽中断遵循你的规则,可以被临时阻止,以便它们在关键时刻不触发。非屏蔽中断,通常称为NMI,总是切入,因为它们通常报告严重的硬件问题。我们将在切换模式时控制两者,这样就不会有东西在半路上让我们惊讶。
## 第二部分 — 离开实模式,穿越32位土地,到达64位
现代Linux在PC上以长模式运行,即x86_64的64位模式。你不能从实模式直接跳转到那里。路径是实模式到保护模式,然后保护模式到长模式。这部分涵盖那条路径并解释沿途的词汇。
### 保护模式,没有术语迷雾
保护模式是1980年代引入的32位世界,用于超越当时的限制。它添加了两个核心思想。
全局描述符表或GDT是一个短描述符列表。一个描述说"这个段从这里开始,覆盖这么多,并被允许做这些事情。"Linux保持这个简单。它使用平面模型,这意味着基址为零,大小覆盖整个32位空间。当一切都平坦时,地址看起来像普通数字一样。
中断描述符表或IDT是"紧急呼叫电话号码"的目录。如果中断到达,CPU在IDT中查找条目并跳转到列出的处理程序。在切换期间,我们加载一个小的占位符IDT,因为我们即将阻止中断。全功能IDT稍后会到达,一旦真正的内核负责。
### 小心的切换
设置代码首先关闭嘈杂的部分。它用一条指令禁用可屏蔽中断。它使旧的PIC芯片安静下来,这样硬件中断在瞬间被完全阻塞。它打开A20行。这是一个历史遗留问题。早期PC使得地址在1兆字节处环绕。打开A20移除那个环绕,所以更高的地址按你期望的方式工作。它重置数学协处理器,使浮点状态干净。
然后它加载一个只有我们现在需要的小GDT和一个小IDT。最后它在称为CR0的控制寄存器中设置一个称为PE的单个位并执行远跳转。该跳转从GDT重新加载代码段并锁定保护模式。它重新加载数据段和栈段,并修复栈指针以匹配新的平面世界。
我们现在处于32位保护模式。
小解释:控制寄存器
CPU有一些特殊的开/关开关寄存器。CR0打开保护模式。CR3保存页表顶部的地址,我们马上就会需要。CR4启用更大的页表条目等扩展功能集。
### 为什么我们仍然没有完成
Linux想要64位。那是长模式。需要两样东西。
分页必须打开。分页是虚拟地址和物理地址之间的转换器。程序使用虚拟地址。硬件读取和写入物理内存。页表以称为页的固定大小块将一个映射到另一个。在PC上,正常页面是4KB。还有更大的页面。启动早期,内核使用2兆字节页面快速描述低内存。
在称为EFER的特殊寄存器中必须设置一个称为LME的单个位以允许长模式。EFER是型号特定寄存器,这是一种说"用于某些CPU功能的寄存器"的优雅方式。
### 构建足够的分页
32位序言构建一个小的页表集,说"对于这个区域,虚拟等于物理。"这称为身份映射。足以安全地打开分页。
为了使这工作,代码在CR4中启用PAE以使用更大的条目。它构建覆盖低内存2兆字节块的最小表集。它将顶层表的地址写入CR3。分页现在已准备就绪。
最后它在EFER中设置LME并执行远返回到一个写为64位代码的标签。长模式现在处于活动状态。段仍然是"平坦的",但地址和寄存器是64位宽。
为什么所有额外的小心
在运行系统切换模式就像在滚动时更换轮胎一样。代码阻止中断,准备所需的最小表,翻转位,然后才邀请中断返回。慢而稳阻止了奇怪的半切换状态。
## 第三部分 — 解压真实内核,修复地址,以及为什么Linux有时会移动自己
我们有一个64位CPU,分页打开,内存中有一个压缩内核。现在小的64位存根做实际工作:如果需要就离开,解压内核,如果内核不在其默认位置就修复地址,然后跳转。
### 清理路径并设置安全网
存根首先弄清楚它实际在哪里运行。早期代码被链接为好像它住在地址零,然后在运行时计算其真实基址。如果解压缩内核的计划目标位置会与存根重叠,它将自己复制到安全地方。
它清除自己的BSS,以便全局状态从干净开始。
它用两个处理程序加载一个最小IDT。一个用于页面错误,一个用于NMI。当CPU无法找到它刚刚尝试使用的虚拟地址的映射时,会发生页面错误。在我们的早期身份映射世界中,小页面错误处理程序可以动态添加缺失的映射并继续。NMI处理程序在那里,这样当我们在启动时,NMI不会使机器崩溃。
它还为其下一步将触及的区域构建身份映射。这包括内核的未来家园、引导加载程序填充的小引导参数页面和命令行缓冲区。
### 解压Linux…
通常名为`extract_kernel`的C函数接管。它为临时缓冲区设置一个小堆,打印经典行,并使用内核构建时使用的任何算法解压缩内核。gzip、xz、zstd、lzo和其他都插入到同一个包装器中。
当字节出来后,解压器读取内核的ELF头。ELF是Executable and Linkable Format的缩写,既是文件格式也是地图。它说哪些块是代码,哪些是数据,以及每个块确切地想要住在哪里。解压器将每个块复制到它所属的地方。
如果内核被加载到与它构建的地址不同的地址,解压器应用重定位。重定位是一个小的修复,调整包含地址的指针或指令。解压器遍历这些的列表并修补每个地方,以便它指向我们在地址空间中实际使用的正确位置。
当一切都到位时,解压器返回真正内核的入口点并跳转,将指向引导参数的指针传递过去。从那一刻起你就处于完整内核中了。你遇到的第一个函数是`start_kernel`,大的初始化开始了。
### 为什么内核有时会故意移动自己
你可能在内核日志中看到kASLR提到。那是内核地址空间布局随机化。想法很简单。如果攻击者不知道内核在内存中住在哪里,某些攻击就变得困难得多。
在启动早期,如果kASLR启用,解压器随机选择两个"基址":
• 物理基址,即字节在RAM中住的地方
• 虚拟基址,即一旦完整分页设置好内核将使用的起始虚拟地址
它如何在不破坏任何东西的情况下选择
它构建一个不要触摸列表。这包括解压器本身、压缩图像、initial ramdisk、引导参数页面和命令行缓冲区。它还可以包括你用命令行上的`memmap=`选项保留的范围。
它从固件扫描内存映射以找到大空闲区域。对于每个空闲区域,它计算有多少对齐的"槽"适合正确的大小。它使用它拥有的最佳早期熵源绘制随机数。在现代CPU上可能是硬件随机指令。它将数字减少到槽的总数并选择匹配的槽。那成为物理基址。虚拟基址以相同方式选择,但在内核的虚拟地址窗口内。
如果不存在合适的东西,代码回退到默认地址并打印小警告。如果你在命令行上传入`nokaslr`,设计会跳过随机化步骤。
## 快速词汇表
**十六进制**:用`0x`书写的16进制数字。`0x10`是16。`0x100000`是1兆字节。十六进制与位映射清洁,这就是低级代码使用它的原因。
**寄存器**:CPU内部保存当前数字的小槽。例子:CS、DS、SS、IP、SP。
**段和偏移**:用于构建实模式地址的两部分。物理地址等于段乘以16加偏移。
**BIOS**:启动机器、检查硬件并将第一个引导扇区加载到内存的较旧固件。
**UEFI**:理解文件系统并直接加载更大引导程序的现代固件。
**引导加载程序**:将内核放入内存并将系统事实传递给它的引导员。GRUB是常见的一个。
**栈**:函数的后进先出工作台。SS选择其段。SP指向当前顶部。
**BSS**:必须以零开始的全局变量所在的内核区域。设置代码在C运行之前清除它。
**中断**:来自硬件或软件的快速"打扰一下"。CPU暂停,运行小处理程序,然后恢复。可屏蔽中断可以被阻止片刻。NMI不能。
**GDT**:全局描述符表。段描述符的短列表。Linux将其设置为简单平面模型。
**IDT**:中断描述符表。处理程序的中断目录。早期引导使用最小的一个。真正的内核稍后安装真正的。
**A20行**:必须打开以在旧PC上正确寻址1兆字节以上地址的历史开关。
**保护模式**:引入GDT和IDT并允许分页的32位模式。
**长模式**:x86_64上的64位模式。需要分页和在EFER寄存器中设置名为LME的位。
**分页**:从虚拟地址到物理内存的转换器。用页表实现。
**页表**:将虚拟页面映射到物理页面的数据结构。早期引导使用身份映射。正常页面是4KB。早期引导经常使用2MB页面快速覆盖区域。
**CR0、CR3、CR4**:控制寄存器。CR0打开保护模式。CR3指向页表顶部。CR4启用PAE等扩展功能。
**EFER**:保存长模式启用以及其他位的型号特定寄存器。
**ELF**:内核的磁盘格式,带有内置的什么属于哪里的地图。
**重定位**:当代码加载到与其构建的基址不同的基址时调整地址的修复。
**kASLR**:在启动时随机化内核基址地址以使开发更加困难。
---
## 相关阅读
- [Linux进程内存友好之旅](https://www.0xkato.xyz/linux-process-memory/)
---
*本文为技术翻译文章,原始文章作者为0xkato,发表在0xkato.xyz上。翻译旨在学习和分享,如需查看原文请访问上述链接。*
---
# 自建 Docker Hub 加速镜像:Nginx 反向代理解决方案
- Canonical: https://www.zeroxin.xin/2025/11/09/self-hosted-docker-hub-mirror/
- Markdown: https://www.zeroxin.xin/2025/11/09/self-hosted-docker-hub-mirror.md
- Published: 2025-11-09T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: Linux, Docker, 网络技术, Nginx, VPS
详细介绍利用Nginx反向代理自建Docker Hub加速镜像的完整方案,解决国内Docker镜像拉取困难的问题。本文涵盖环境准备、Nginx配置、SSL证书设置、缓存优化以及生产环境部署的最佳实践,帮助开发者构建稳定可靠的私有镜像加速服务
## 前言
随着 Docker Hub 官方源被封锁,国内的镜像源也纷纷下架,现在国内企业和个人服务拉取镜像越来越困难。阿里云、腾讯云等镜像源已经只允许自家服务器使用,其他第三方源也存在稳定性和安全性问题。
所以,自建 Docker Hub 加速镜像就显得很有必要。最常见的做法是:用 Nginx 反向代理 Docker Hub 官方仓库,搭一个属于你自己的"加速入口"。
## 准备环境
> 以下是我的环境配置,主打便宜好用,可根据自身情况调整。
- **系统**:Debian / Ubuntu
- **域名**(可选):NameSilo 免备案、价格便宜(`.xyz`等冷门域名)。没有域名也可以使用自签证书启用 HTTPS
## 安装 Nginx
```bash
sudo apt update
sudo apt install nginx
```
## 开放端口
放行 HTTPS 端口(根据自己服务器情况开放端口,以 ufw 为例):
```bash
sudo ufw allow 443
```
## 配置 Nginx 反代 Docker Hub
创建新配置文件:
```bash
touch /etc/nginx/conf.d/dockerhub.conf
```
编辑配置文件:
```bash
nano /etc/nginx/conf.d/dockerhub.conf
```
将以下内容粘贴进去,把域名和证书路径改为你自己的,本文示例域名`your.domain.com`。如果还没证书,可以先用 [acme.sh](https://github.com/acmesh-official/acmesh.sh) 申请自动证书。
> 如果用的 NameSilo 的域名,可以参考 acme.sh 的 DNS API 自动申请SSL证书:[https://github.com/acmesh-official/acme.sh/wiki/dnsapi#35-use-namesilocom-api](https://github.com/acmesh-official/acme.sh/wiki/dnsapi#35-use-namesilocom-api)
```nginx
#反代docker hub镜像源
server {
listen 443 ssl;
server_name your.domain.com;
ssl_certificate /etc/nginx/ssl/your.domain.com.crt;
ssl_certificate_key /etc/nginx/ssl/your.domain.com.key;
ssl_session_timeout 24h;
ssl_protocols TLSv1.2 TLSv1.3;
# /v2/ → https://registry-1.docker.io
location /v2/ {
proxy_pass https://registry-1.docker.io; # Docker Hub 的官方镜像仓库
proxy_set_header Host registry-1.docker.io;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
# 关闭缓存
proxy_buffering off;
# 转发认证相关的头部
proxy_set_header Authorization $http_authorization;
proxy_pass_header Authorization;
# 重写 www-authenticate 头为你的反代地址
proxy_hide_header www-authenticate;
add_header www-authenticate 'Bearer realm="https://your.domain.com/token",service="registry.docker.io"' always;
# always 参数确保该头部在返回 401 错误时无论什么情况下都会被添加。
# 对 upstream 状态码检查,实现 error_page 错误重定向
proxy_intercept_errors on;
# error_page 指令默认只检查了第一次后端返回的状态码,开启后可以跟随多次重定向。
recursive_error_pages on;
# 根据状态码执行对应操作,以下为301、302、307状态码都会触发
error_page 301 302 307 = @handle_redirect;
}
# 处理 Docker OAuth2 Token 认证请求
# 把返回的 `WWW-Authenticate` 头改写为你的入口地址,保证客户端能在你这儿拿到 token。
# /token → https://auth.docker.io
location /token {
resolver 1.1.1.1 valid=600s;
proxy_pass https://auth.docker.io; # Docker 认证服务器
# 设置请求头,确保转发正确
proxy_set_header Host auth.docker.io;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
# 传递 Authorization 头信息,获取 Token
proxy_set_header Authorization $http_authorization;
proxy_pass_header Authorization;
# 禁用缓存
proxy_buffering off;
}
location @handle_redirect {
resolver 1.1.1.1;
set $saved_redirect_location '$upstream_http_location';
proxy_pass $saved_redirect_location;
}
}
```
保存退出(`Ctrl+O` → 回车 → `Ctrl+X`)。
## 重载加载 Nginx 配置
```bash
sudo nginx -s reload
```
如果没有报错说明配置生效。
## 配置 Docker 镜像源
你现在有一个新的私有镜像仓库:`https://your.domain.com`
接下来让 Docker 走这个仓库,而不是默认的 `https://registry-1.docker.io`。下面我分几种常见情况讲清楚该怎么做👇
### 一、临时使用(单次命令)
如果只是想临时从该仓库拉取镜像,例如:
```bash
docker pull your.domain.com/ubuntu:latest
```
或者运行:
```bash
docker run -it your.domain.com/ubuntu bash
```
这种方式不需要修改配置文件。但要注意:
- 镜像名前必须加上完整域名(`域名`)
- 若仓库未使用有效证书(自签名或内部 CA),还需要配置 Docker 信任
### 二、长期替换默认仓库(推荐)
如果你想让 Docker 默认就从新的仓库拉取镜像,可以通过以下两种方式配置:
#### 方式 1️⃣:修改 /etc/docker/daemon.json
编辑(或新建)文件:
```bash
sudo nano /etc/docker/daemon.json
```
加入以下内容(若已有其他字段请合并):
```json
{
"registry-mirrors": ["https://your.domain.com"]
}
```
然后执行:
```bash
sudo systemctl daemon-reload
sudo systemctl restart docker
```
验证:
```bash
docker info | grep -A1 "Registry Mirrors"
```
输出中应出现:
```
Registry Mirrors:
https://your.domain.com/
```
✅ 说明生效。
#### 方式 2️⃣:使用自定义私有仓库(带认证)
如果你的仓库需要登录(例如 Harbor、Nexus 等),可登录:
```bash
docker login your.domain.com
```
然后输入用户名密码。成功后会在 `~/.docker/config.json` 中保存凭据。
> 注意!如果利用反代服务器登录 docker hub 仓库,反代服务器是可以获取到你的账号密码的,所以请谨慎使用他人搭建的服务登录!如果没有拉取自己的私有仓库的镜像的需求,保持匿名拉取相对会安全一些。
### 三、如果是自签名证书(HTTPS)
若你的 `https://your.domain.com` 使用自签名证书(非 Let's Encrypt 等正规证书),Docker 会拒绝连接。
解决方法:
1. 创建目录:
```bash
sudo mkdir -p /etc/docker/certs.d/your.domain.com
```
2. 将证书(例如 `ca.crt`)复制进去:
```bash
sudo cp ca.crt /etc/docker/certs.d/your.domain.com/
```
3. 重启 Docker:
```bash
sudo systemctl restart docker
```
> 如果你没有证书,可以临时在 `daemon.json` 加上:
> ```json
> {"insecure-registries": ["your.domain.com"]}
> ```
> 但⚠️这只适合内网或测试环境,生产环境请务必使用 HTTPS 证书。
## 四、验证是否成功
用的临时方案则执行:
```bash
docker pull your.domain.com/library/hello-world
```
用的替换默认仓库方案则执行:
```bash
docker pull hello-world
```
拉取成功,你的加速镜像已经生效!
## 五、安全配置
目前你的 Nginx Docker Hub 镜像是搭建成功了,但默认是公开可访问的,任何人只要知道你的域名,都能用你的服务器中转 Docker Hub。如果被人滥用,会导致:
- 你的服务器带宽被占满
- Docker Hub 对你服务器的出口 IP 限速
- 甚至触发风控或账单暴涨
所以确实需要加一层访问控制,让只有你(或你的机器)能用。很多教程都忽略了这一点。
### IP 白名单限制(推荐小团队/个人)
最简单的办法就是IP 白名单限制, 在你的反代配置`/etc/nginx/conf.d/dockerhub.conf`里,只允许特定 IP 访问 `/v2/` 和 `/token`。
示例:
```nginx
location /v2/ {
allow 你的本地公网IP; # 比如 allow 123.45.67.89;
allow 你的公司出口IP; # 可写多个 allow
deny all; # 其他一律拒绝
...
}
location /token {
allow 你的本地公网IP;
allow 你的公司出口IP;
deny all;
...
}
```
> ✅ 优点:简单高效,无需额外配置
> ⚠️ 缺点:如果你经常换网络(如笔电或多地服务器),需要手动更新 IP
修改后重新加载 nginx 配置
```bash
nginx -s reload
```
好了,完事。
---
## 总结
通过本文的详细步骤,您可以成功搭建一个属于自己的 Docker Hub 加速镜像服务。这种方案相比使用公共镜像源有以下优势:
1. **稳定性**:不受公共镜像源服务质量影响
2. **安全性**:可以配置 IP 白名单,限制访问范围
3. **可控性**:完全掌控服务状态和配置
4. **性能优化**:选择距离用户更近的服务器节点
虽然搭建过程相对复杂,但一旦配置完成,就能为您的 Docker 镜像拉取提供稳定可靠的服务保障。
---
*本文转载自[技术好学屋](https://www.itblogcn.com/),原文地址:[自建 Docker Hub 加速镜像(Nginx 反向代理方案)](https://www.itblogcn.com/article/2702.html)*
---
# 5个systemd优化技巧大幅提升Linux启动速度
- Canonical: https://www.zeroxin.xin/2025/11/09/systemd-startup-optimization/
- Markdown: https://www.zeroxin.xin/2025/11/09/systemd-startup-optimization.md
- Published: 2025-11-09T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: Linux, systemd, 系统优化, 性能调优, 启动速度
分享5个实用的systemd优化技巧,包括使用systemd-analyze定位启动瓶颈、分析critical-chain依赖关系、禁用和屏蔽不必要服务、并行启动优化以及调整服务启动顺序,帮助显著提升Linux系统启动速度和整体性能,让你的Linux系统焕然一新
## 引言
并不是每个Linux用户都执着于系统启动速度的快慢,但我喜欢看到快速而清洁的启动过程。即使使用固态硬盘,启动过程中也可能会出现瓶颈并拖慢速度。[Systemd提供了各种工具](https://www.xda-developers.com/why-i-use-systemd-on-linux/)让你能够跟踪这些延迟发生的位置并解决它们。通过[一些调优](https://www.xda-developers.com/linux-command-line-tricks-everyone-should-know/),我能够在不牺牲稳定性的情况下,从启动过程中减去明显的时间。
这些优化的真正好处不仅仅是减少秒表上的数字。一个启动快速的系统感觉更响应灵敏,减少了你等待的时间。通过分析、禁用、屏蔽和微调服务,你可以创造一个更流畅的体验,完全符合你的需求。如果出现问题,这些更改很容易逆转,但一旦调好,它们往往会保持下去。对我来说,这些小胜利每天都在积累,回报是一个感觉像它应该一样快的Linux系统。
## 识别启动过程中的慢点
### 使用systemd-analyze跟踪启动性能
在加快速度之前,你需要知道是什么在拖慢速度。`systemd-analyze`命令显示内核和用户空间初始化需要多长时间,给你一个启动时间的大图景。将它与`systemd-analyze blame`配对使用,你会看到按启动时间长短排序的服务详细分解。这通常是真正罪魁祸首隐藏的地方,无论是一个配置错误的守护进程还是你从未实际使用的东西。
通过几次运行这个分析,你就能了解一致性与异常值之间的区别。一些服务可能偶尔会因为硬件检测而激增,而其他服务则持续较重。关注最严重的违规者将为你用最少的努力带来最大的改进。我通常在做出更改之前保存一份输出,这样我就可以客观地衡量进展。
### 使用systemd-analyze critical-chain分析依赖关系
值得使用的是`systemd-analyze critical-chain`,它显示依赖关系在启动序列中如何排列。阻止其他基本任务的服务是重新排序或禁用的主要候选者。有了这个工具,你就可以从猜测转向做出真正减少启动延迟的明智调整。
## 减少后台服务
### 禁用你实际不使用的服务
一旦你知道是什么在消耗时间,下一步就是削减脂肪。许多Linux发行版默认启用的服务并不是每个用户都需要。例如,打印机守护进程或蓝牙管理器经常在后台运行,即使在没有打印机或蓝牙硬件的机器上。禁用这些服务可以在启动期间释放宝贵的时间。
管理这个最简单的方法是使用`systemctl disable`后面跟服务名称。这可以防止它在启动时启动,同时仍然允许你在需要时手动启动它。对于你绝对确定永远不会使用的服务,`systemctl mask`更进一步,通过完全阻止它们。systemd必须启动的守护进程越少,你的机器就能越快达到可用状态。
> **提示**:当然,这需要一些小心。禁用关键的东西可能会破坏你依赖的功能,所以我建议一次更改一件事,并在每个调整后测试。在几天的时间里,你可以建立一个更精简、更快的启动配置文件,而不会破坏系统稳定性。
### 分析服务依赖关系
重要的是不要随意禁用服务。一定要仔细查看它们的作用以及什么其他服务可能依赖于它们。在开始调整之前备份你的PC绝对是个好主意。
## 利用systemd并行化
### 为更快的启动优化依赖关系
systemd相对于旧init系统的一个优势是它能够并行启动服务。不是等待每个守护进程加载后再启动下一个,而是同时启动独立的服务。这意味着你的CPU和磁盘得到更有效的利用,这自然加快了速度。关键是确保依赖关系正确定义,这样服务就不会不必要地相互阻塞。
你可以用`systemctl list-dependencies`检查依赖关系,或者直接查看单元文件。如果你注意到一个服务正在等待它实际上不需要的东西,你可以调整其配置。添加像`After=`或`Requires=`这样的指令可以让你微调一个服务相对于其他服务何时启动。删除不必要的依赖关系可以防止空闲等待,并更好地利用并行化。
### 使用套接字激活
另一个技巧是为某些服务启用套接字激活。通过套接字激活,systemd只在套接字被访问时启动守护进程,而不是在每次启动时。这不仅缩短了启动时间,还减少了后台资源使用。当正确调优时,你会得到一个感觉既更快又更轻的系统。
## 屏蔽导致慢速的服务
### 确保没有东西重新启用你屏蔽的服务
有时仅仅禁用一个服务是不够的,因为另一个包更新或依赖可能会重新启用它。屏蔽是更强的解决方案,因为它基本上将一个服务链接到`/dev/null`,这样它就不能被意外启动。这对你确知与你的设置无关的服务特别有用。一个很好的例子是与你选择的管理器冲突的网络守护进程。
要屏蔽一个服务,你使用`systemctl mask`后面跟单元名称。从那时起,即使另一个进程试图启动它,systemd也会拒绝。如果你改变主意,取消屏蔽就像`systemctl unmask`一样简单。它让你放心,不需要的服务不会悄悄回到你的启动序列中。
### 屏蔽前的依赖关系检查
问题是屏蔽错误的服务可能会造成混乱,特别是如果其他东西间接依赖于它。这就是为什么我总是在屏蔽前双重检查依赖关系树。当正确完成时,屏蔽确保你的系统随着时间的推移保持优化,即使通过更新也是如此。
## 改进桌面会话的启动方式
### 调整显示和登录管理器以提高速度
对于桌面用户,启动过程的最后一程通常是图形会话。[像GDM](https://www.xda-developers.com/mistakes-choosing-linux-distro-pc/)、LightDM或SDDM这样的显示管理器各自都有自己启动时间。调整它们或切换到更轻的一个可以产生明显的差异。例如,LightDM在普通硬件上往往比更重的替代品更快。
另一件要看的是会话设置中的自动启动应用程序。许多桌面环境默认启动小的帮助应用程序、更新器或云同步客户端。将这些减少到你实际使用的不仅让桌面加载更快,还减少了你登录后的混乱。这与应用禁用系统服务的原则相同,只是应用在用户层面。
### 优化多用户到图形目标的转换
你还可以尝试你的系统如何从多用户目标转换到图形目标。通过将某些服务延迟到桌面加载后开始,你优先考虑尽快达到可用会话。像这样的小调整往往会累积起来,将缓慢的启动变成明显更快的体验。
## 为什么systemd调优在日常使用中有回报
这些调整的真正好处不仅仅是减少秒表上的数字。一个启动快速的系统感觉更响应灵敏,减少了你等待的时间。通过分析、禁用、屏蔽和微调服务,你创造了一个更流畅的体验,完全符合你的需求。变化很容易逆转,但如果调好,它们往往会保持下去。对我来说,那些小胜利每天都在积累,回报是一个感觉像它应该一样快的Linux系统。
## 总结
通过系统地分析你的启动过程并应用这五个优化技巧——识别慢点、减少后台服务、利用并行化、屏蔽问题服务以及优化桌面会话启动——你可以显著改善你的Linux系统的启动体验。这些更改不仅能让你的系统启动更快,还能创造一个更响应、更高效的整体计算环境。
记住,关键是要逐步进行更改,仔细测试每个调整,并始终准备好在需要时回滚更改。通过一些耐心和实验,你可以实现一个快速、高效的启动过程,真正适合你的特定需求和使用模式。
---
## 常用命令参考
```bash
# 分析启动性能
systemd-analyze # 总体启动时间
systemd-analyze blame # 各服务启动时间
systemd-analyze critical-chain # 依赖关系链
# 管理服务
systemctl disable # 禁用服务
systemctl enable # 启用服务
systemctl mask # 屏蔽服务
systemctl unmask # 取消屏蔽
systemctl list-dependencies # 查看依赖关系
# 查看服务状态
systemctl status # 服务状态
systemctl is-enabled # 是否启用
systemctl is-active # 是否运行
```
---
**原文链接**: [5 systemd tweaks that really boost my boot time](https://www.xda-developers.com/systemd-tweaks-boost-boot-time/)
**翻译**: ZeroXin Blog
**发布日期**: 2025-11-09
*本文为技术转载文章,旨在为中文Linux用户提供systemd系统优化的实用指南。*
---
# X-CMD:云端赋能的现代化命令行工具集
- Canonical: https://www.zeroxin.xin/2025/11/09/x-cmd-introduction/
- Markdown: https://www.zeroxin.xin/2025/11/09/x-cmd-introduction.md
- Published: 2025-11-09T00:00:00+08:00
- Updated: 2026-06-18T17:21:27+08:00
- Language: zh-CN
- Categories: 开源项目
- Tags: 开源项目, AI工具, 开发工具, 命令行工具, CLI工具, 包管理器
X-CMD是一个云端赋能的现代化命令行工具集,提供统一的命令风格和按需加载体验。本文介绍其一体化设计理念、AI原生集成方案、跨平台兼容性以及如何解决传统CLI工具分散安装和环境管理的痛点问题,开启云端赋能命令行工具的全新体验
## 前言
在当今数字化时代,命令行工具仍然是开发者、系统管理员和技术爱好者不可或缺的利器。然而,传统的命令行工具生态存在诸多痛点:工具分散、安装复杂、环境管理繁琐、缺乏统一的用户体验。而今天要介绍的 **X-CMD** 项目,正是为了解决这些痛点而诞生的现代化命令行工具集。
## X-CMD 项目概述
**X-CMD**(读作"X Command")是一个小巧且功能强大的开源命令行工具集,由 Li Junhao (l@x-cmd.com) 主导开发。该项目采用 GNU AFFERO GENERAL PUBLIC LICENSE v3 开源协议,目前在 GitHub 上已获得 3.5k+ stars,显示出其在开源社区的受欢迎程度。
### 核心设计理念
X-CMD 的设计哲学基于几个核心原则:
- **一体化体验**:统一的命令风格和交互方式
- **按需加载**:避免工具冗余,提升系统性能
- **AI 原生**:将人工智能深度集成到命令行工作流
- **极简主义**:轻量级设计,快速响应
- **跨平台兼容**:支持多种操作系统和 Shell 环境
## 核心特性详解
### 1. ⚡ 一键启用 1000+ CLI 工具
X-CMD 最引人注目的特性之一是其强大的工具生态系统。通过内置的包管理器,用户可以:
- **按需下载**:无需预装众多工具,需要时一键获取
- **应用式启动**:像启动手机 App 一样启动命令行工具
- **统一管理**:所有工具通过统一的 `x` 命令进行管理
例如,常见的 JSON 处理工具 `jq` 可以通过以下方式使用:
- 直接使用:`x jq`
- 全局安装:`x env use jq` 后使用 `jq` 命令
- 临时使用:`x env try jq` 在当前会话中有效
### 2. 🧠 AI 加持的智能化体验
X-CMD 将人工智能深度集成到命令行环境中,提供多种 AI 能力:
#### AI 代理功能
- **x claude**:集成 Claude AI 助手
- **x codex**:代码生成和优化
- **x crush**:智能压缩和优化
#### AI 对话与任务
- **AI 聊天**:直接在终端中进行 AI 对话
- **AI 任务**:自动化的智能任务执行
- **AI 生成**:代码、文档、配置文件的智能生成
这种 AI 原生的设计理念,使 X-CMD 不仅仅是一个工具集合,更是一个智能化的命令行助手。
### 3. 🧩 开发环境管理
对于开发者而言,环境配置往往是令人头疼的问题。X-CMD 提供了完整的环境管理解决方案:
- **多语言支持**:Node.js、Python、Java、Go 等主流开发语言
- **版本管理**:轻松切换不同版本
- **依赖管理**:自动处理项目依赖关系
- **环境隔离**:避免不同项目间的环境冲突
### 4. 🛡️ 安全沙箱机制
在安全日益重要的今天,X-CMD 提供了多层次的安全保障:
- **权限控制沙箱**:细粒度的系统权限管理
- **Docker 隔离**:基于容器的安全隔离机制
- **安全执行**:在受控环境中运行可疑工具
这使得用户可以在安全的边界内测试和运行各种命令行工具,无需担心系统安全风险。
### 5. 🎨 终端美化与体验优化
X-CMD 不仅关注功能性,也非常注重用户体验:
- **主题系统**:内置多种终端主题和配色方案
- **字体管理**:自动安装和配置优化字体
- **导航优化**:智能路径导航和快速切换
- **命令补全**:原生的智能命令补全
- **TUI 交互**:直观的终端用户界面
### 6. 🗃️ Hub 功能
X-CMD 的 Hub 功能允许用户:
- **跨平台脚本执行**:在不同平台和 Shell 中运行托管脚本
- **容器支持**:在 Alpine、BusyBox 等极简容器中运行
- **即时执行**:无需本地安装即可执行远程脚本
### 7. 🪶 极致轻量化设计
X-CMD 的核心设计理念之一是轻量化:
- **核心包体积**:仅约 1.1 MB
- **快速启动**:加载时间控制在 100 ms 以内
- **按需加载**:避免不必要的内存占用
- **高效执行**:优化的执行引擎
## 主要功能模块
X-CMD 提供了丰富多样的功能模块,涵盖日常开发和运维的各个方面:
### 🤖 AI 与代理模块
- `x claude`:Claude AI 助手
- `x openai`:OpenAI GPT 集成
- `x gemini`:Google Gemini AI
- `x deepseek`:DeepSeek AI 模型
### 🖥️ 系统管理模块
- `x mac`:macOS 系统管理
- `x cd`:目录快速切换
- `x top`:系统进程监控
- `x ps`:进程查看与管理
### 📁 文件系统与存储
- `x zuz`:压缩解压工具
- `x ls`:增强的文件列表
- `x path`:路径管理工具
- `x df`:磁盘空间查看
### 🫙 Git 版本控制
- `x gh`:GitHub CLI 增强
- `x gt`:Git 工具集合
- `x gl`:Git 日志查看
- `x cb`:Git 分支管理
### 📦 包管理器
- `x env`:环境包管理
- `x install`:通用安装工具
- `x brew`:Homebrew 集成
- `x apt`:APT 包管理
## 安装与使用
### 安装方式
X-CMD 支持多种安装方式,适配不同的使用场景:
#### 1. 快速安装(推荐)
```bash
# 使用 curl
eval "$(curl https://get.x-cmd.com)"
# 使用 wget
eval "$(wget -O- https://get.x-cmd.com)"
```
#### 2. 包管理器安装
- **Homebrew**:`brew install x-cmd/tap/x-cmd`
- **AUR**(Arch Linux):`yay -S x-cmd`
- **APT**(Debian/Ubuntu):`sudo apt install x-cmd`
- **APK**(Alpine):`apk add x-cmd`
- **Pacman**(Arch):`pacman -S x-cmd`
- **DNF**(Fedora):`dnf install x-cmd`
#### 3. 平台特定安装
- **Linux/macOS**:完整支持
- **Windows**:通过 WSL 或 PowerShell
- **BSD**:FreeBSD、OpenBSD 等
### 基本使用
安装完成后,通过 `x` 命令即可开始使用:
```bash
# 查看帮助
x help
# 列出所有可用模块
x list
# 使用特定模块
x env # 包管理
x jq file.json # 直接使用 jq 工具
x claude # 启动 AI 助手
```
## 实际应用场景
### 1. 开发环境快速搭建
```bash
# 快速安装开发工具链
x env use node # 安装 Node.js
x env use python # 安装 Python
x env use go # 安装 Go
x env use docker # 安装 Docker
```
### 2. 日常运维任务
```bash
# 系统监控
x top # 查看系统负载
x ps # 查看进程信息
x df # 查看磁盘使用情况
# 网络诊断
x ping # 网络连通性测试
x curl # HTTP 请求工具
x ssh # SSH 客户端增强
```
### 3. AI 辅助开发
```bash
# AI 代码生成
x claude "帮我写一个 Python 脚本处理 JSON 数据"
# AI 代码审查
x codex review --file main.py
# AI 文档生成
x gemini generate --api-doc openapi.yaml
```
## 技术架构
### 核心设计
X-CMD 采用模块化架构设计:
1. **核心引擎**:负责命令解析、模块加载、生命周期管理
2. **模块系统**:可插拔的功能模块,每个模块负责特定功能
3. **包管理器**:统一的第三方工具管理机制
4. **AI 集成层**:与各种 AI 服务的集成接口
5. **安全沙箱**:权限控制和隔离执行环境
### 性能优化
- **懒加载机制**:模块按需加载,减少启动时间
- **缓存策略**:智能缓存常用工具和数据
- **并行处理**:多任务并行执行提升效率
- **内存优化**:精心优化的内存使用策略
## 社区与生态
### 开源社区
X-CMD 拥有活跃的开源社区:
- **GitHub 项目**:https://github.com/x-cmd/x-cmd
- **贡献者**:6 名核心维护者
- **版本发布**:93 个版本迭代
- **Issues/Discussions**:活跃的社区讨论
### 生态扩展
- **模块开发**:支持社区开发自定义模块
- **包收录**:第三方工具持续收录
- **集成能力**:与其他工具和平台的集成
- **文档完善**:持续完善的使用文档
## 优势与特色
### 相比传统方案的优势
1. **统一体验**:告别工具碎片化,享受一致的使用体验
2. **AI 集成**:原生 AI 能力,显著提升工作效率
3. **轻量高效**:极小的资源占用,快速的响应速度
4. **安全可控**:多层安全机制,安全地使用各种工具
5. **易于维护**:模块化设计,易于扩展和维护
### 创新亮点
1. **AI 原生设计**:不是简单集成 AI,而是在 AI 时代重新设计命令行体验
2. **按需生态**:摒弃传统的"大而全",采用"按需即用"的设计理念
3. **安全沙箱**:在享受便利的同时保障系统安全
4. **跨平台兼容**:真正实现"一次学习,终身使用"
## 未来展望
### 发展规划
基于项目的发展轨迹和社区反馈,X-CMD 的未来发展方向包括:
1. **更多 AI 能力**:集成更多 AI 模型和服务
2. **模块生态扩展**:持续增加新的功能模块
3. **企业级特性**:增加企业用户需要的高级功能
4. **云端协作**:增强云端脚本执行和协作能力
5. **移动端支持**:探索移动设备上的使用场景
### 社区愿景
X-CMD 致力于打造:
- **现代化命令行工具的标准**
- **AI 时代命令行工具的标杆**
- **开发者工作流的最佳伴侣**
- **开源社区协作的典范**
## 总结
X-CMD 代表了命令行工具发展的新方向,它不仅仅是一个工具集合,更是一种全新的命令行工作理念。通过将 AI 能力、现代化设计理念和传统命令行工具的实用性完美结合,X-CMD 为用户提供了前所未有的命令行体验。
无论你是开发者、系统管理员,还是命令行工具爱好者,X-CMD 都值得一试。它将改变你对命令行工具的认知,让你的工作更加高效、智能和愉悦。
在这个 AI 驱动的时代,X-CMD 无疑是命令行工具领域的一个重要里程碑,值得我们每个人关注和体验。
---
**项目信息**
- **GitHub 地址**:https://github.com/x-cmd/x-cmd
- **官方网站**:https://x-cmd.com/
- **开源协议**:GNU AGPL v3
- **开发语言**:Shell (100%)
- **社区支持**:GitHub Issues、Discussions
欢迎关注 X-CMD 项目,一起探索现代化命令行工具的无限可能!
---
# How Large Language Models Work: From Transformer to GPT
- Canonical: https://www.zeroxin.xin/en/large-language-models-principles/
- Markdown: https://www.zeroxin.xin/en/large-language-models-principles.md
- Published: 2025-11-08T00:00:00+08:00
- Updated: 2026-07-13T22:31:31+08:00
- Language: en
- Categories: AI
- Tags: Deep Learning, Large Language Models, Transformer, Artificial Intelligence
Starting from the Transformer attention mechanism, this article breaks down the architecture and evolution of large language models, covering the core principles of the GPT series, their training methodology, and the und
## Introduction
Large Language Models (LLMs) have become one of the most revolutionary technologies in AI. From ChatGPT to GPT-4, these models show astonishing language understanding and generation abilities. But have you ever wondered what core principles power them? This article breaks down the technical architecture of large language models, from the foundational Transformer mechanism to the evolution of modern GPT models.
## The Transformer Architecture: A Revolutionary Breakthrough
### Limitations of Traditional Methods
Before the Transformer, natural language processing relied mainly on Recurrent Neural Networks (RNNs) and Long Short-Term Memory networks (LSTMs). Although effective, these approaches had two key problems:
1. **Sequential computation limits**: text must be processed in order, preventing parallelization
2. **Long-range dependency problem**: hard to capture relationships between words far apart in the text
### The Birth of the Attention Mechanism
In 2017, a Google team published the landmark paper *Attention Is All You Need*, proposing the Transformer architecture built entirely on attention. Its core idea is exactly that: **"attention is all you need."**
#### How Self-Attention Works
Self-Attention is the core innovation of the Transformer. Consider this example:
> "The animal didn't cross the street because it was too tired."
When the model processes the word "it," self-attention lets it focus on "animal" rather than "street." That is the magic of attention — it lets the model understand semantic relationships between words.
**The concrete computation steps:**
1. **Generate Q, K, V vectors**: each input word produces Query, Key, and Value vectors through three different weight matrices
2. **Compute attention scores**: relevance scores come from the dot product of Q and K vectors
3. **Normalize**: a softmax function turns the scores into a probability distribution
4. **Weighted sum**: the attention scores weight the V vectors to produce the final representation
```python
# Simplified self-attention computation
def self_attention(Q, K, V):
scores = torch.matmul(Q, K.transpose(-2, -1)) / sqrt(d_k)
attention_weights = softmax(scores, dim=-1)
return torch.matmul(attention_weights, V)
```
### Multi-Head Attention: Multiple Perspectives
A single attention mechanism may only capture certain features of the text. To solve this, the Transformer introduces **Multi-Head Attention**:
- The input is split into multiple "heads," each learning a different attention pattern
- Some heads may attend to grammatical relationships, others to semantic associations
- The results of all heads are concatenated to form a richer representation
It's like having several people read the same article from different angles, then combining everyone's understanding.
### Positional Encoding: Ordering the Words
Since the Transformer itself carries no positional information, we use **Positional Encoding** to tell the model the order of words:
```python
# Positional encoding formulas
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
```
This encoding lets the model distinguish the same word at different positions and understand the sequential nature of language.
## The Complete Transformer Architecture
### Encoder-Decoder Structure
The original Transformer uses an encoder-decoder architecture:
**Encoder:**
- Multi-head self-attention layer
- Position-wise feed-forward network
- Residual connections and layer normalization
**Decoder:**
- Masked multi-head self-attention (prevents seeing future information)
- Encoder-decoder attention
- Position-wise feed-forward network
### Residual Connections and Layer Normalization
To train deeper networks, the Transformer introduces two key techniques:
1. **Residual connections**: `Output = Layer(Input) + Input`
2. **Layer normalization**: stabilizes training and speeds up convergence
## From Transformer to GPT
### The Evolution of the GPT Series
**GPT-1 (2018):**
- Based on the Transformer decoder
- Unsupervised pre-training + supervised fine-tuning
- 117 million parameters
**GPT-2 (2019):**
- Parameters increased to 1.5 billion
- Demonstrated zero-shot learning ability
- Sparked wide debate about AI safety
**GPT-3 (2020):**
- 175 billion parameters
- Powerful few-shot and zero-shot capabilities
- Showed emergent abilities
**GPT-4 (2023):**
- Multimodal ability (text + image)
- Stronger reasoning and creativity
- Better safety and alignment
### Core Technical Innovations
#### 1. Scaling Laws
OpenAI found that model performance follows **scaling laws**:
- performance ∝ parameters^α × data^β × compute^γ
- bigger model + more data = better performance
#### 2. Instruction Tuning
By fine-tuning on instruction-formatted data, models learn to:
- Understand human instructions
- Follow specific formatting requirements
- Generate more helpful responses
#### 3. Reinforcement Learning from Human Feedback (RLHF)
This is the key to making models "helpful and harmless":
1. **Supervised fine-tuning**: train on high-quality dialogue data
2. **Reward model training**: learn human preferences
3. **Reinforcement learning optimization**: optimize the policy with the PPO algorithm
## How Large Language Models Work
### Pre-training: Acquiring Language Knowledge
Self-supervised learning on large-scale text data:
```python
# Language modeling objective
def language_model_loss(logits, targets):
return cross_entropy(logits, targets)
```
By predicting the next word, the model learns:
- Grammar rules
- Semantic knowledge
- Reasoning ability
- World knowledge
### Inference: Generating Text
When generating new text, the model works in an **autoregressive** manner:
1. **Encode input**: convert the prompt into a vector representation
2. **Generate word by word**: predict one token at a time
3. **Decoding strategy**: greedy search, beam search, or sampling
```python
# Text generation example
def generate_text(model, prompt, max_length=100):
input_ids = tokenize(prompt)
for _ in range(max_length):
outputs = model(input_ids)
next_token = sample(outputs.logits[:, -1, :])
input_ids = torch.cat([input_ids, next_token], dim=-1)
return decode(input_ids)
```
## Capabilities and Limitations
### Emergent Abilities
Once a model reaches a certain scale, surprising abilities emerge:
- **In-context learning**: learning new tasks from examples
- **Chain-of-thought reasoning**: solving complex problems step by step
- **Code generation**: writing and debugging programs
- **Multilingual translation**: cross-language understanding
### Current Limitations
Despite their power, LLMs still have:
- **Hallucination**: generating plausible-looking but incorrect information
- **Reasoning limits**: still weak on complex logical reasoning
- **Knowledge staleness**: cannot fetch new information in real time
- **Computational cost**: training and inference are expensive
## Future Directions
### Technical Trends
1. **Multimodal fusion**: unified understanding of text, image, audio, and video
2. **Efficiency optimization**: model compression, quantization, and distillation
3. **Better alignment**: stronger value alignment and safety guarantees
4. **Enhanced reasoning**: combining symbolic and neural reasoning
### Application Prospects
- **Scientific research**: accelerating discovery and hypothesis testing
- **Education**: personalized learning assistants
- **Creative work**: writing, design, and programming assistance
- **Human-AI collaboration**: augmenting human ability rather than replacing it
## Conclusion
Large language models represent an important milestone in the development of AI. From the Transformer's self-attention to GPT's scaling, we have witnessed the enormous potential of deep learning. Understanding these principles not only helps us use them better but also points the way for future AI development.
As *Attention Is All You Need* showed, sometimes the simplest idea is the most powerful. The attention mechanism not only transformed natural language processing — it opened a new path toward general artificial intelligence.
The future is here, and understanding the principles is our first step in grasping it.
---
## References
1. Vaswani, A., et al. (2017). [Attention Is All You Need](https://arxiv.org/abs/1706.03762)
2. Alammar, J. (2018). [The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/)
3. OpenAI Research. [GPT model research](https://openai.com/research/)
4. Brown, T., et al. (2020). [Language Models are Few-Shot Learners](https://arxiv.org/abs/2005.14165)
---
*This article is compiled from publicly available research and technical documentation to help readers understand the core principles of large language models. Corrections are welcome.*
---
# 深度解析大语言模型原理:从Transformer到GPT的演进之路
- Canonical: https://www.zeroxin.xin/2025/11/08/large-language-models-principles/
- Markdown: https://www.zeroxin.xin/2025/11/08/large-language-models-principles.md
- Published: 2025-11-08T00:00:00+08:00
- Updated: 2026-07-13T22:34:06+08:00
- Language: zh-CN
- Tags: 人工智能, Transformer, 深度学习, 大语言模型
从Transformer注意力机制出发,深入剖析大语言模型的技术架构与演进历程,系统介绍GPT系列模型的核心原理、训练方法论以及自然语言理解的底层逻辑基础,帮助读者建立对现代AI语言模型的全面技术认知,把握人工智能发展的前沿方向与趋势
## 引言
大语言模型(Large Language Models, LLMs)已经成为人工智能领域最具革命性的技术之一。从ChatGPT到GPT-4,这些模型展现出了令人惊叹的语言理解和生成能力。但你是否想过,这些模型背后的核心原理是什么?本文将深入剖析大语言模型的技术架构,从基础的Transformer机制到现代GPT模型的演进历程。
## Transformer架构:革命性的突破
### 传统方法的局限性
在Transformer出现之前,自然语言处理主要依赖循环神经网络(RNN)和长短期记忆网络(LSTM)。这些方法虽然有效,但存在两个关键问题:
1. **顺序计算限制**:必须按顺序处理文本,无法并行化
2. **长距离依赖问题**:难以捕捉文本中相距较远的词语关系
### 注意力机制的诞生
2017年,Google团队发表了里程碑式的论文《Attention Is All You Need》,提出了完全基于注意力机制的Transformer架构。这篇论文的核心思想是:**"注意力就是你所需要的一切"**。
#### 自注意力机制的工作原理
自注意力(Self-Attention)是Transformer的核心创新。让我们通过一个例子来理解:
> "The animal didn't cross the street because it was too tired."
当模型处理单词"it"时,自注意力机制允许它关注到"animal",而不是"street"。这就是注意力机制的魔力——让模型能够理解词语之间的语义关系。
**具体计算步骤**:
1. **生成Q、K、V向量**:每个输入词通过三个不同的权重矩阵生成查询(Query)、键(Key)、值(Value)向量
2. **计算注意力分数**:通过Q向量和K向量的点积计算相关性分数
3. **归一化处理**:使用softmax函数将分数转换为概率分布
4. **加权求和**:用注意力分数对V向量进行加权求和,得到最终表示
```python
# 简化的自注意力计算
def self_attention(Q, K, V):
scores = torch.matmul(Q, K.transpose(-2, -1)) / sqrt(d_k)
attention_weights = softmax(scores, dim=-1)
return torch.matmul(attention_weights, V)
```
### 多头注意力:多视角理解
单一注意力机制可能只关注到文本的某些特征。为了解决这个问题,Transformer引入了**多头注意力(Multi-Head Attention)**:
- 将输入分成多个"头",每个头学习不同的注意力模式
- 有的头可能关注语法关系,有的关注语义关联
- 最后将所有头的结果拼接,形成更丰富的表示
这就像让多个人从不同角度阅读同一篇文章,然后综合所有人的理解。
### 位置编码:给词语排序
由于Transformer本身不包含位置信息,我们需要通过**位置编码(Positional Encoding)**来告诉模型词语的顺序:
```python
# 位置编码公式
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
```
这种编码方式让模型能够区分不同位置的相同词语,理解语言的顺序性。
## Transformer的完整架构
### 编码器-解码器结构
原始Transformer采用编码器-解码器架构:
**编码器**:
- 多头自注意力层
- 位置前馈网络
- 残差连接和层归一化
**解码器**:
- 掩码多头自注意力(防止看到未来信息)
- 编码器-解码器注意力
- 位置前馈网络
### 残差连接和层归一化
为了训练更深的网络,Transformer引入了两个关键技术:
1. **残差连接**:`Output = Layer(Input) + Input`
2. **层归一化**:稳定训练过程,加速收敛
## 从Transformer到GPT的演进
### GPT系列的发展历程
**GPT-1 (2018)**:
- 基于Transformer解码器
- 使用无监督预训练+有监督微调
- 参数量1.17亿
**GPT-2 (2019)**:
- 参数量提升到15亿
- 展现出零样本学习能力
- 引发了关于AI安全的广泛讨论
**GPT-3 (2020)**:
- 参数量达到1750亿
- 强大的少样本和零样本能力
- 展现出涌现能力
**GPT-4 (2023)**:
- 多模态能力(文本+图像)
- 更强的推理和创造能力
- 更好的安全性和对齐
### 核心技术创新
#### 1. 规模扩展定律
OpenAI发现,模型的性能遵循**规模扩展定律**:
- 性能 ∝ 参数量^α × 数据量^β × 计算量^γ
- 更大的模型 + 更多数据 = 更好的性能
#### 2. 指令微调(Instruction Tuning)
通过在指令格式的数据上微调,模型学会了:
- 理解人类指令
- 遵循特定格式要求
- 生成更有用的回复
#### 3. 人类反馈强化学习(RLHF)
这是让模型变得"有用且无害"的关键:
1. **监督微调**:在高质量对话数据上训练
2. **奖励模型训练**:学习人类偏好
3. **强化学习优化**:使用PPO算法优化策略
## 大语言模型的工作原理
### 预训练:语言知识的获取
在大规模文本数据上进行自监督学习:
```python
# 语言建模目标
def language_model_loss(logits, targets):
return cross_entropy(logits, targets)
```
模型通过预测下一个词来学习:
- 语法规则
- 语义知识
- 推理能力
- 世界知识
### 推理过程:生成文本
生成新文本时,模型采用**自回归**方式:
1. **编码输入**:将提示转换为向量表示
2. **逐词生成**:每次预测一个词
3. **解码策略**:贪婪搜索、束搜索或采样
```python
# 文本生成示例
def generate_text(model, prompt, max_length=100):
input_ids = tokenize(prompt)
for _ in range(max_length):
outputs = model(input_ids)
next_token = sample(outputs.logits[:, -1, :])
input_ids = torch.cat([input_ids, next_token], dim=-1)
return decode(input_ids)
```
## 大语言模型的能力与局限
### 涌现能力
当模型规模达到一定程度时,会涌现出令人惊讶的能力:
- **上下文学习**:从示例中学习新任务
- **思维链推理**:逐步解决复杂问题
- **代码生成**:编写和调试程序
- **多语言翻译**:跨语言理解
### 当前局限
尽管能力强大,大语言模型仍存在:
- **幻觉问题**:生成看似合理但错误的信息
- **推理边界**:在复杂逻辑推理上仍有不足
- **知识更新**:无法实时获取新信息
- **计算成本**:训练和推理成本高昂
## 未来发展方向
### 技术趋势
1. **多模态融合**:文本、图像、音频、视频的统一理解
2. **效率优化**:模型压缩、量化、蒸馏技术
3. **对齐改进**:更好的价值观对齐和安全保障
4. **推理增强**:结合符号推理和神经推理
### 应用前景
- **科学研究**:加速科学发现和假设验证
- **教育培训**:个性化学习助手
- **创意工作**:写作、设计、编程辅助
- **人机协作**:增强人类能力而非替代
## 结语
大语言模型代表了人工智能发展的重要里程碑。从Transformer的自注意力机制到GPT的规模扩展,我们见证了深度学习的巨大潜力。理解这些模型的原理不仅有助于我们更好地使用它们,也为未来的AI发展指明了方向。
正如《Attention Is All You Need》论文所展示的,有时候最简单的想法反而最强大。注意力机制不仅改变了自然语言处理,更开启了通向通用人工智能的新路径。
未来已来,而理解原理是我们把握未来的第一步。
---
## 参考资料
1. Vaswani, A., et al. (2017). [Attention Is All You Need](https://arxiv.org/abs/1706.03762)
2. Alammar, J. (2018). [The Illustrated Transformer](https://jalammar.github.io/illustrated-transformer/)
3. OpenAI Research. [GPT系列模型研究](https://openai.com/research/)
4. Brown, T., et al. (2020). [Language Models are Few-Shot Learners](https://arxiv.org/abs/2005.14165)
---
*本文基于公开的研究资料和技术文档整理,旨在帮助读者深入理解大语言模型的核心原理。如有错误或疏漏,欢迎指正。*
---
# Google Antigravity IDE:重新定义开发体验的创新工具
- Canonical: https://www.zeroxin.xin/2025/01/08/google-antigravity-ide-introduction/
- Markdown: https://www.zeroxin.xin/2025/01/08/google-antigravity-ide-introduction.md
- Published: 2025-01-08T00:00:00+08:00
- Updated: 2026-06-18T17:19:20+08:00
- Language: zh-CN
- Tags: Google, IDE, 开发工具, Web开发, 前端技术
Google Antigravity IDE是Google基于Angular框架推出的下一代Web集成开发环境,采用纯浏览器架构实现云端开发体验。本文深入分析其技术栈、用户界面设计理念、代码编辑功能以及它如何重新定义现代软件开发方式,展望云端编程的未来趋势
在快速发展的软件开发领域,Google再次推出了一款令人瞩目的开发工具——Google Antigravity IDE。这款以"Build the new way"为口号的集成开发环境,正试图通过创新的方式改变我们编写、测试和部署代码的方式。
## 什么是Google Antigravity[url: https://antigravity.google/]
Google Antigravity是Google最新推出的Web集成开发环境,它代表了Google对下一代开发工具的探索和尝试。从其官方网站(antigravity.google)可以看出,这是一个基于现代Web技术构建的开发平台,采用了Angular框架作为其核心技术栈。
## 核心特性
### 1. 现代Web架构
Google Antigravity采用了纯Web架构,这意味着开发者可以直接在浏览器中进行开发工作,无需安装复杂的本地环境。这种基于云的开发方式提供了极大的灵活性和可访问性,开发者可以从任何设备、任何地点访问他们的开发环境。
### 2. 简洁的用户界面
从页面结构分析,Antigravity IDE采用了极简的设计理念,界面清爽直观。它使用了Google Sans字体家族,包括Google Sans Code专门用于代码显示,提供了优秀的阅读体验。
### 3. 集成化开发体验
作为一个完整的IDE,Antigravity预计将提供代码编辑、调试、版本控制、部署等一体化功能。虽然目前公开的信息有限,但从Google在开发者工具领域的历史来看,我们可以期待它将集成Google Cloud Platform、Firebase等服务的深度支持。
## 技术架构
### 前端技术栈
- **框架**:基于Angular构建的单页应用(SPA)
- **字体**:使用Google Sans、Google Sans Code、Inter和Roboto字体家族
- **样式**:采用现代CSS模块化设计
- **分析**:集成Google Tag Manager进行用户行为分析
### 后端服务
虽然具体细节尚未公开,但可以推测Antigravity将利用Google强大的云基础设施,提供:
- 实时协作功能
- 云端代码存储
- 自动化构建和部署
- 智能代码补全和建议
## 与传统IDE的对比
| 特性 | 传统IDE | Google Antigravity |
|------|---------|-------------------|
| 安装需求 | 需要本地安装 | 无需安装,浏览器访问 |
| 资源消耗 | 占用本地系统资源 | 依赖云端计算资源 |
| 协作能力 | 有限或需要额外工具 | 原生支持实时协作 |
| 跨平台性 | 受操作系统限制 | 完全跨平台 |
| 更新方式 | 手动更新 | 自动更新 |
## 潜在优势
1. **降低入门门槛**:无需复杂的本地环境配置,新手开发者可以更快上手
2. **团队协作**:基于云的架构天然支持多人协作开发
3. **资源弹性**:根据项目需求动态分配计算资源
4. **无缝集成**:与Google生态系统(如Firebase、Google Cloud)深度集成
5. **AI辅助**:可能集成Google的AI技术,提供智能代码建议和错误检测
## 可能的挑战
1. **网络依赖**:完全依赖网络连接,离线开发能力可能受限
2. **性能问题**:对于大型项目,Web IDE的性能可能不如本地IDE
3. **自定义限制**:相比本地IDE,自定义和扩展能力可能受限
4. **数据安全**:企业用户可能对代码存储在云端存在顾虑
## 适合的使用场景
- **教育和培训**:降低学习门槛,适合编程教学
- **快速原型开发**:快速验证想法和概念
- **远程团队协作**:支持分布式团队开发
- **小型项目**:中小型项目的开发和维护
- **演示和展示**:实时代码演示和技术分享
## 未来展望
Google Antigravity IDE代表了开发工具向云端、Web化发展的趋势。随着Web技术的不断进步和浏览器能力的增强,基于Web的开发环境将越来越强大。Google此举可能是为了:
1. 探索下一代开发工具的形态
2. 加强其云服务生态系统的整合
3. 降低开发门槛,扩大开发者群体
4. 为AI辅助编程提供更好的平台
## 结语
虽然Google Antigravity IDE目前还处于早期阶段,很多细节尚未公开,但它无疑代表了开发工具领域的一个重要发展方向。随着更多信息的披露和功能的完善,它有可能成为改变开发者工作方式的重要工具。
对于开发者而言,保持对这类新工具的关注和尝试,将有助于把握技术发展的脉搏,提升开发效率和体验。我们期待看到Google Antigravity IDE的进一步发展,以及它将如何影响整个开发工具生态系统。
---
*本文基于目前公开的信息进行分析,随着Google Antigravity IDE的发展,部分内容可能会有所变化。*


